재귀적 자기개선(RSI)이란? AI가 스스로 더 나아진다는 연구의 의미와 한계
재귀적 자기개선(RSI)은 AI가 자기 다음 버전을 스스로 개선하는 루프예요. Sakana AI MASS와 RSI-Anything 논문으로 실제 개선된 것과 한계를 2026년 10월 기준으로 정리해요.
목차7개 섹션
핵심 요약
- 재귀적 자기개선(RSI)은 AI가 개선된 자신을 다시 개선 도구로 쓰는 반복 루프를 뜻하며, 지능 폭발 논의의 출발점이에요.
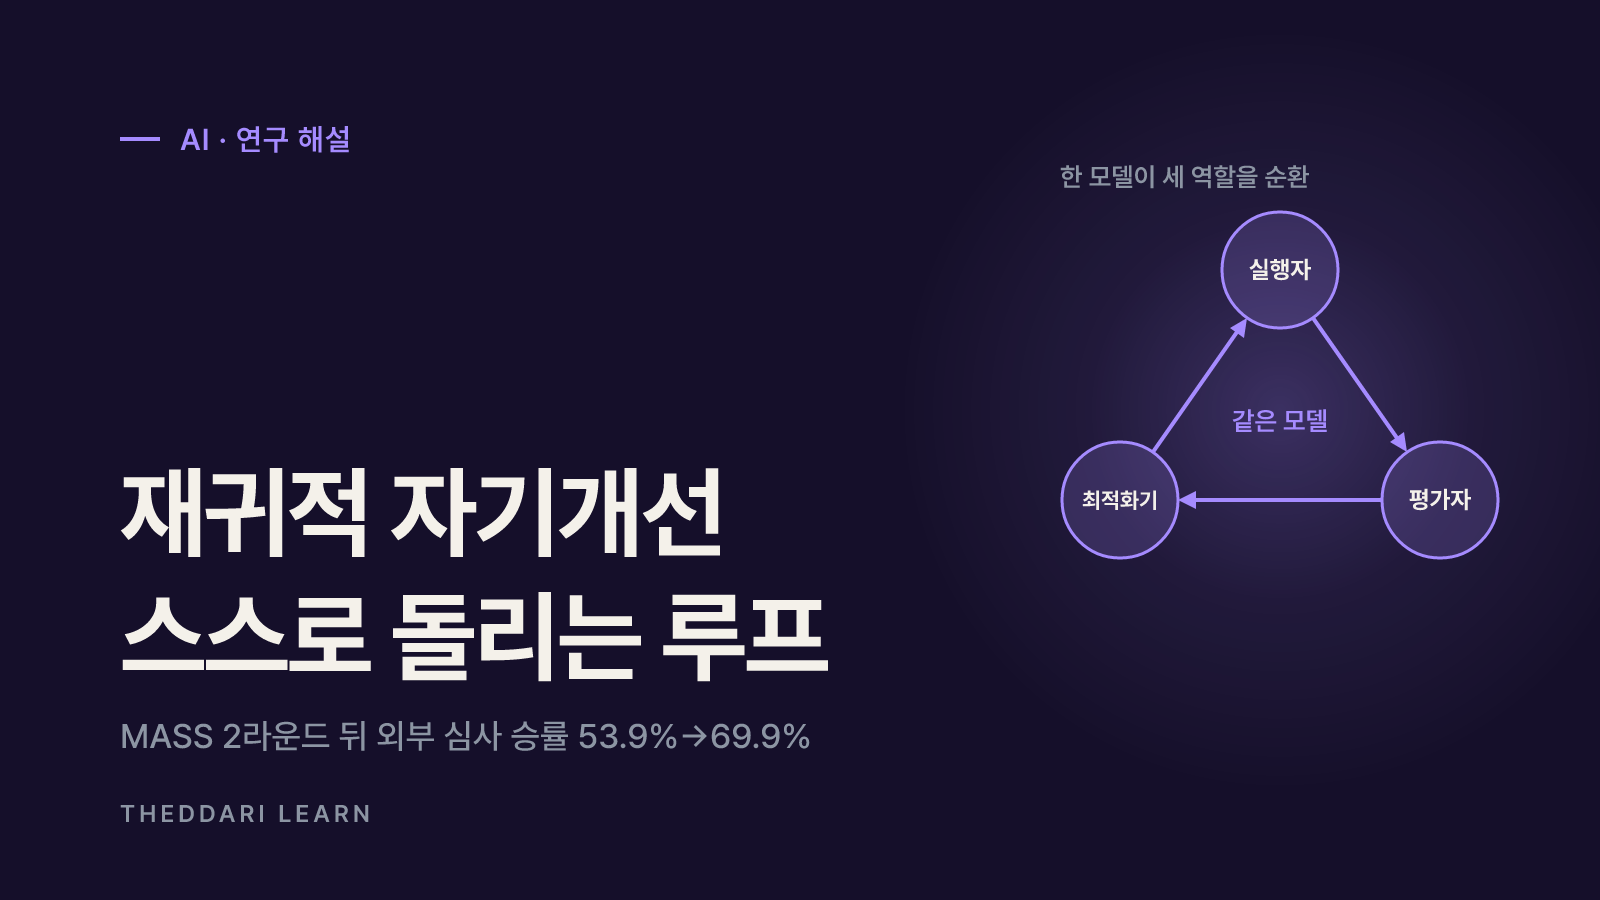
- Sakana AI·UC 버클리의 MASS는 같은 모델이 실행자·최적화기·평가자를 모두 맡아 2라운드 후 외부 심사 승률을 기준 모델 대비 69.9%까지 올렸어요.
- RSI-Anything은 월드 모델로 행동과 학습 데이터를 고르게 해 코드 수리 성공률을 26.3%에서 31.2%로 높였다고 보고해요.
- 개선 폭은 과제에 따라 고르지 않아요. MASS는 SWE-bench Verified에서 토큰당 점수가 0.94배로 오히려 낮았어요.
- 가장 큰 위험은 같은 모델이 만들고 평가하는 구조에서 생기는 공유 맹점이며, 두 논문 모두 아직 동료 심사 전 프리프린트예요.
재귀적 자기개선(RSI, Recursive Self-Improvement)은 AI가 자기 성능을 높이고, 그렇게 좋아진 AI가 다시 다음 개선을 맡는 반복 루프를 말해요. 2026년 10월 기준 공개된 연구가 보여준 것은 '스스로 무한히 똑똑해지는 AI'가 아니라, 사람이 설계한 틀 안에서 특정 과제의 점수가 몇 라운드에 걸쳐 오른 사례예요. 이 글은 2026년 10월 8~9일 arXiv에 올라온 두 논문, Sakana AI·UC 버클리의 MASS와 RSI-Anything의 원문 수치를 기준으로 무엇이 실제로 개선됐는지와 어디까지가 과장인지 나눠 설명해요.
재귀적 자기개선(RSI) 뜻과 기본 원리
위키백과 RSI 항목은 RSI를 'AI 시스템이 더 유능한 후속 시스템을 반복적으로 설계하는 과정'으로 정의하고, 이것이 지능 폭발과 초지능으로 이어질 수 있다는 가설을 함께 소개해요. 핵심은 '재귀'라는 단어예요. 한 번 좋아지고 끝나는 것이 아니라, 개선된 결과물이 다음 개선의 도구가 되어 같은 과정이 계속 돌아간다는 뜻이에요.
실제 연구에서는 이 루프를 몇 가지 역할로 쪼개서 봐요. 문제를 푸는 실행자(optimizee), 푸는 방식을 바꾸는 최적화기(optimizer), 결과가 나아졌는지 판단하는 평가자(evaluator)예요. 세 역할을 모두 같은 모델이 맡으면 MASS 논문이 말하는 '동종(homogeneous) RSI'가 돼요. 사람이 정답을 주지 않아도 루프가 돈다는 장점이 있지만, 평가자가 틀리면 틀린 방향으로 계속 강화될 수 있다는 약점도 함께 생겨요.
실행자
- 하는 일
- 과제를 실제로 수행해 결과물을 만듦
- 틀렸을 때 생기는 문제
- 결과물 품질 저하
최적화기
- 하는 일
- 피드백을 받아 작업 방식·워크플로를 수정
- 틀렸을 때 생기는 문제
- 좋은 피드백을 받아도 개선하지 못함
평가자
- 하는 일
- 두 결과물 중 더 나은 쪽을 고름
- 틀렸을 때 생기는 문제
- 잘못된 결과를 '개선'으로 학습 데이터에 넣음
이미 있던 비슷한 사례: AlphaEvolve
Google DeepMind는 2025년 5월 14일 AlphaEvolve를 공개하며 이 시스템이 찾은 커널 분할 방식으로 Gemini 아키텍처의 핵심 커널을 23% 빠르게 해 학습 시간을 1% 줄였다고 밝혔어요. AlphaEvolve 자신의 기반 모델 학습에도 쓰였다는 점에서 RSI 논의에 자주 등장하지만, 자동 평가기가 답을 검증할 수 있는 수학·컴퓨팅 문제에 강하다는 전제가 붙어요. 정답 판정 규칙이 없는 연구·글쓰기 같은 과제에서는 이 방식을 그대로 쓰기 어려워요.
Sakana AI MASS: 팀의 집단 지성으로 스스로 학습하기
MASS(Multi-Agent Self-Supervision)는 정답 규칙이 없는 '검증 불가능한' 연구 과제에서 RSI를 시도해요. 같은 모델이 여러 에이전트 팀을 꾸려 일하고, 그 팀의 가장 좋은 작업 기록을 다시 자기 학습 데이터로 쓰는 구조예요.
- 1
내부 루프: 워크플로 탐색
모델 가중치는 고정한 채, 오케스트레이터와 하위 에이전트의 역할·지시·계약(넘겨줄 결과물)·호출 순서를 담은 워크플로를 바꿔 가며 실행해요. 평가자가 현재 최고안보다 낫다고 판단하면 새 챔피언이 돼요.
- 2
외부 루프: 최고 팀의 기록으로 학습
과제마다 챔피언 워크플로를 18번 실행하고, 현재 모델이 결과물을 순위 매겨 최대 16개 궤적(학습 15·검증 1)을 남겨요. 워크플로 문구를 지운 채 LoRA로 미세조정해 모델이 작업 조직법 자체를 익히게 해요.
- 3
반복
업데이트된 모델이 다시 실행자·최적화기·평가자를 모두 맡아 다음 라운드를 돌려요.
Sakana AI 공개 글에 따르면 Qwen3.6-27B로 2라운드를 돌린 결과, 학습에 쓰지 않은 평가 과제 3개에서 기준 모델 대비 외부 심사 승률이 1라운드 53.9%, 2라운드 69.9%였어요. 진척 측정에는 GPT-5.5와 Claude Opus 4.8을 외부 심사자로 썼고, 이 판단은 학습 루프에 넣지 않았어요. 공개 벤치마크에서는 MLR-Bench·DSBench·ScienceAgentBench·AstaBench에서 출력 토큰당 점수가 기준의 1.2~1.6배였어요.
MASS에서 눈여겨볼 관찰
- 역할 일반화: 과제 풀이 궤적만 학습했는데 최적화기와 평가자 능력도 좋아졌다고 보고해요. 평가자와 외부 심사의 일치율은 세 사이클에 걸쳐 73%에서 93%로 올랐어요.
- 병목은 평가자보다 최적화기: 평가자만 GPT-5.5로 바꾸면 12개 과제 중 10개에서 이기는 워크플로를 찾았고, 평가자·최적화기를 모두 바꾸면 5번째 반복 안에 12개 모두 찾았어요. 같은 모델만 쓴 루프는 13번째 반복까지 11개였어요.
- 멀티 에이전트 궤적의 효율: 멀티 에이전트 기록으로 학습한 모델이 2,880만 학습 토큰으로 승률 68.3%를 냈고, 단일 에이전트 기록 모델은 4,200만 토큰으로 64.0%였어요.
RSI-Anything: 월드 모델로 무엇을 학습할지 고르기
RSI-Anything은 2026년 10월 9일 제출된 논문으로, 외부 피드백은 비싸고 정책이 바뀌면 월드 모델 예측도 틀려질 수 있다는 문제에서 출발해요. JEPA-Anything 기반 예측 월드 모델이 어떤 행동을 할지, 어떤 경험을 학습 데이터로 쓸지 고르고, 업데이트된 정책·모델 쌍은 구성 요소·호환성 검사를 통과해야만 유지돼요. 즉 '아무 변화나 남기지 않는' 장치를 루프에 넣은 셈이에요.
코드 수리(코더 고정)
- 비교 조건
- 정적 검증기 → 예측 선택 → 월드 모델 적응
- 보고된 결과
- 성공률 26.3% → 29.2% → 31.2%
GUI 조작
- 비교 조건
- 기존 방식 대비
- 보고된 결과
- 과제 완료율 상승, 평균 행동 수 39.4% 감소
실험실 계획
- 비교 조건
- 5개 정책 버전 연속 개선
- 보고된 결과
- 점수 21.80% → 46.01%
반응 최적화
- 비교 조건
- 같은 40회 실험 예산의 베이지안 최적화 대비
- 보고된 결과
- 평균 최고 수율 96.15% vs 82.16%
코드 수리 개선 폭은 약 5%포인트로, 극적인 도약보다는 데이터 선택을 똑똑하게 해서 얻은 꾸준한 이득에 가까워요. 실험실 계획 점수가 두 배 넘게 오른 것도 5개 버전에 걸친 결과이지 한 번에 일어난 일은 아니에요.
AI 자기개선 연구의 한계와 과장 구분하기
두 논문 모두 의미 있는 결과를 냈지만, 'AI가 스스로 진화하기 시작했다'는 해석으로 넘어가기 전에 다음을 확인해야 해요.
- 개선이 고르지 않아요. MASS는 Terminal-Bench 2.0에서 0.96배, SWE-bench Verified에서 0.94배로 학습 과제와 다른 분야에서는 오히려 낮았어요.
- 라운드 수가 짧아요. MASS는 2라운드, RSI-Anything은 5개 정책 버전까지만 보여줘요. 개선이 계속 쌓이는지, 어느 지점에서 멈추는지는 아직 알 수 없어요.
- 탐색이 불안정해요. MASS 저자들은 워크플로 탐색에서 좋은 반복 뒤에 급격한 성능 후퇴가 따라올 수 있다고 밝혔어요.
- 사람의 틀이 여전히 있어요. 과제 설계, 외부 심사 모델, 구조적 가드레일, 유지 검사는 모두 사람이 정했어요.
- 동료 심사 전이에요. 두 논문 모두 2026년 10월 기준 arXiv 프리프린트 v1이라 재현 결과에 따라 수치가 달라질 수 있어요.
MASS 저자들은 같은 모델이 만들고 평가하는 루프에서 공유 맹점이 RSI의 아킬레스건이 될 수 있다고 경고해요. 결함이 있는 결과가 개선으로 받아들여져 다음 모델에 흡수되고, 사람도 그 결함을 알아채기 어렵다면 반복할수록 결함이 강화될 수 있어요. 자기 생성 데이터 반복 학습이 모델 붕괴를 부를 수 있다는 비판도 같은 맥락이에요.
RSI 소식을 읽을 때 확인할 체크리스트
- 무엇이 개선됐나요? 모델 가중치인지, 프롬프트·워크플로인지, 데이터 선택 방식인지 구분해요.
- 누가 평가했나요? 자기 평가인지, 외부 모델·사람·자동 검증기인지 확인해요.
- 학습에 쓰지 않은 과제에서도 좋아졌나요? 학습 과제 점수만 있다면 일반화 근거가 약해요.
- 비용은 같았나요? 토큰·실험 횟수 같은 예산 조건을 맞췄는지 봐요.
- 몇 라운드였나요? 두세 번의 개선을 '무한 루프'로 일반화하지 않아요.
AI 연구 소식은 빠르게 퍼지고 과장도 함께 붙어요. 원문 링크가 붙은 흐름을 따라가려면 더따리의 AI 텔레그램 트렌드와 블로그 트렌드를 함께 보며 어떤 주장이 어디서 시작됐는지 비교해 보세요.

이 글은 2026년 10월 기준 공개된 논문·공식 글을 바탕으로 한 교육용 설명이며 투자 조언이 아닙니다. 연구 수치는 특정 실험 조건의 결과이므로, AI 관련 자산을 판단할 때는 최신 원문과 공식 자료를 직접 확인하고 스스로 결정하세요.