Inkling 2 Mini 로컬 실행: 노트북 메모리별 GGUF 양자화 고르는 법
Inkling 2 Mini를 노트북에서 돌리려면 메모리에 맞는 GGUF 양자화부터 골라야 해요. 화제가 된 5.4GB 실행 사례의 조건과 16·24·32GB별 선택, 언센서드 변환본 위험을 정리했어요.
목차9개 섹션
핵심 요약
- Inkling 2 Mini는 총 26.4B·활성 3.4B 파라미터의 루프형 MoE 모델이며, 공식 체크포인트(약 20GB)는 32GB 이상 메모리를 권장해요.
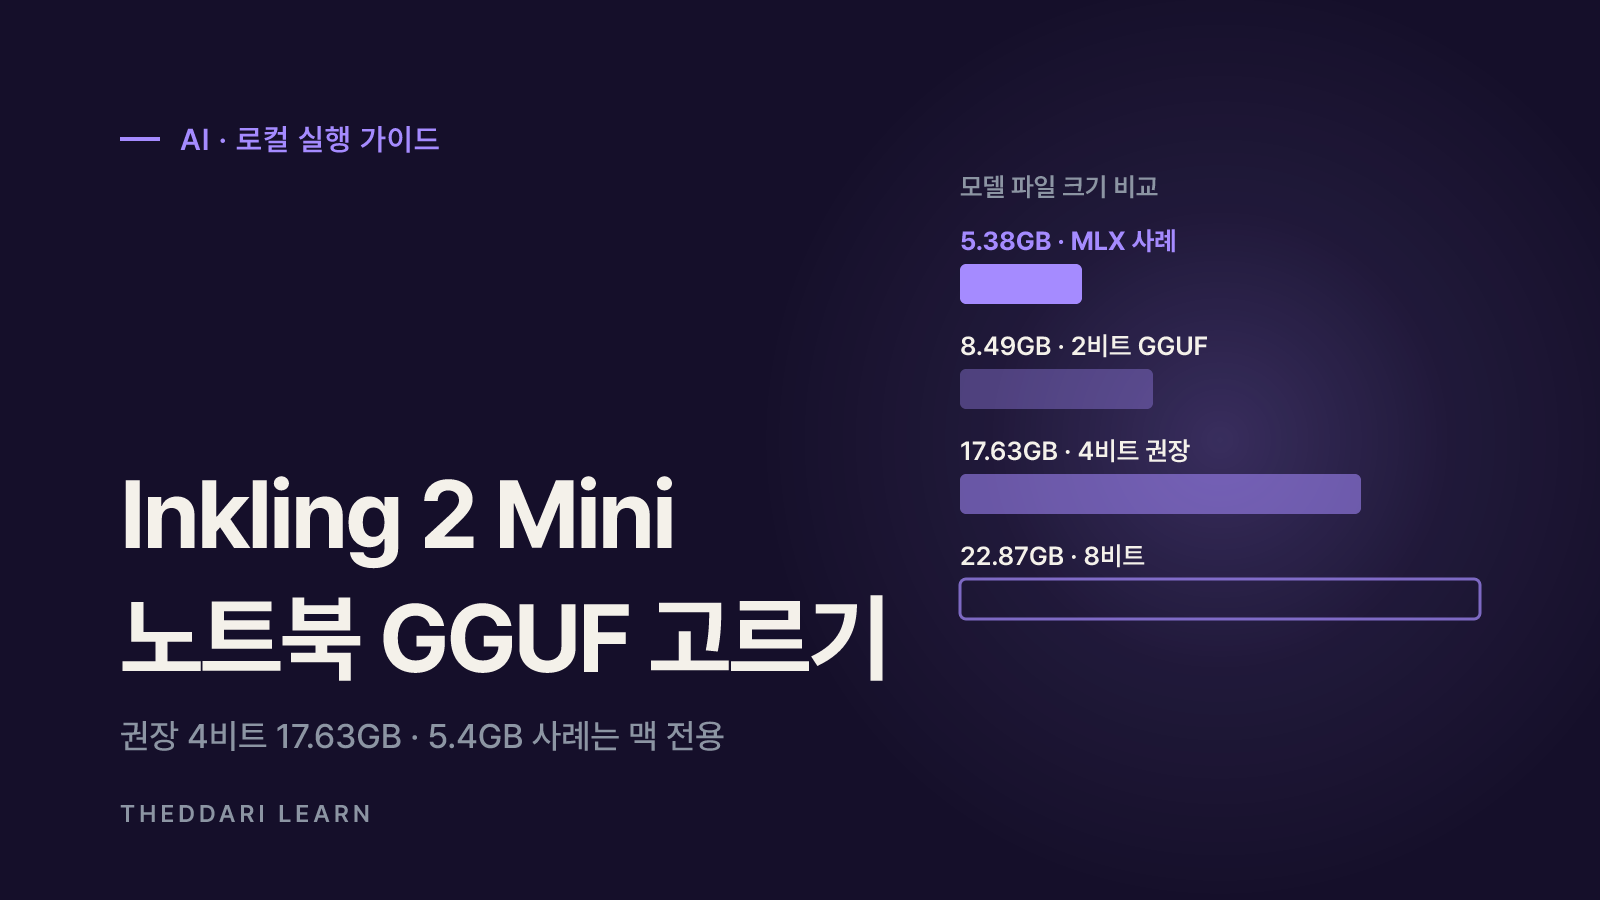
- GGUF 양자화 버전은 Unsloth 기준 7.76GB(1비트)부터 22.87GB(8비트)까지 있고, 권장 버전은 17.63GB인 UD-Q4_K_XL이에요.
- 해커뉴스에서 화제가 된 5.4GB 실행은 GGUF가 아니라 Apple Silicon 전용 MLX 빌드이며, 원본 대비 GSM8K·HumanEval 점수가 눈에 띄게 낮아요.
- 파일 크기 외에 컨텍스트 길이만큼 메모리가 더 들어요. llama.cpp 기준 8K는 약 1.3GB, 32K는 약 4.5GB가 추가로 필요하다는 추정이 있어요.
- 언센서드 변환본은 거절 동작을 제거한 비공식 수정본이에요. 품질 저하와 사용 책임을 확인하고, 에이전트 작업은 샌드박스에서 돌려야 해요.
Inkling 2 Mini 로컬 실행의 핵심은 내 노트북 메모리에 맞는 GGUF 양자화 버전을 고르는 거예요. 공식 체크포인트는 약 20GB라 32GB 이상 메모리를 권장하지만, 4비트 GGUF(약 16~18GB)라면 24GB급, 2~3비트라면 16GB급 노트북에서도 실행할 수 있어요. 해커뉴스에서 화제가 된 '5.4GB 실행'은 Apple Silicon 전용 MLX 빌드라서 일반 GGUF와는 조건이 달라요. 이 글은 2026년 11월 22일 기준으로 공식 모델 카드와 Unsloth·Atomic Chat 배포 페이지, 해당 사례 저장소를 직접 확인해 정리했어요. 모델 자체의 특징과 Inkling 2 Small과의 차이는 기존 소개 글을 참고하고, 여기서는 실제로 노트북에서 돌리는 방법에 집중해요.
Inkling 2 Mini 로컬 실행 전에 알아둘 구조
공식 모델 카드에 따르면 Inkling 2 Mini는 Thinking Machines Lab이 2026년 11월 20일 Apache 2.0 라이선스로 공개한 멀티모달 모델이에요. 텍스트와 이미지를 입력받아 텍스트를 내놓고, 컨텍스트는 최대 1M 토큰이에요. 총 파라미터는 26.4B, 토큰당 활성 파라미터는 3.4B인 MoE(전문가 혼합) 구조이고, 레이어마다 128개 전문가 중 8개를 골라 써요.
특이한 점은 루프형 트랜스포머라는 거예요. 24개 레이어 중 가운데 12개를 같은 가중치로 세 번 반복 실행해서 토큰 하나가 48번의 레이어 연산을 거쳐요. 모델 카드는 반복 한 번마다 약 1.0B의 유효 활성 파라미터가 더해져 토큰당 유효 활성 파라미터가 5.4B라고 설명해요. 여기서 헷갈리기 쉬운 점이 있어요. '5.4B'는 연산량을 뜻하는 파라미터 수이고, 화제가 된 '5.4GB'는 압축한 파일·메모리 크기예요. 숫자가 같을 뿐 서로 다른 개념이에요.
공식 권장 사양은 32GB 이상 메모리의 Apple Silicon 맥 또는 32GB 이상 VRAM의 GPU, NVIDIA DGX Spark 1대예요. 원본 가중치는 NVFP4·MXFP8 혼합 정밀도의 약 20GB 단일 체크포인트로 배포돼요. 이보다 적은 메모리에서 돌리려면 커뮤니티가 만든 양자화 버전을 써야 해요.
MoE 구조라서 토큰마다 일부 전문가만 읽지만, 가중치 전체는 메모리 어딘가에 있어야 해요. 그래서 활성 파라미터가 작다고 메모리 요구량까지 작아지지는 않아요. 반면 일부 전문가 레이어를 시스템 RAM으로 내려도 밀집(dense) 모델보다 속도 손해가 적은 편이라, VRAM이 조금 모자란 노트북에서는 이 점을 활용할 수 있어요.
GGUF 양자화 버전 비교: 크기와 품질 차이
GGUF는 llama.cpp 계열 앱(LM Studio, Ollama, Jan 등)에서 쓰는 모델 파일 형식이에요. 같은 모델이라도 가중치를 몇 비트로 줄였는지에 따라 여러 버전이 올라와요. 비트가 낮을수록 파일이 작아지지만 원본과 다른 답을 낼 가능성이 커져요. 품질 지표로는 보통 두 가지를 봐요. KLD(KL 발산)는 원본의 출력 분포와 얼마나 다른지를 나타내며 낮을수록 좋고, '같은 다음 토큰 일치율'은 원본과 같은 다음 단어를 고른 비율이에요.
Unsloth GGUF 저장소가 공개한 측정값은 아래와 같아요. 기준은 Unsloth의 UD-Q8_K_XL(22.87GB)이에요.
UD-IQ1_S
- 비트
- 1비트
- 파일 크기
- 7.76GB
- 같은 다음 토큰 일치율
- 89.4%
UD-IQ2_XXS
- 비트
- 2비트
- 파일 크기
- 8.49GB
- 같은 다음 토큰 일치율
- 90.6%
UD-Q2_K_XL
- 비트
- 2비트
- 파일 크기
- 9.14GB
- 같은 다음 토큰 일치율
- 91.6%
UD-IQ3_XXS
- 비트
- 3비트
- 파일 크기
- 11.66GB
- 같은 다음 토큰 일치율
- 94.7%
UD-Q3_K_XL
- 비트
- 3비트
- 파일 크기
- 13.63GB
- 같은 다음 토큰 일치율
- 96.3%
UD-Q4_K_M
- 비트
- 4비트
- 파일 크기
- 16.61GB
- 같은 다음 토큰 일치율
- 97.9%
UD-Q4_K_XL
- 비트
- 4비트
- 파일 크기
- 17.63GB
- 같은 다음 토큰 일치율
- 98.0%
UD-Q8_K_XL
- 비트
- 8비트
- 파일 크기
- 22.87GB
- 같은 다음 토큰 일치율
- 기준
표를 보면 4비트에서 3비트로 내려갈 때보다 3비트에서 2비트로 내려갈 때 일치율이 더 크게 떨어져요. Unsloth 실행 가이드는 UD-Q4_K_XL을 권장 버전으로 꼽고, 필요한 메모리(RAM+VRAM 또는 통합 메모리)를 1비트 9GB, 2비트 10~11GB, 3비트 13~15GB, 4비트 17~18GB, 8비트 24GB로 제시해요. 이미지 입력을 쓰려면 비전 프로젝터 파일(mmproj-F16.gguf)이 639MB 더 필요해요.
Atomic Chat도 6.88GB부터 27.74GB까지 14개 GGUF를 공개했어요. Atomic Chat 가이드의 표에서 4비트 AD-Q4_K는 16.53GB에 일치율 96.3%, 3비트 AD-IQ3_S는 13.34GB에 94.2%, 2비트 AD-IQ2_M은 8.67GB에 85.7%예요. 다만 Unsloth와 Atomic Chat은 기준 모델과 측정 문서가 달라서 두 표의 숫자를 바로 비교하면 안 돼요. 같은 배포처 안에서 버전끼리 비교하는 용도로 쓰세요.
노트북 메모리별로 GGUF 고르는 법
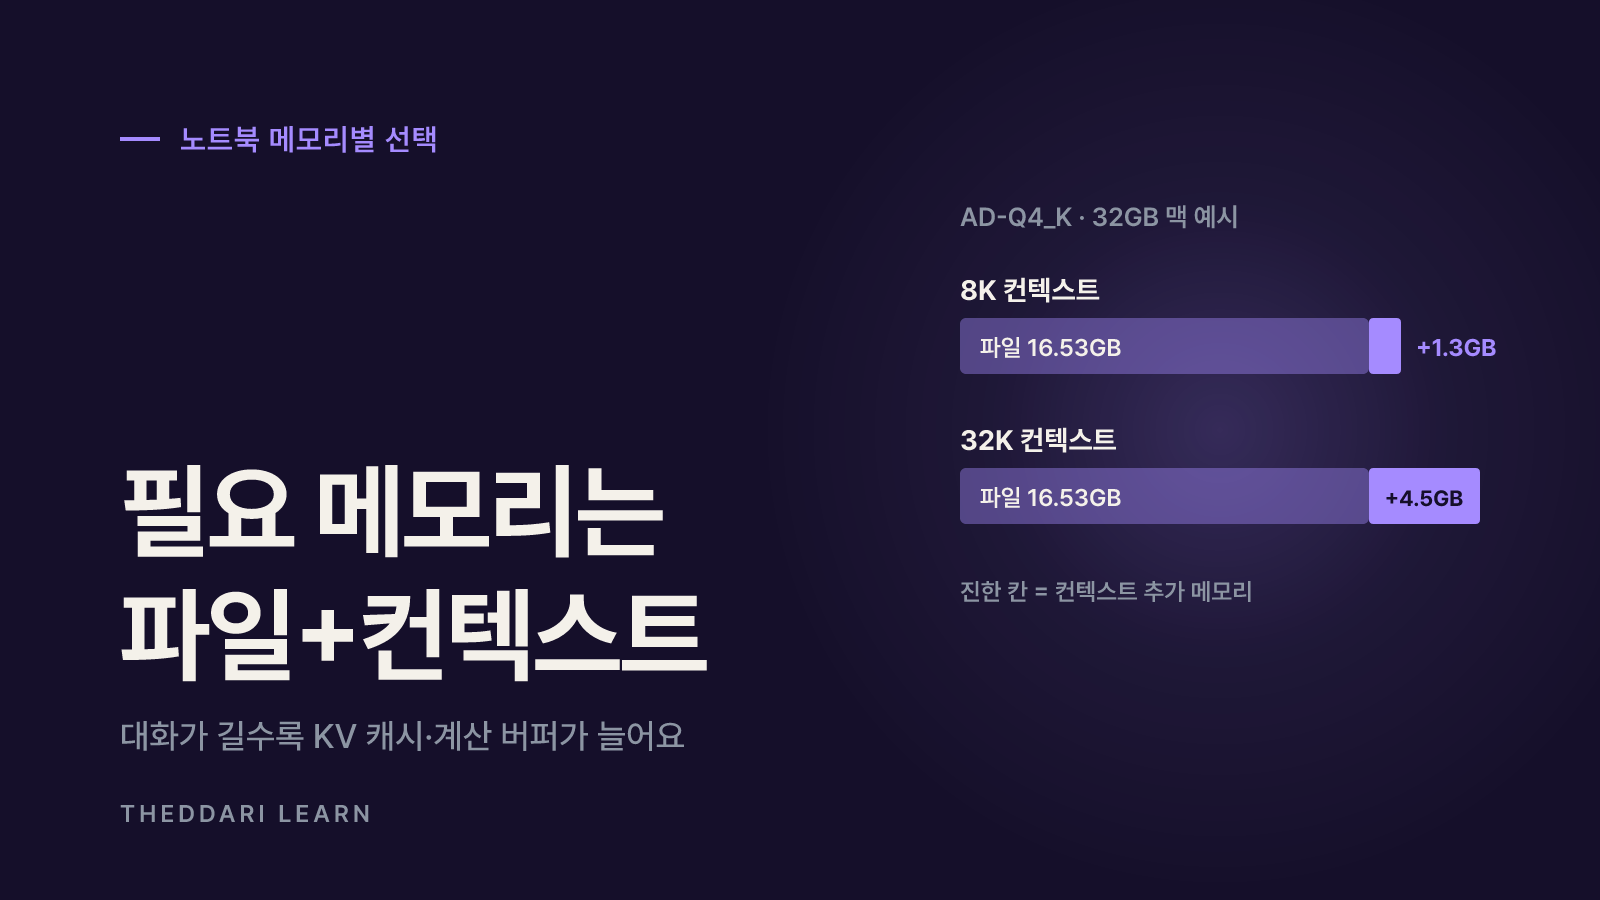
파일 크기만 보고 고르면 실행 중에 메모리가 모자랄 수 있어요. 대화가 길어질수록 KV 캐시와 계산 버퍼가 추가로 메모리를 쓰기 때문이에요. Atomic Chat은 이 모델이 레이어 6개 중 5개에 1,024토큰 슬라이딩 윈도를 써서 캐시가 일반 모델보다 작다고 설명하면서도, llama.cpp 기본 설정에서 계산 버퍼까지 합치면 8K 컨텍스트에 약 1.3GB, 32K에 약 4.5GB, 128K에 약 17GB가 더 든다고 추정해요.
맥은 한 가지를 더 고려해야 해요. Atomic Chat에 따르면 32GB 이하 맥에서는 macOS가 통합 메모리의 약 3분의 2만 GPU에 내줘요. 16GB 맥이라도 모델에 쓸 수 있는 공간은 10GB 남짓이라는 뜻이에요. 이를 반영한 Atomic Chat의 권장 조합은 다음과 같아요.
16GB 맥
- 권장 예시(Atomic Chat)
- AD-IQ2_M
- 파일 크기
- 8.67GB
- 남는 컨텍스트
- 약 8K
24GB 맥
- 권장 예시(Atomic Chat)
- AD-IQ3_S
- 파일 크기
- 13.34GB
- 남는 컨텍스트
- 약 8K
32GB 맥
- 권장 예시(Atomic Chat)
- AD-Q4_K
- 파일 크기
- 16.53GB
- 남는 컨텍스트
- 약 32K
16GB VRAM GPU 노트북
- 권장 예시(Atomic Chat)
- AD-IQ3_S
- 파일 크기
- 13.34GB
- 남는 컨텍스트
- 약 8K
8GB VRAM GPU 노트북
- 권장 예시(Atomic Chat)
- AD-IQ1_S
- 파일 크기
- 6.88GB
- 남는 컨텍스트
- 짧은 컨텍스트, 일부 레이어 CPU
- 이웃한 두 버전 중 고민되면 큰 쪽을 고르는 게 낫다는 게 Atomic Chat의 조언이에요. 특히 12GB 아래에서 품질이 빠르게 떨어져요.
- 컨텍스트는 8K로 시작하고 필요할 때 늘리세요. llama.cpp에서는 -c로 컨텍스트를 명시하고, 메모리가 모자라면 -ub 256으로 계산 버퍼를 절반으로 줄일 수 있어요(프롬프트 처리 속도는 느려져요).
- GPU 메모리가 조금 모자라면 --n-cpu-moe 옵션으로 앞쪽 레이어의 전문가 가중치를 시스템 RAM에 둘 수 있어요. 숫자를 조금씩 올리며 모델이 열리는 지점을 찾으면 돼요.
- 브라우저·IDE·메신저가 쓰는 메모리도 빼고 계산하세요. 표의 값은 다른 앱이 거의 없을 때를 기준으로 한 추정이에요.
화제가 된 5.4GB 실행 사례, 어떻게 읽을까
해커뉴스에서 공유된 LookAtMyQuant 저장소는 텐서마다 압축 손상을 측정해 비트를 배분하는 양자화 컴파일러예요. 개발자는 Inkling 2 Mini의 텍스트 가중치 18.89GB를 5.38GB(가중치당 1.65비트), 8.87GB, 11.18GB, 12.76GB의 네 가지 Apple Silicon용 MLX 빌드로 압축했다고 밝혔어요. 아래 점수는 모두 개발자가 직접 측정해 공개한 값이에요.
원본 BF16
- 텍스트 가중치
- 18.89GB
- GSM8K(200문항)
- 193개(96.5%)
- HumanEval(164문항)
- 152개(92.7%)
12.8GB 빌드
- 텍스트 가중치
- 12.76GB
- GSM8K(200문항)
- 193개(96.5%)
- HumanEval(164문항)
- 152개(92.7%)
8.9GB 빌드
- 텍스트 가중치
- 8.87GB
- GSM8K(200문항)
- 192개(96.0%)
- HumanEval(164문항)
- 149개(90.9%)
5.4GB 빌드
- 텍스트 가중치
- 5.38GB
- GSM8K(200문항)
- 176개(88.0%)
- HumanEval(164문항)
- 116개(70.7%)
읽을 때 확인할 점이 몇 가지 있어요. 첫째, 5.4GB 빌드는 수학(GSM8K)에서 원본보다 17문항, 코딩(HumanEval)에서 36문항을 덜 풀었어요. 코딩 비서로 쓰려면 이 손실이 커요. 둘째, 속도·메모리 측정은 Apple M5 Max에서 나온 값으로, 5.4GB 빌드의 활성 RAM은 5.98GB, 직렬 생성 속도는 초당 75.3토큰이었어요. 일반 노트북에서는 다르게 나올 수 있어요. 셋째, 이 파일들은 GGUF가 아니라 저장소의 lamq 런타임으로 돌리는 MLX 형식이라 윈도우·리눅스나 일반 GGUF 앱에서는 쓸 수 없어요. 넷째, 637MB 크기의 비전 타워는 별도라서 이미지 입력까지 쓰면 메모리가 더 들어요.
정리하면 이 사례는 '16GB 이하 맥에서도 텍스트 대화는 돌릴 수 있다'는 가능성을 보여 주지만, 원본 수준의 품질을 기대하기는 어려워요. 같은 저장소의 8.87GB 빌드가 원본에 훨씬 가까운 점수를 보였으니, 메모리가 허락한다면 한 단계 큰 빌드를 먼저 고려하세요. 결과는 아직 제3자가 독립적으로 재현한 값이 아니라는 점도 기억해 두세요.
실행 도구와 버전 호환성 확인하기
출시 직후라 실행 도구 지원이 빠르게 바뀌고 있어요. 공식 모델 카드도 루프형 모델의 로컬 런타임 지원은 새것이라 속도가 런타임과 하드웨어에 따라 다르다고 적고 있어요. 아래 순서로 확인하면 시행착오를 줄일 수 있어요.
- 1
런타임 버전 확인
Atomic Chat에 따르면 공식 llama.cpp는 출시일인 11월 20일 b12600 릴리스부터 Inkling 2 Mini를 지원해요. 그보다 오래된 llama.cpp를 내장한 앱은 모델을 불러오지 못할 수 있어요.
- 2
파일 구조 맞추기
Unsloth 저장소 루트의 GGUF는 Unsloth 전용 루프 레이아웃이라 Unsloth Desktop이나 Unsloth가 배포한 llama.cpp 빌드(b12588-mix-c0c3de8)로 열어요. 공식 llama.cpp를 쓴다면 Mainline_Support 폴더의 파일과 안내문을 따라요.
- 3
메타데이터 점검
다른 저장소 파일을 받기 전에 허깅페이스에서 general.architecture가 inkling2_loop이고 block_count가 24인지 확인해요. block_count 48인 파일은 초기 PR #32695 방식이라 최신 llama.cpp에서 열리지 않아요.
- 4
앱 고르기
맥에서는 Ollama의 inkling-2-mini(약 20GB NVFP4, MLX 엔진)도 선택지지만 32GB급 맥이 필요해요. LM Studio·Jan은 GGUF를 불러올 수 있고, 처음이라면 Unsloth Desktop처럼 버전 관리를 대신해 주는 앱이 편해요.
- 5
설정 제한 걸기
모델 카드는 긴 추론 루프에 빠질 수 있다며 출력 토큰과 에이전트 턴 수에 상한을 두라고 권해요. Unsloth는 temperature 1.0, top-p 1.0, top-k 0, min-p 0.0을 권장 값으로 제시해요.
새 모델 소식과 실행 팁은 커뮤니티에서 먼저 돌 때가 많아요. 더따리 AI 텔레그램 트렌드에서 최근 언급이 늘어난 모델과 이슈를 확인하고, 실제 적용 전에는 위 원문 페이지로 다시 검증하세요.

언센서드 변환본과 라이선스, 쓰기 전 위험
허깅페이스 트렌딩에는 'Uncensored' 변환본도 함께 올라왔어요. AtomicChat의 언센서드 GGUF는 각 레이어의 거절 방향을 제거하는 rank-1 LoRA를 적용한 비공식 수정본이에요. 저장소의 측정에 따르면 유해 요청 거절이 0건이 됐고, MMLU 2,000문항 점수는 80.65%에서 79.15%로 1.5%p 낮아졌어요. 개발자 스스로 두 가지 품질 기준을 통과하지 못했다고 밝히며, 원본이 거절하는 요청에도 답하므로 사용 책임은 이용자에게 있다고 적었어요.
- 공식 가중치는 Apache 2.0이라 상업적 사용·수정·재배포가 가능하지만, Thinking Machines Lab의 모델 이용 정책(Acceptable Use Policy)도 함께 확인해야 해요.
- 변환본은 저장소마다 LICENSE 파일과 추가 조건이 다를 수 있어요. 회사 업무에 쓴다면 내부 보안·법무 기준과 맞는지 먼저 확인하세요.
- 공식 모델 카드는 이 모델이 도구를 쓸 때 확인 없이 파일을 지우거나 덮어쓸 수 있다고 경고해요. 코딩 에이전트에 연결한다면 샌드박스에서 실행하고 되돌릴 수 없는 작업은 승인을 받도록 설정하세요.
- 영어 외 언어에서는 출력 품질이 낮을 수 있다고 모델 카드에 적혀 있어요. 한국어 업무에 쓰기 전 자체 테스트가 필요해요.
- 출처가 불분명한 개인 저장소의 GGUF는 내용 검증이 어려워요. 다운로드 수, 측정 자료 공개 여부, 원본 모델 표기를 확인하세요.
로컬 LLM 실행기와 양자화 기법에 대한 블로그 글이 계속 올라오고 있어요. 더따리 블로그 트렌드에서 관련 글 흐름을 살펴보면 새 버전이나 호환성 이슈를 빨리 알아챌 수 있어요.
정리: 내 노트북에서 시작하는 순서
- 노트북의 메모리를 확인해요. 맥이라면 GPU에 쓸 수 있는 몫(32GB 이하는 약 3분의 2)으로 계산해요.
- 메모리에 맞는 GGUF 비트를 골라요. 여유가 있으면 4비트(약 16~18GB), 빠듯하면 3비트, 16GB 맥이라면 2비트를 기준으로 봐요.
- 배포처를 하나 정하고 그 저장소의 측정표 안에서 버전을 비교해요.
- 런타임 버전(llama.cpp b12600 이상 또는 배포처 안내 빌드)과 파일 구조를 맞춰요.
- 컨텍스트 8K, 출력 토큰 상한을 걸고 시작한 뒤 필요할 때 늘려요.
- 5.4GB MLX 빌드는 맥에서 텍스트 위주로 가볍게 쓸 때만 고려하고, 코딩·수학 품질 손실을 감안해요.
Inkling 2 Mini는 파라미터 수에 비해 메모리 효율이 좋은 편이지만, 양자화는 언제나 크기와 품질을 맞바꾸는 선택이에요. 내 작업에서 쓸 만한지는 같은 질문을 두세 버전에 던져 보고 직접 비교하는 게 가장 확실해요.
자주 묻는 질문
Inkling 2 Mini는 16GB 노트북에서도 돌아가나요?
5.4GB 버전을 받으면 GGUF처럼 LM Studio나 Ollama에서 쓸 수 있나요?
Q4_K_M과 Q4_K_XL처럼 비슷한 이름은 무엇이 다른가요?
Inkling 2 Mini를 상업적으로 써도 되나요?
llama.cpp에서 모델이 안 열리거나 이상한 글자만 나오면 어떻게 하나요?
출처·참고 자료
- 1thinkingmachines/Inkling-2-Mini 모델 카드 (Hugging Face)(새 탭에서 열림)huggingface.co
- 2unsloth/Inkling-2-Mini-GGUF (Hugging Face)(새 탭에서 열림)huggingface.co
- 3Unsloth: Inkling 2 Mini - Run Locally Guide(새 탭에서 열림)unsloth.ai
- 4ShinMegamiBoson/lookatmyquant (GitHub)(새 탭에서 열림)github.com
- 5Atomic Chat: How to Run Inkling 2 Mini Locally(새 탭에서 열림)atomic.chat
- 6AtomicChat/Inkling-2-Mini-Uncensored-GGUF (Hugging Face)(새 탭에서 열림)huggingface.co
관련 글
 AI
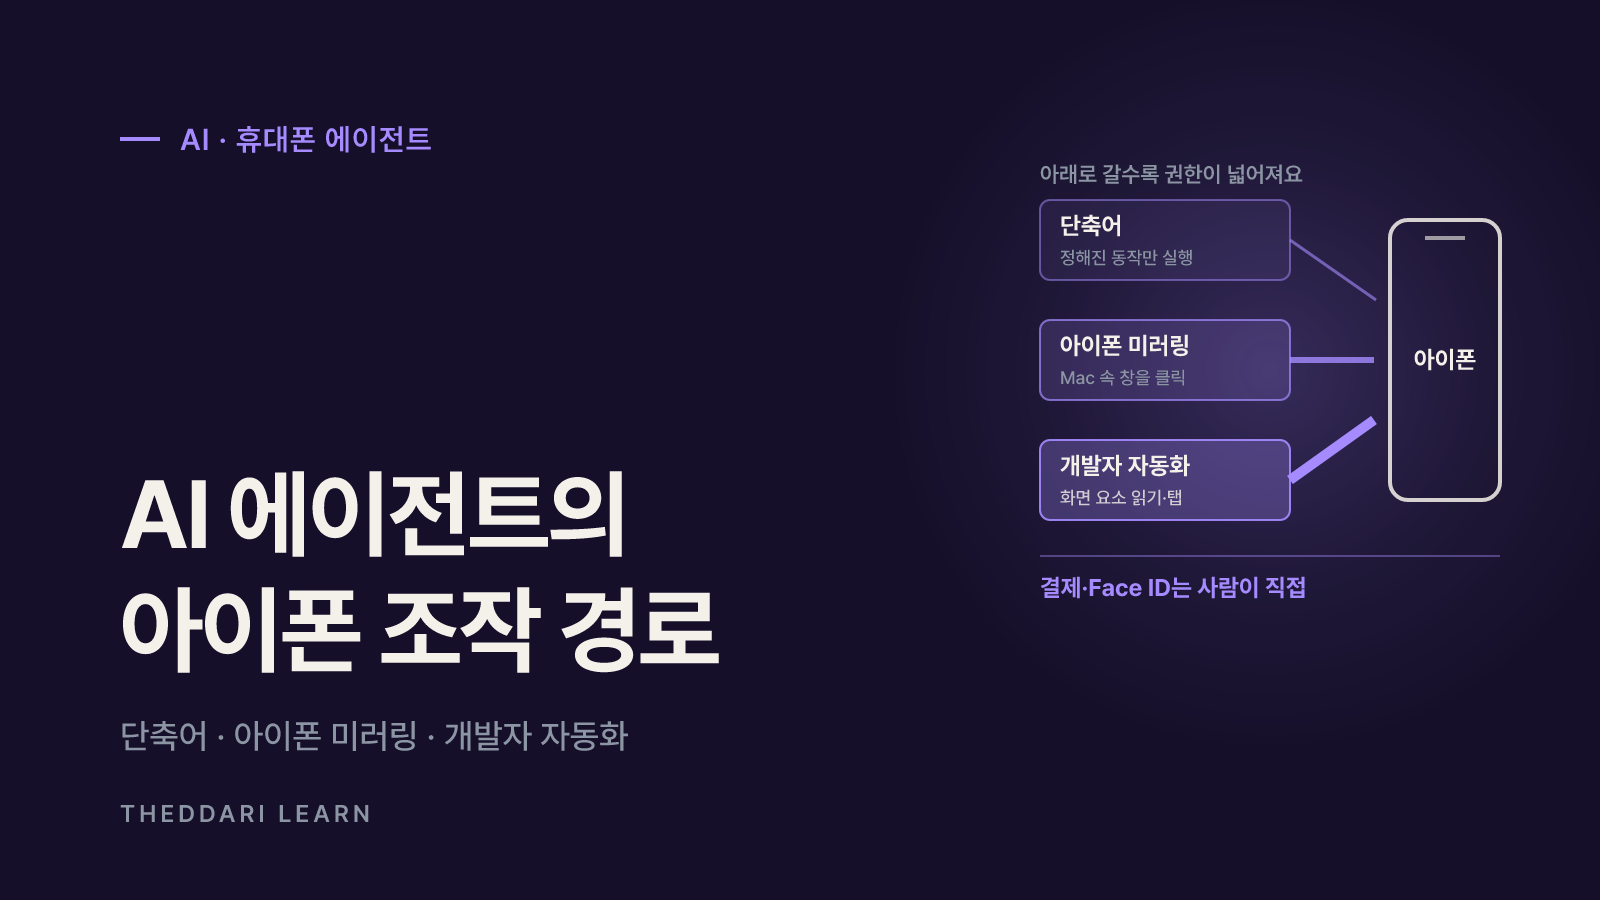
AI 에이전트 아이폰 조작 가능할까? 설정 방법과 권한·개인정보 주의점
AI 에이전트가 아이폰을 쓰게 하는 길은 단축어, 아이폰 미러링, 개발자 자동화 세 가지예요. 방식별 조건과 맡겨도 되는 일, 꼭 꺼 둘 권한을 정리했어요.
 AI
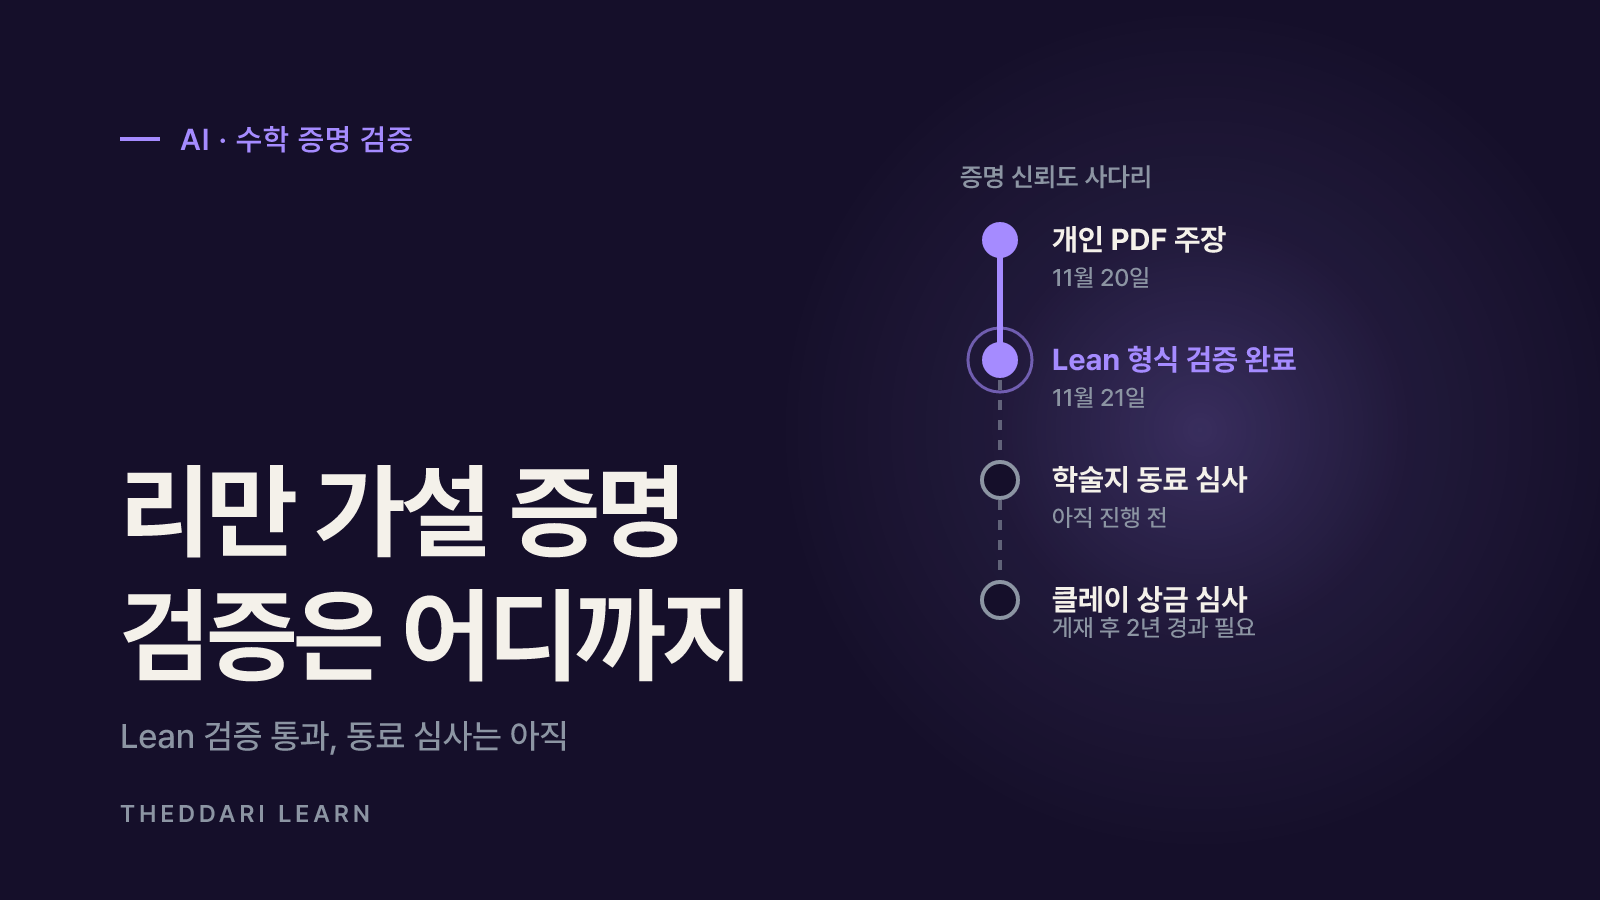
앤트로픽 리만 가설 증명, 사실일까? 수학 난제 증명 검증하는 법
2026년 11월 20일 앤트로픽 연구원 레벤트 알푀게가 Claude와 함께 리만 가설을 증명했다고 밝혔어요. 하루 만에 Lean 커뮤니티가 형식 검증을 인증했지만, 사람이 읽는 논문·동료 심사·클레이 상금 절차는 아직 남아 있어요. 증명 주장을 단계별로 확인하는 법을 정리했어요.
 AI
AI 에이전트 로봇 제어, 어디까지 됐나? AgentRoboCritic 연구 정리
GPT-6 Astra 같은 범용 AI 에이전트가 로봇 팔에 숫자 명령을 직접 내리면 무엇을 잘하고 어디서 막힐까요? 2026년 11월 공개된 AgentRoboCritic 논문의 핵심 수치와 해석 시 주의점을 정리했어요.