Qwen3.8-27B를 로컬에서 실행하려면? GGUF 양자화 버전별 파일 크기와 필요 사양
Qwen3.8-27B를 로컬에서 돌릴 때 Q4_K_M·Q6_K 같은 GGUF 양자화별 파일 크기와 VRAM, 컨텍스트 여유, llama.cpp 실행법과 품질 저하를 정리했어요.
목차7개 섹션
핵심 요약
- Qwen3.8-27B는 Apache-2.0 라이선스의 27B 밀집(dense) 비전-언어 모델이며, 공식 저장소는 BF16 safetensors만 제공하고 GGUF는 커뮤니티 양자화예요.
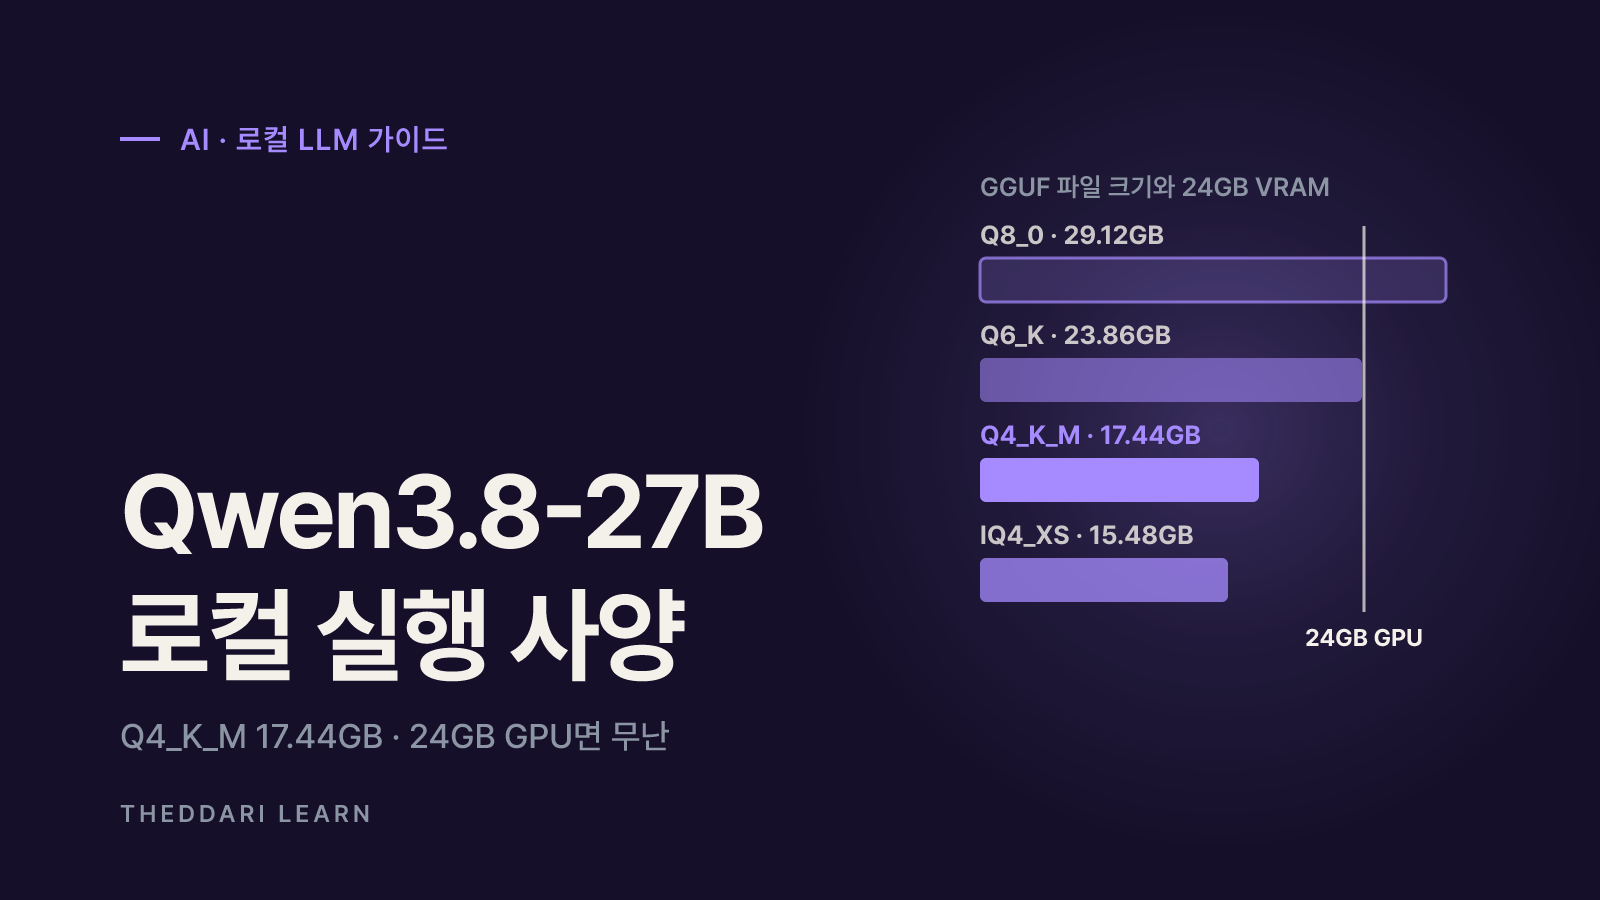
- bartowski GGUF 기준 Q4_K_M은 17.44GB, Q6_K는 23.86GB, Q8_0은 29.12GB예요. 파일이 VRAM보다 1~2GB 작아야 전부 GPU에 올릴 수 있어요.
- 24GB GPU에서는 Q4_K_M이 속도와 컨텍스트 여유의 균형점이고, 16GB GPU에서는 IQ4_XS처럼 더 작은 파일이 필요해요.
- Q4_K_M의 원본 대비 최상위 토큰 일치율은 95.0%, Q2_K는 83.5%로 3비트 이하에서 품질 저하가 커져요.
- llama.cpp는 qwen35 아키텍처를 아는 최신 빌드가 필요하고, 이미지 입력은 별도 mmproj 파일을 함께 불러와야 해요.
Qwen3.8-27B를 로컬에서 실행하려면 대부분의 개인 PC에서는 원본 BF16 가중치 대신 GGUF 양자화 버전을 llama.cpp 계열 도구로 불러오는 것이 현실적이에요. 2026년 10월 기준으로 가장 많이 쓰이는 4비트 Q4_K_M 파일은 약 17~18GB라서 24GB VRAM GPU 한 장이나 32GB 이상의 통합 메모리를 가진 Mac이 무난한 출발점이에요. 16GB GPU에서는 더 작은 양자화와 짧은 컨텍스트로 타협해야 해요. 이 글은 Qwen 공식 모델 카드와 Hugging Face에 공개된 커뮤니티 GGUF 저장소의 측정값을 바탕으로, 양자화 단계별 파일 크기와 품질 손실, 하드웨어별 선택 기준을 정리했어요. 수치는 업로더와 측정 환경마다 다르므로 실제 다운로드 전 해당 저장소를 다시 확인하세요.
Qwen3.8-27B는 어떤 모델인가요
Qwen3.8-27B는 알리바바 Qwen 팀이 2026년 8월 공개한 Qwen3.8 계열의 27B 밀집(dense) 모델이에요. 모델 카드에 따르면 이미지와 영상을 이해하는 네이티브 비전-언어 모델이고, 라이선스는 Apache-2.0이에요. 모든 파라미터가 매 토큰마다 계산에 참여하는 밀집 구조라서, 일부 전문가만 활성화되는 MoE 모델과 달리 파라미터 수가 곧 메모리와 연산 부담으로 이어져요. 기본적으로 답변 전에 생각 과정을 출력하는 thinking 모드가 켜져 있고, 요청마다 끄거나 reasoning_effort로 추론 깊이를 조절할 수 있어요.
로컬 실행에서 중요한 구조적 특징은 하이브리드 어텐션이에요. 64개 레이어가 16 × (Gated DeltaNet 3개 → Gated Attention 1개) 형태로 배치돼 있어서, 전체 어텐션 레이어는 16개뿐이고 나머지 48개는 선형 어텐션이에요. 선형 어텐션 레이어는 일반적인 KV 캐시를 쌓지 않으므로 같은 27B급 모델보다 긴 컨텍스트에 필요한 메모리가 작아요. 공식 문서상 기본 컨텍스트는 262,144토큰이고 YaRN 같은 RoPE 확장으로 최대 1,000,000토큰까지 늘릴 수 있다고 안내하지만, 개인 PC에서는 메모리 때문에 훨씬 짧게 쓰는 경우가 대부분이에요.
파라미터
- 모델 카드 기준 값
- 27B 밀집 (HF 표기 28B)
- 로컬 실행에서의 의미
- 양자화 없이 BF16이면 약 50GB급
레이어 구성
- 모델 카드 기준 값
- 64층, 전체 어텐션 16층
- 로컬 실행에서의 의미
- KV 캐시가 작아 긴 컨텍스트에 유리
기본 컨텍스트
- 모델 카드 기준 값
- 262,144토큰
- 로컬 실행에서의 의미
- 메모리가 허용하는 만큼만 실제 사용
입력
- 모델 카드 기준 값
- 텍스트·이미지·영상
- 로컬 실행에서의 의미
- GGUF에서는 mmproj 파일이 별도로 필요
라이선스
- 모델 카드 기준 값
- Apache-2.0
- 로컬 실행에서의 의미
- 상업적 이용 가능, 조건은 원문 확인
GGUF 양자화 버전별 파일 크기와 품질 차이
공식 저장소는 Transformers 형식의 BF16 safetensors를 제공하고, 서버용으로 SGLang·vLLM·TokenSpeed를 권장해요. GGUF 파일은 Qwen 팀이 아닌 커뮤니티가 만든 양자화 버전이며, 모델 카드의 모델 트리에는 2026년 10월 확인 시점에 1,438개의 양자화 모델이 연결돼 있었어요. 그중 널리 쓰이는 bartowski의 GGUF 저장소는 llama.cpp b10896 릴리스로 만들었고, 각 파일의 크기와 함께 원본(bf16) 대비 perplexity, KL divergence, 최상위 토큰 일치율을 공개해요.
Q8_0
- 파일 크기
- 29.12GB
- 원본과 최상위 토큰 일치율
- 98.7%
- 성격
- 원본에 가장 가까움, 32GB급 메모리 필요
Q6_K
- 파일 크기
- 23.86GB
- 원본과 최상위 토큰 일치율
- 97.4%
- 성격
- 품질 우선, 24GB GPU에서는 컨텍스트가 짧아짐
Q5_K_M
- 파일 크기
- 20.92GB
- 원본과 최상위 토큰 일치율
- 96.9%
- 성격
- 품질과 크기의 중간
Q4_K_M
- 파일 크기
- 17.44GB
- 원본과 최상위 토큰 일치율
- 95.0%
- 성격
- 업로더 기본 권장값
IQ4_XS
- 파일 크기
- 15.48GB
- 원본과 최상위 토큰 일치율
- 94.1%
- 성격
- 16GB급 GPU용 대안
Q3_K_M
- 파일 크기
- 13.40GB
- 원본과 최상위 토큰 일치율
- 89.8%
- 성격
- 품질 저하가 눈에 띄기 시작
Q2_K
- 파일 크기
- 10.82GB
- 원본과 최상위 토큰 일치율
- 83.5%
- 성격
- 실험용, 오류 증가
표의 일치율은 같은 문장에서 양자화 모델이 가장 가능성 높게 본 다음 토큰이 원본과 같은 비율이에요. wiki 텍스트 100청크에서 측정한 값이라 코딩, 수학, 한국어 대화 같은 실제 작업 품질을 그대로 대변하지는 않지만 단계별 손실의 경향을 보기에는 유용해요. 4비트까지는 손실이 완만하다가 3비트 이하에서 급격히 커지는 모습이 보여요. 또 파일 크기는 업로더마다 달라요. 같은 Q4_K_M이라도 다른 저장소는 15.4GiB나 17.77GB로 표기하는데, 이는 GB와 GiB 단위 차이, 다중 토큰 예측(MTP) 레이어 포함 여부, 레이어별 정밀도 배분 방식이 달라서 생겨요.
K-quant와 I-quant는 무엇이 다른가요
이름이 Q4_K_M처럼 생긴 것이 K-quant, IQ4_XS처럼 IQ로 시작하는 것이 I-quant예요. bartowski의 안내에 따르면 고민하기 싫다면 K-quant를 고르고, 4비트 미만이 필요하고 NVIDIA(cuBLAS)나 AMD(rocBLAS) GPU를 쓴다면 같은 크기에서 품질이 좋은 I-quant를 검토할 만해요. 다만 I-quant는 CPU에서 K-quant보다 느리고, RTX 3090 측정에서도 IQ4_XS가 Q4_K_M보다 9% 작지만 약 23% 느렸어요. 크기가 꼭 필요할 때 I-quant를 고르는 것이 좋아요.
Qwen3.8-27B 로컬 실행에 필요한 사양
필요 사양은 모델 파일 + KV 캐시 + 런타임 여유분의 합으로 생각하면 돼요. bartowski는 가장 빠른 실행을 원하면 GPU VRAM보다 1~2GB 작은 파일을, 최대 품질을 원하면 시스템 RAM과 VRAM 합계보다 1~2GB 작은 파일을 고르라고 안내해요. 일부 레이어를 CPU 메모리로 내리면 더 큰 파일도 실행되지만 생성 속도는 크게 떨어져요. KV 캐시는 대화가 길어질수록 커지는데, bowmanslayer 저장소의 계산으로는 f16 KV 캐시가 토큰당 64KiB라서 32K 컨텍스트에 약 2GiB, 128K에 약 8GiB가 들어요. KV 캐시를 8비트로 양자화하면 절반으로 줄어요.
GPU 24GB (RTX 3090·4090 등)
- 현실적인 선택
- Q4_K_M 또는 Q5_K_M
- 주의할 점
- Q6_K는 들어가지만 컨텍스트 여유가 작음
GPU 16GB
- 현실적인 선택
- IQ4_XS 또는 Q3 계열
- 주의할 점
- Q4_K_M은 KV 캐시 공간이 거의 없음
GPU 32GB 이상
- 현실적인 선택
- Q6_K~Q8_0
- 주의할 점
- Q8_0은 24GB에서 전체 적재 불가
Mac 통합 메모리 32GB
- 현실적인 선택
- Q5_K_M·Q6_K
- 주의할 점
- macOS 사용분을 빼고 계산
Mac 통합 메모리 64GB
- 현실적인 선택
- Q8_0
- 주의할 점
- MLX 빌드가 더 빠를 수 있음
CPU 전용
- 현실적인 선택
- Q4 계열 + 충분한 RAM
- 주의할 점
- 실행은 가능하지만 대화형으로는 느림
RTX 3090 한 장(24GB, Vulkan, 전체 GPU 적재)에서 bowmanslayer가 llama-fit-params로 측정한 최대 컨텍스트는 Q6_K 32,512토큰, Q5_K_M 73,472토큰, Q4_K_M 111,872토큰, IQ4_XS 133,632토큰이었어요. Q6_K에서 Q4_K_M으로 내리면 품질은 조금 잃지만 같은 카드에서 쓸 수 있는 컨텍스트가 약 3.4배 늘어난다는 뜻이에요. 생성 속도는 같은 조건에서 Q4_K_M이 초당 41.4토큰, Q6_K가 32.3토큰이었어요. 이 값은 한 사용자의 한 장비 측정이고 CUDA 빌드에서는 대체로 더 빠르다고 적혀 있으니 참고값으로만 보세요.
긴 문서 요약이나 코드베이스 분석처럼 컨텍스트가 긴 작업이 목적이라면, 파일을 한 단계 더 큰 양자화로 올리기보다 Q4_K_M을 유지하고 KV 캐시 여유를 확보하는 편이 실제로 쓸 수 있는 범위를 넓혀요.
llama.cpp로 실행하는 단계
- 1
최신 llama.cpp를 준비해요
Qwen3.8은 llama.cpp에서
qwen35아키텍처로 인식돼요. bowmanslayer 저장소는 b10502 이상, bartowski 파일은 b10896으로 만들어졌다고 안내해요. 오래된 빌드에서는tensor ... not found같은 로딩 오류가 날 수 있으니 공식 릴리스나 패키지 관리자로 최신 버전을 설치하세요. - 2
양자화 파일을 내려받아요
hf download명령으로 필요한 파일 하나만 받아요.llama-server -hf <저장소>:Q4_K_M처럼 저장소와 양자화 태그를 지정하면 다운로드와 실행을 한 번에 할 수도 있어요. 디스크 여유 공간은 파일 크기 이상으로 확보하세요. - 3
GPU 적재와 컨텍스트를 정해요
-ngl옵션으로 GPU에 올릴 레이어 수를,-c로 컨텍스트 길이를 지정해요. 처음에는 8K~32K 정도의 짧은 컨텍스트로 시작해 메모리 사용량을 확인한 뒤 늘리는 것이 안전해요. - 4
이미지 입력과 MTP는 선택해요
이미지를 넣으려면 같은 저장소의
mmproj파일을--mmproj로 함께 불러와요. MTP(다중 토큰 예측) 레이어를 이용한 추측 디코딩은--spec-type draft-mtp로 켜지만, 측정상 CUDA에서는 약 36% 빨라졌고 Vulkan은 약 3%, Apple Metal에서는 오히려 11% 느려졌어요. 백엔드별로 직접 비교하세요. - 5
권장 샘플링 값을 적용해요
공식 모델 카드는 thinking 모드에서 temperature 1.0, top_p 0.95, top_k 20을, 비 thinking 모드에서 temperature 0.7, top_p 0.80, presence_penalty 1.5를 권장해요. 프레임워크마다 지원 파라미터가 다르므로 적용 여부를 확인하세요.
llama-server는 기본적으로 http://localhost:8080 에서 웹 채팅 화면과 OpenAI 호환 API를 함께 제공해요. 그래서 코딩 에이전트나 자체 스크립트를 로컬 서버에 연결해 클라우드 API 대신 쓸 수 있어요. 다만 thinking 모드는 답변 전에 긴 추론 토큰을 생성하므로, 같은 질문이라도 생성 시간이 길어지고 컨텍스트를 빨리 소모해요. 빠른 응답이 필요하면 thinking을 끄거나 추론 강도를 낮추는 설정을 비교해 보세요. 모델 카드도 다단계 에이전트 작업에서는 추론 강도를 낮춘다고 전체 완료 시간이 꼭 줄지는 않는다고 설명해요.
로컬 실행 전에 알아둘 위험과 한계
- 비공식 파일: GGUF는 커뮤니티가 만든 파일이에요. 원본 모델 커밋, 사용한 llama.cpp 버전, 측정 방법을 공개한 저장소를 고르고, 미세조정·검열 해제 등 원본과 다른 파생 모델인지 이름과 설명을 확인하세요.
- 벤치마크 해석: 모델 카드의 점수는 BF16 원본과 특정 평가 하네스 기준이에요. 양자화 버전에서 같은 점수가 나온다고 가정하지 마세요.
- 발열과 전력: 27B 모델을 장시간 돌리면 GPU가 계속 고부하 상태가 돼요. 노트북에서는 발열로 속도가 떨어질 수 있어요.
- 보안: 로컬 서버를 외부 네트워크에 열면 누구나 모델을 호출할 수 있어요. 기본은 로컬 주소로만 띄우세요.
- 라이선스: Apache-2.0이라도 파생 모델은 별도 조건을 붙일 수 있으니 각 저장소의 라이선스를 확인하세요.
새 오픈 모델이 나오면 커뮤니티 양자화와 실행 팁이 며칠 사이에 빠르게 쌓여요. 더따리 AI 텔레그램 트렌드에서는 개발자 채널에서 어떤 모델과 도구가 함께 언급되는지 흐름을 볼 수 있고, 블로그 트렌드에서는 국내 사용자 후기 키워드를 확인할 수 있어요. 다만 이런 언급량은 관심도를 보여 줄 뿐 특정 파일의 품질이나 안전성을 보증하지는 않으니, 실제 선택은 저장소의 측정 자료와 본인 테스트로 판단하세요.

이 가이드는 2026년 10월 기준 공개 자료를 바탕으로 AI가 작성한 일반 정보이며 투자 조언이 아닙니다. 특정 하드웨어 구매나 모델 사용을 권유하지 않아요. 파일 크기·호환성·라이선스는 바뀔 수 있으니 실행 전 모델 카드와 각 저장소의 최신 안내를 확인하세요.