Qwen-Image 2.1 Turbo란? 8단계 오픈 이미지 생성 모델 특징과 GGUF 양자화 버전 주의점
Qwen-Image 2.1 Turbo는 8단계로 이미지를 만드는 Qwen의 가속 체크포인트예요. 연구용 라이선스, GGUF 양자화 단계별 화질 차이, 검열 해제 파생본의 실제 변경 범위를 정리했어요.
목차7개 섹션
핵심 요약
- Qwen-Image 2.1 Turbo는 Qwen-Image-2.1과 같은 7B 이미지 생성 구조를 8번의 디노이징 단계로 돌리도록 가속한 공식 체크포인트예요.
- 가중치는 공개돼 있지만 Qwen Research License라서 연구·평가 목적만 허용되고 상업적 이용은 별도 라이선스가 필요해요.
- GGUF 파일은 디노이저만 담고 있어서 Qwen3-VL-8B 텍스트 인코더와 VAE를 따로 받아야 하고, 전용 8단계 시그마 스케줄을 맞추지 않으면 결과가 달라져요.
- 제3자 측정에서 4비트 이하로 줄이면 원본 대비 그림 차이가 빠르게 커졌고, 글자가 들어간 이미지가 먼저 무너졌어요.
- ‘검열 해제’ 파생본은 공식 체크포인트가 아니며, 공개 가중치에는 원래 콘텐츠 필터가 없다는 점과 라이선스 표기를 함께 확인해야 해요.
Qwen-Image 2.1 Turbo는 알리바바 Qwen 팀이 공개한 이미지 생성·편집 모델 Qwen-Image-2.1을 8번의 디노이징 단계로 이미지를 만들도록 가속한 공식 체크포인트예요. 텍스트로 그림을 만드는 것과 기존 이미지를 편집하는 것을 한 모델에서 처리하고, 가중치를 내려받아 직접 실행할 수 있어요. 다만 라이선스는 연구·평가용으로 제한돼 있고, 허깅페이스에서 함께 인기를 끄는 GGUF 양자화본과 ‘검열 해제’ 파생본은 Qwen이 직접 만든 파일이 아니에요. 이 글은 2026년 10월 기준 공식 모델 카드와 주요 양자화 배포처의 카드를 직접 읽고 정리한 내용이며, 특정 소프트웨어 버전과 측정 조건에 따라 결과가 달라질 수 있어요.
Qwen-Image 2.1 Turbo는 어떤 모델인가요?
기반 모델인 Qwen-Image-2.1은 시각 생성 부분이 70억(7B) 파라미터, 32개의 Single-Stream DiT 레이어로 구성된 통합 생성·편집 모델이에요. 공식 카드는 투명 배경(RGBA) 이미지 생성, 최대 10장의 참조 이미지를 이용한 편집, 원·덧칠·마스크로 편집 영역 지정, 인물·제품 정체성 유지, 개선된 글자 표현을 주요 특징으로 소개해요. 원본 2.1의 예제 코드는 이미지 한 장에 40단계 추론을 사용해요.
Turbo는 이 구조를 그대로 쓰면서 8단계에 맞춰 증류한 버전이에요. 공식 카드에 따르면 권장 샘플링 스케줄이 체크포인트 안에 저장돼 자동으로 불러와지고, 기본 CFG(분류기 자유 가이던스) 값은 1이며, 텍스트와 참조 이미지 문맥을 단계마다 재사용하는 prefix KV 캐시를 사용해요. 디퓨저스(Diffusers)의 QwenImage21Pipeline으로 바로 불러올 수 있지만, 체크포인트에 저장된 시그마 값을 읽는 기능이 추가된 최신 디퓨저스 소스와 transformers 5.17.0 이상이 필요하다고 안내돼 있어요.
시각 생성 구조
- Qwen-Image-2.1
- 7B, 32개 DiT 레이어
- Qwen-Image-2.1-Turbo
- 같은 7B 구조
공식 예제 단계 수
- Qwen-Image-2.1
- 40단계
- Qwen-Image-2.1-Turbo
- 8단계(저장된 스케줄)
CFG
- Qwen-Image-2.1
- 예제에서 별도 지정
- Qwen-Image-2.1-Turbo
- 기본 1
작업
- Qwen-Image-2.1
- 텍스트→이미지, 편집, RGBA
- Qwen-Image-2.1-Turbo
- 텍스트→이미지, 편집
라이선스
- Qwen-Image-2.1
- Qwen Research License
- Qwen-Image-2.1-Turbo
- Qwen Research License
지원 해상도와 샘플링 설정의 함정
두 모델 모두 약 2메가픽셀 프리셋을 안내해요. 1:1은 2048×2048, 16:9는 2752×1536, 9:16은 1536×2752 같은 식이에요. Turbo에서 특히 조심할 부분은 단계 수 설정이에요. 공식 카드는 num_inference_steps만 바꿔서는 저장된 8단계 스케줄이 덮어써지지 않고, 호출 시 sigmas를 직접 넘기면 덮어쓸 수 있지만 다른 스케줄은 평가하지 않았다고 밝혀요. 즉 단계를 늘리면 더 좋아질 것이라고 가정하기보다, 먼저 기본 설정으로 결과를 확인하는 편이 안전해요.
오픈 가중치지만 상업용은 아니에요: 라이선스 확인
‘오픈소스 이미지 모델’이라는 말 때문에 자유롭게 쓸 수 있다고 오해하기 쉬워요. Turbo 저장소의 LICENSE 파일은 2026년 9월 20일 공개된 Qwen Research License Agreement이고, 연구 또는 평가 목적의 비상업적 이용만 허용해요. 상업적으로 쓰려면 Qwen 측에 별도 라이선스를 요청해야 한다고 적혀 있어요.
- 재배포할 때는 계약서 사본을 함께 주고, 수정한 파일에는 변경 사실을 눈에 띄게 표시하며, 정해진 저작권 고지를 Notice 파일에 남겨야 해요.
- 모델이나 그 출력물로 다른 AI 모델을 만들어 배포하면 ‘Built with Qwen’ 또는 ‘Improved using Qwen’을 문서에 표시해야 해요.
- 파생 작업물의 주된 이름으로 ‘Qwen’을 쓰는 것은 금지되고, ‘Qwen Image에서 미세조정함’ 같은 설명적 사용만 허용돼요.
- 준거법은 중국법이며 분쟁은 항저우 법원이 전속 관할해요. 출력물의 안전성·안정성에 대한 보증도 없어요.
양자화본도 이 제한에서 벗어나지 않아요. 예를 들어 AtomicChat의 Turbo GGUF와 abenzerps의 2.1 양자화본은 모두 qwen-research 라이선스로 표시돼 있어요. 반면 AtomicChat의 검열 해제 인코더 저장소는 Apache-2.0으로 표시돼 있는데, 이는 원본이 Apache-2.0인 Qwen3-VL-8B 텍스트 인코더를 수정한 파일이기 때문이에요. 같은 카드가 짝을 이루는 Turbo 디노이저는 여전히 Qwen Research License라고 명시하므로, 파이프라인 전체를 상업적으로 쓸 수 있다는 뜻으로 읽으면 안 돼요.
GGUF 양자화 버전은 무엇이 다른가요?
양자화는 가중치를 더 적은 비트로 저장해 파일 크기와 메모리 사용량을 줄이는 방법이에요. 대신 원본과 똑같은 그림이 나오지 않을 수 있어요. 2026년 10월 기준 Qwen 공식 조직은 Turbo의 GGUF를 배포하지 않으며, 허깅페이스의 GGUF 파일은 모두 제3자가 만든 것이에요. 공식 카드의 모델 트리에는 Turbo 기반 양자화본이 37개로 표시돼 있었어요.
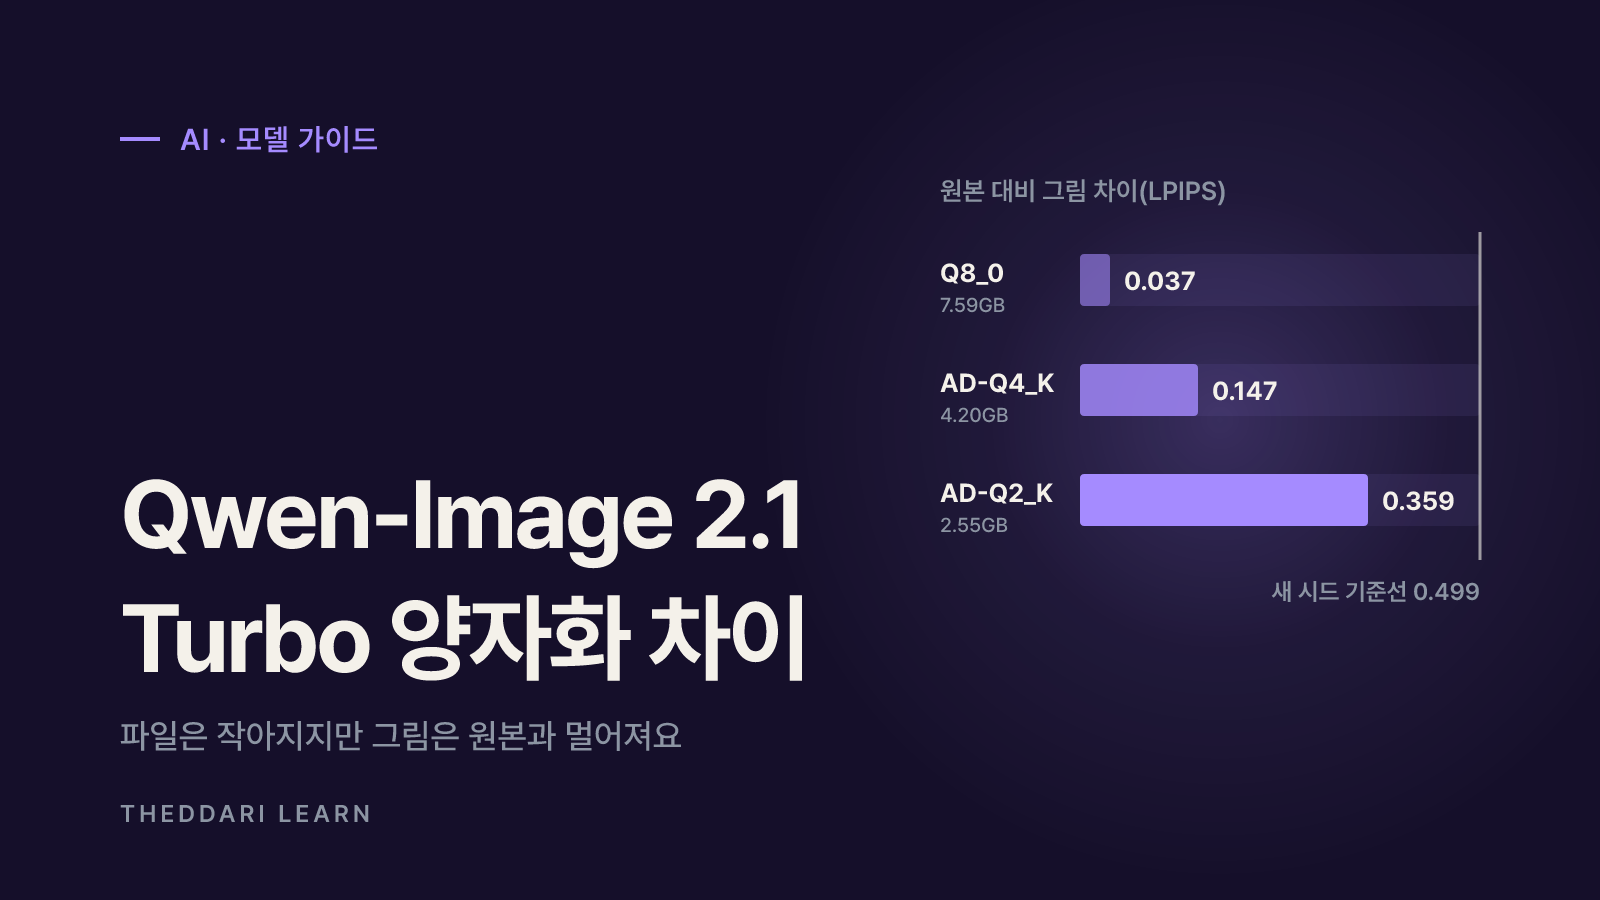
AtomicChat은 Turbo GGUF 카드에서 48개 프롬프트×2개 시드로 BF16 원본과 각 파일의 결과를 비교한 수치를 공개했어요. LPIPS는 사람이 느끼는 이미지 차이를 근사하는 지표로 0이면 동일하고 높을수록 달라요. 같은 프롬프트에서 시드만 바꿨을 때의 LPIPS가 0.499였으므로, 이 값을 ‘전혀 다른 그림’의 기준선으로 보면 이해하기 쉬워요. 측정은 1024×1024, A100 GPU, stable-diffusion.cpp 환경에서 이뤄졌고 텍스트 인코더와 VAE는 BF16으로 고정했어요.
BF16
- 크기
- 14.23GB
- LPIPS
- 0
- 새 시드 대비
- 0%
- 중국어 글자 LPIPS
- 0
Q8_0
- 크기
- 7.59GB
- LPIPS
- 0.037
- 새 시드 대비
- 7%
- 중국어 글자 LPIPS
- 0.037
AD-Q6_K
- 크기
- 6.71GB
- LPIPS
- 0.044
- 새 시드 대비
- 9%
- 중국어 글자 LPIPS
- 0.052
AD-Q5_K
- 크기
- 5.40GB
- LPIPS
- 0.076
- 새 시드 대비
- 15%
- 중국어 글자 LPIPS
- 0.080
AD-Q4_K
- 크기
- 4.20GB
- LPIPS
- 0.147
- 새 시드 대비
- 29%
- 중국어 글자 LPIPS
- 0.166
AD-Q3_K
- 크기
- 3.60GB
- LPIPS
- 0.206
- 새 시드 대비
- 41%
- 중국어 글자 LPIPS
- 0.267
AD-Q2_K
- 크기
- 2.55GB
- LPIPS
- 0.359
- 새 시드 대비
- 72%
- 중국어 글자 LPIPS
- 0.421
이 표에서 볼 점은 세 가지예요. 첫째, 8비트(Q8_0)는 원본과 매우 가깝지만 4비트부터 차이가 눈에 띄게 커져요. 둘째, 글자가 들어간 이미지가 사진보다 먼저 무너지는 경향이 있어 포스터·UI 시안처럼 텍스트 렌더링이 목적이라면 더 높은 비트를 고려해야 해요. 셋째, 같은 비트라도 만드는 방식이 중요해요. 같은 카드에서 모든 텐서를 한 형식으로 바꾼 일반 Q4_K(4.05GB)는 LPIPS 0.187, 일반 Q2_K는 0.475로 새 시드와 거의 같은 수준까지 벌어졌어요. 이 수치는 한 배포자의 측정이며 미학적 품질이나 프롬프트 준수도는 평가하지 않았다는 한계도 함께 적혀 있어요.
GGUF 하나로는 실행되지 않아요
GGUF 파일은 이미지 생성 본체인 디노이저만 담고 있어요. 실행하려면 Qwen3-VL-8B 텍스트 인코더와 VAE가 따로 필요해요. abenzerps 카드 기준 ComfyUI용 텍스트 인코더는 BF16 17.53GB, int8 9.35GB였고 VAE는 676MB였어요. 디노이저를 4GB대로 줄여도 인코더가 더 클 수 있다는 뜻이에요. AtomicChat은 인코더 양자화도 그림을 바꾼다고 측정했어요. Q8_0 인코더는 LPIPS 0.037, 일반 Q4_K_M 인코더는 약 0.17로 4비트 디노이저만큼 그림을 움직였다고 해요. 파일 용량 합계는 실제 GPU 메모리 최대 사용량과 같지 않으니, 필요한 VRAM은 사용하는 런타임·해상도·오프로딩 설정으로 직접 확인해야 해요.
Turbo 전용 스케줄을 맞춰야 해요
AtomicChat 카드는 stable-diffusion.cpp에서 --sigmas를 지정하지 않으면 Turbo가 증류되지 않은 Qwen-Image-2.1 기본 스케줄이 쓰여 결과가 달라진다고 경고해요. 8단계, CFG 1, euler 샘플러와 체크포인트의 sample_sigmas 값을 맞추고, 사용자 지정 시그마 버그가 고쳐진 2026년 10월 6일 이후 빌드를 쓰라고 안내해요. GGUF로 ‘화질이 나쁘다’고 느낄 때 양자화 탓인지 스케줄 설정 탓인지 먼저 분리해 보는 것이 좋아요.
‘검열 해제’ 파생본을 쓰기 전 확인할 위험
허깅페이스 인기 목록에는 이름에 Uncensored가 붙은 파생본이 함께 올라와 있어요. 이름만 보고 판단하면 실제로 무엇이 바뀌었는지 놓치기 쉬워요. AtomicChat의 검열 해제 GGUF 카드는 Qwen-Image가 안전 검사기·텍스트 인코더·디노이저 세 부분으로 이뤄지며, 공개 가중치에는 원래 콘텐츠 필터가 없고 필터는 Qwen의 호스팅 서비스에만 있다고 설명해요. 이 저장소는 텍스트 인코더의 거절 방향만 제거했고, 채팅 모델로서의 거절률은 영어 88.9%에서 1.2%로 낮아졌지만 이미지에서는 45개 민감 프롬프트 중 결과가 바뀐 경우가 0건이었다고 밝혔어요. 자체 품질 관문 두 개를 통과하지 못했다는 사실도 적혀 있어요.
abenzerps의 저장소는 Turbo가 아닌 Qwen-Image-2.1 기반이며, 카드에서 ‘원본 업스트림 기본 가중치’로 양자화했다고 설명하고 내장 안전 검사기나 필터가 없다고 적고 있어요. 즉 Turbo의 8단계 설정을 그대로 적용하면 안 되고, ‘검열 해제’라는 표현이 가중치를 크게 바꿨다는 뜻도 아닐 수 있어요. 이런 차이는 카드 본문과 체크섬(SHA256SUMS) 파일로 확인해야 해요.
안전 필터가 없다는 것은 결과물에 대한 책임이 사용자에게 있다는 뜻이에요. 미성년자 관련 성적 이미지, 동의 없는 실존 인물의 사적·모욕적 이미지는 여러 국가에서 불법이며, 배포 카드들도 이를 금지 사항으로 명시해요. 서비스로 운영한다면 자체 접근 통제와 정책 집행이 필요해요.
로컬 이미지 생성 전에 점검할 순서
- 1
목적과 라이선스를 먼저 정해요
연구·평가 목적인지, 업무나 수익 활동에 쓰는지 정리해요. 상업 목적이라면 Qwen Research License 범위를 벗어나므로 별도 라이선스 없이 진행하지 않아요.
- 2
원본인지 파생본인지 확인해요
저장소 주인이 Qwen 공식 조직인지, Turbo 기반인지 2.1 기반인지, 라이선스 표기가 무엇인지 카드에서 확인해요. 파생본은 체크섬과 변환에 쓴 원본 리비전이 공개돼 있는지도 봐요.
- 3
세 가지 파일과 런타임을 맞춰요
디노이저, Qwen3-VL-8B 텍스트 인코더, VAE를 같은 계열로 준비하고 ComfyUI-GGUF·stable-diffusion.cpp 등 런타임이 이 아키텍처를 지원하는 버전인지 확인해요.
- 4
비트 수는 용도에 맞춰 골라요
글자 렌더링이 중요하면 Q8_0이나 6비트 계열을, 메모리가 부족하면 4비트를 고려하되 3비트 이하는 그림이 눈에 띄게 달라질 수 있다는 측정 결과를 감안해요.
- 5
기본 설정으로 먼저 비교해요
8단계·CFG 1·전용 시그마로 같은 시드를 돌려 결과를 확인한 뒤 해상도나 설정을 바꿔요. 변화가 생기면 양자화·인코더·스케줄 중 무엇 때문인지 하나씩 분리해요.
오픈 모델 소식은 짧은 기간에 파생본과 사용 후기가 쏟아지기 때문에 흐름을 따라가기 어려워요. 더따리의 텔레그램 AI 트렌드와 블로그 트렌드 대시보드에서 관련 화제를 모아 볼 수 있지만, 실제 설정값과 라이선스는 항상 원문 모델 카드에서 다시 확인하는 것이 좋아요.

이 글은 AI가 작성한 일반 정보이며 투자 조언이 아닙니다. 특정 모델·파일의 사용이나 관련 기업 투자를 권유하지 않아요. 수치는 2026년 10월 기준 각 모델 카드에 공개된 값이며, 라이선스·법적 책임은 공식 원문과 거주 국가의 법률을 확인해 판단하세요.