Nanbeige4.3-33B란? 특징·벤치마크와 로컬 실행 사양 정리
Nanbeige4.3-33B를 모델 카드 기준으로 정리해요. 33B 구조, 자체 공개 벤치마크 읽는 법, GGUF 양자화별 파일 크기와 메모리, Apache 2.0 라이선스 확인점을 담았어요.
목차7개 섹션
핵심 요약
- Nanbeige4.3-33B는 Nanbeige LLM Lab이 공개한 33B 파라미터 텍스트 생성 모델로, 에이전트형 코딩·업무(cowork) 작업을 목표로 한 시리즈의 '교사 모델'이에요.
- 모델 카드의 벤치마크는 개발사가 직접 측정한 값이에요. Terminal-Bench 2.1은 80.9로 Qwen3.8-27B(73.0)보다 높지만 SWE-Bench Pro·GDPval에서는 Qwen3.8-27B가 앞서요.
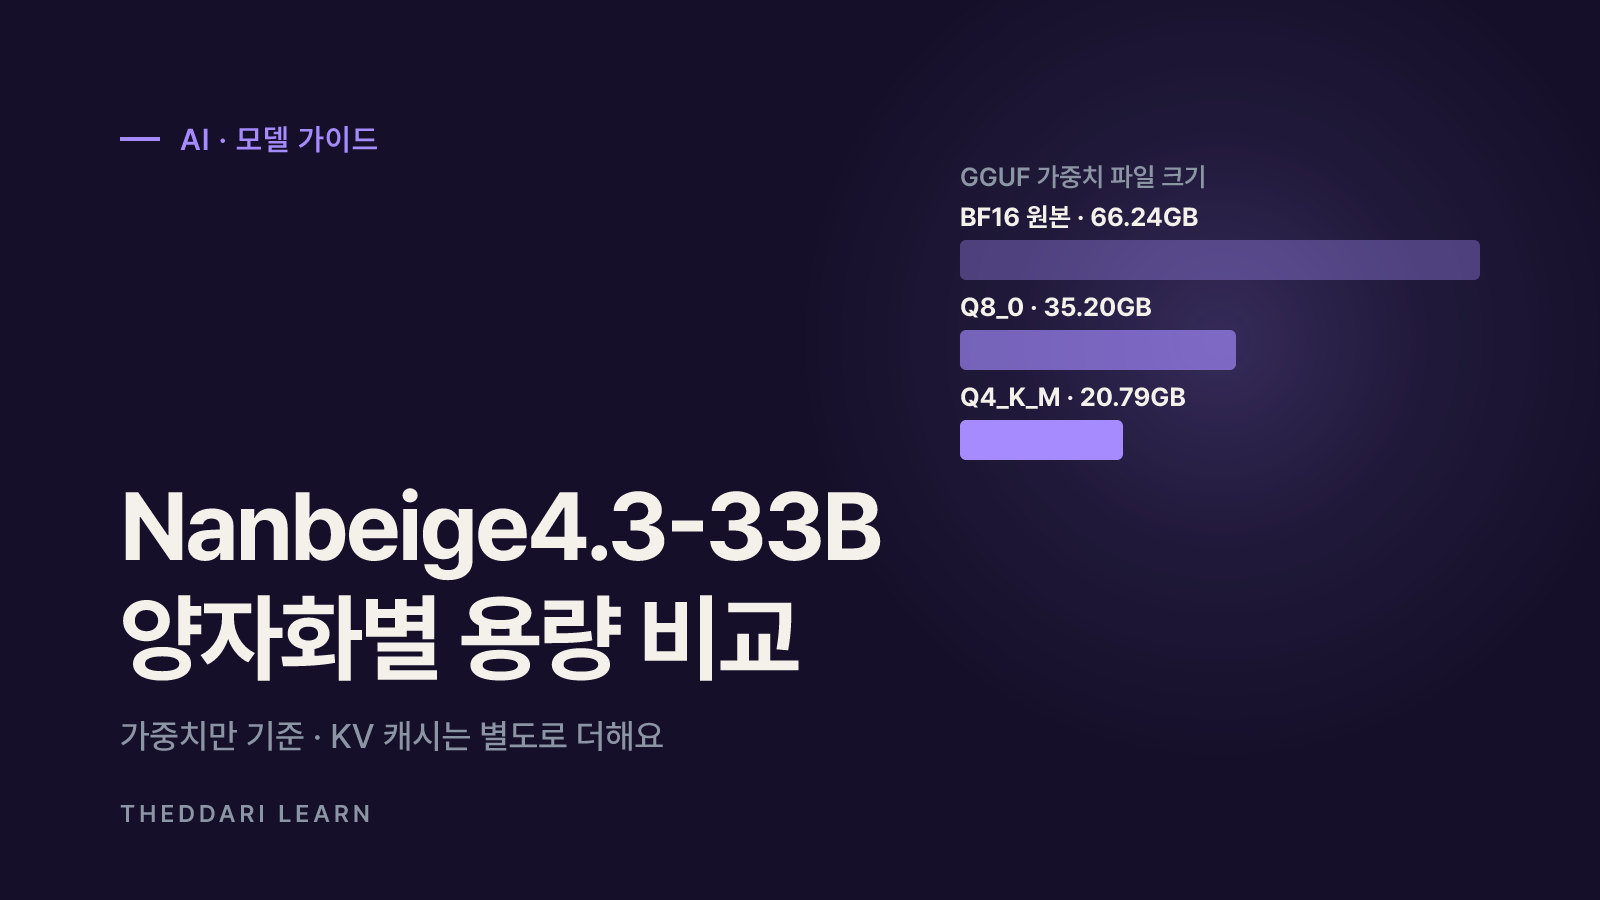
- 원본 BF16 가중치는 약 66GB예요. 커뮤니티 GGUF 기준 Q4_K_M은 20.79GB, Q8_0은 35.20GB라 가중치만으로도 메모리 요구가 크게 달라져요.
- 최대 524,288토큰(512K) 컨텍스트를 지원하지만 긴 컨텍스트는 KV 캐시 메모리를 크게 늘리므로 실제 사용할 길이를 먼저 정해야 해요.
- 허브 메타데이터의 라이선스는 Apache 2.0이에요. 상업적 이용은 가능하지만 재배포 시 고지 의무가 있고, 파인튜닝·양자화 파생 모델은 각 저장소 조건을 따로 확인해야 해요.
Nanbeige4.3-33B는 Nanbeige LLM Lab이 허깅페이스에 공개한 33B 파라미터 공개 가중치 언어 모델로, 터미널 코딩·업무 자동화 같은 에이전트형 작업을 겨냥해요. Nanbeige4.3 시리즈에서 더 작은 모델(예: Nanbeige4.3-3B)로 능력을 증류하기 위한 '교사 모델'이라고 개발사가 설명해요. 이 글은 2026년 10월 31일에 확인한 모델 카드와 설정 파일, 양자화 저장소를 바탕으로 특징과 로컬 실행 전에 확인할 메모리·라이선스 조건을 정리해요. 확인 시점 모델 페이지에는 좋아요 820개, 최근 한 달 다운로드 13,832회가 표시돼 있었어요.
Nanbeige4.3-33B란? 모델 카드로 본 기본 정보
모델 카드 소개에 따르면 Nanbeige4.3-33B는 약 30B급 공개 모델 가운데 에이전트 성능을 끌어올리는 것을 목표로 만든 시리즈의 플래그십이에요. 복잡한 코딩과 전문 업무(개발사 표현으로 professional cowork) 작업에 강하다고 소개하며, 기반 모델인 Nanbeige4.3-33B-Base에서 파인튜닝한 대화형 모델이에요. 허브 태그는 텍스트 생성, Transformers, Safetensors, 영어·중국어로 표시돼 있어요.
파라미터
- 공개 값
- 33B (BF16 텐서)
- 확인 위치
- 모델 카드 메타데이터
아키텍처
- 공개 값
- LlamaForCausalLM, 52개 레이어
- 확인 위치
- config.json
어텐션
- 공개 값
- 쿼리 헤드 56개 · KV 헤드 8개(GQA)
- 확인 위치
- config.json
최대 컨텍스트
- 공개 값
- 524,288토큰(512K)
- 확인 위치
- 모델 카드·config.json
원본 파일
- 공개 값
- safetensors 14개 분할, 합계 약 66.3GB
- 확인 위치
- 저장소 파일 목록
언어 태그
- 공개 값
- 영어, 중국어
- 확인 위치
- 모델 카드 태그
라이선스
- 공개 값
- apache-2.0
- 확인 위치
- 허브 메타데이터
config.json에는 은닉 차원 7,168, 어휘 크기 166,912, 헤드 차원 128이 적혀 있고 전문가(MoE) 관련 항목이 없어요. 즉 토큰마다 33B 전체가 계산에 참여하는 dense 구조로 읽혀요. 같은 '30B급'이라도 활성 파라미터가 일부뿐인 MoE 모델과는 속도·메모리 특성이 달라요.
생각 모드와 도구 호출 템플릿
토크나이저의 채팅 템플릿에는 두 스위치가 있어요. enable_thinking은 답변 전에 추론 과정을 생성할지 정하며 기본값이 켜짐이에요. preserve_thinking은 이전 턴의 추론을 대화 기록에 남길지 정하는데, 개발사는 일반 대화·질의응답에는 False, 여러 턴의 도구 사용·사무 작업·코드 에이전트에는 True를 권장해요. 도구를 넘기면 도구 호출 템플릿이 켜지고 XML 형식(tool_call_format="xml")을 권장하며 JSON도 지원해요.
권장 생성 설정도 용도별로 달라요. 에이전트·도구 작업은 temperature 1.0, top_p 0.95, 최대 생성 65,536토큰이고 추론·대화는 temperature 0.6, top_p 0.95, 최대 생성 262,144토큰이에요. 생각 모드를 켜면 답변보다 추론 토큰이 훨씬 길어질 수 있어 응답 시간과 메모리 사용량이 함께 늘어난다는 점을 기억하세요.
공개 벤치마크 읽는 법: 어디서 앞서고 어디서 뒤지나
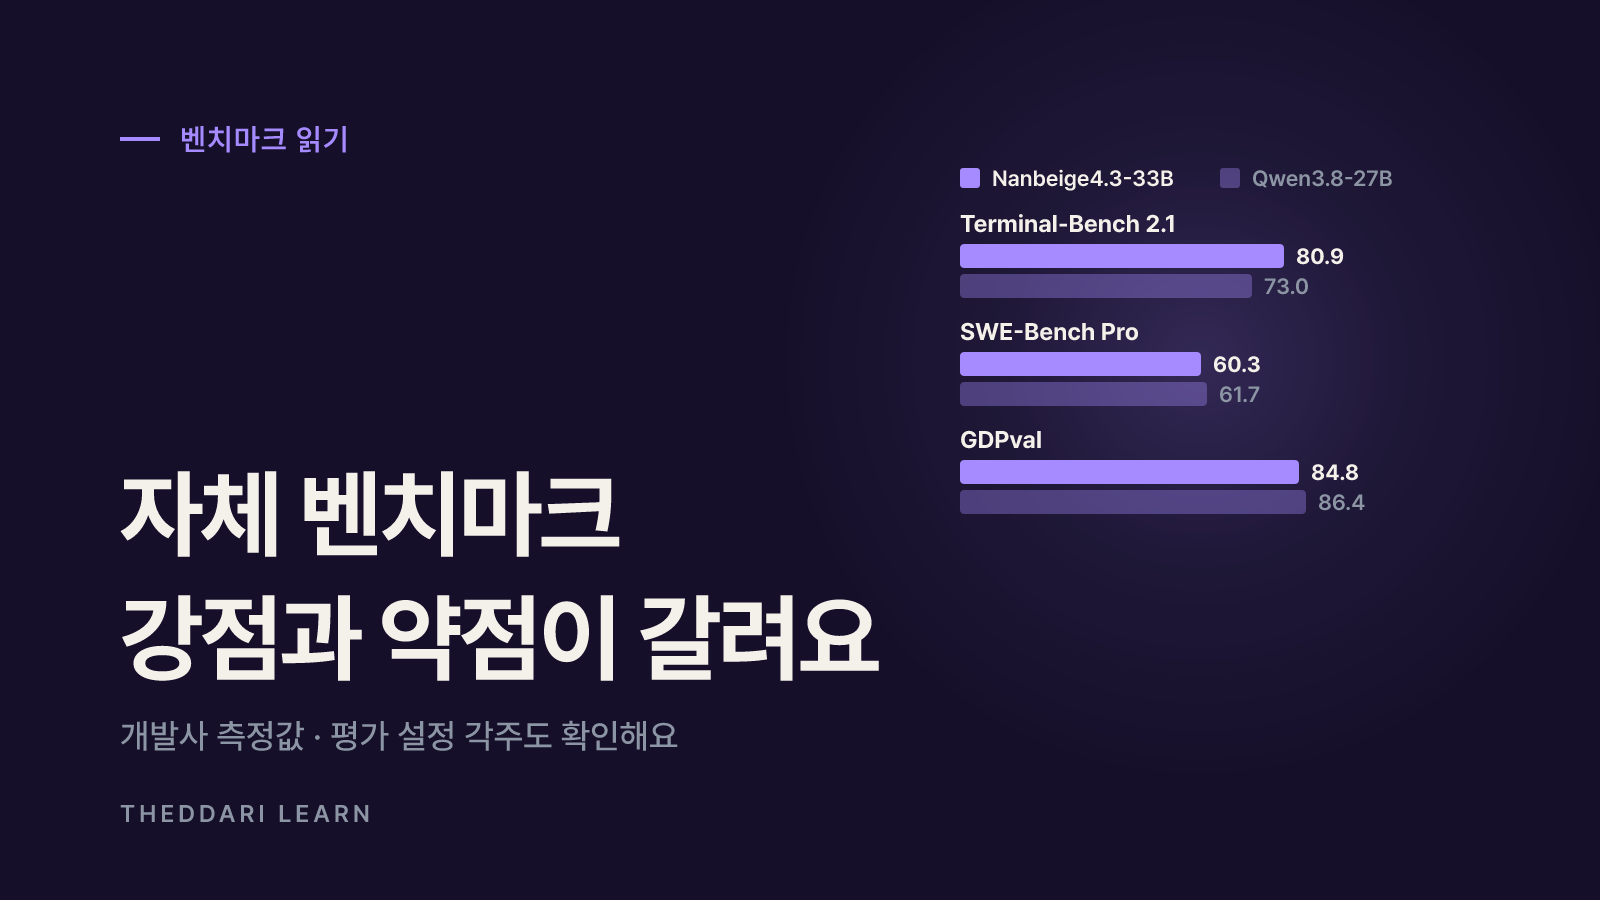
모델 카드는 비슷한 크기의 Qwen3.8-27B, Muse-Glimmer-30B, Gemma4-31B와 비교한 표를 싣고 있어요. 모든 모델을 가장 높은 생각 강도로, 같은 추론 하이퍼파라미터와 하네스로 평가했다고 밝히지만 개발사가 직접 측정한 값이라는 점이 출발점이에요. 독립 기관의 재현 결과가 쌓이기 전까지는 방향을 보는 참고 자료로 읽는 편이 안전해요.
Terminal-Bench 2.1
- Nanbeige4.3-33B
- 80.9
- Qwen3.8-27B
- 73.0
- Gemma4-31B
- 47.2
DeepSWE
- Nanbeige4.3-33B
- 65.5
- Qwen3.8-27B
- 42.5
- Gemma4-31B
- 2.7
SWE-Bench Pro
- Nanbeige4.3-33B
- 60.3
- Qwen3.8-27B
- 61.7
- Gemma4-31B
- 36.9
GDPval
- Nanbeige4.3-33B
- 84.8
- Qwen3.8-27B
- 86.4
- Gemma4-31B
- 71.4
GPQA Diamond
- Nanbeige4.3-33B
- 89.5
- Qwen3.8-27B
- 89.2
- Gemma4-31B
- 91.3
AIME 2026
- Nanbeige4.3-33B
- 95.2
- Qwen3.8-27B
- 94.5
- Gemma4-31B
- 89.2
표를 보면 터미널 작업(Terminal-Bench 2.1)과 DeepSWE, 업무 자동화(Automation Bench 54.2 대 38.3) 쪽 격차가 크고, 실제 저장소 수정에 가까운 SWE-Bench Pro와 업무 산출물 평가 GDPval에서는 Qwen3.8-27B가 근소하게 앞서요. 과학 추론 GPQA Diamond는 Gemma4-31B가 가장 높아요. 따라서 '대부분의 벤치마크에서 1위'라는 요약보다, 내가 맡길 작업과 가장 닮은 항목의 점수를 따로 보는 것이 중요해요.
각주도 함께 읽어야 해요. Nanbeige4.3-33B는 preserve_thinking=true 설정으로 평가됐고, NL2Repo는 Claude Code 하네스로, SWE-Atlas-QnA는 다른 모델을 채점자로 써서 평가했어요. 하네스·설정이 다르면 같은 모델도 점수가 크게 달라질 수 있으니 로컬 환경에서 같은 결과가 나온다고 가정하지 마세요.
새 공개 모델은 커뮤니티 반응이 빠르게 바뀌어요. 개발자 채널에서 실제 사용 후기나 재현 실험이 어떻게 언급되는지 더따리 AI 텔레그램 트렌드와 블로그 트렌드에서 함께 살펴보면 벤치마크 표만 볼 때 놓치는 문제(템플릿 오류, 반복 출력 등)를 빨리 파악하는 데 도움이 돼요.

Nanbeige4.3 로컬 실행 사양: 양자화별 파일 크기와 메모리
로컬 실행에서 가장 먼저 볼 숫자는 가중치 파일 크기예요. 원본 저장소의 BF16 가중치는 합계 약 66.3GB라 24GB 소비자용 GPU 한 장에는 들어가지 않아요. 개발사의 SGLang·vLLM 예시도 텐서 병렬 4(--tp-size 4)로 GPU 4장을 전제로 해요. 개발사는 공식 FP8·INT8·INT4 변형도 별도 저장소로 올렸고, 확인 시점 양자화 파생 모델은 99개였어요.
BF16
- 파일 크기
- 66.24GB
- 제작자 설명
- 전체 BF16 가중치
Q8_0
- 파일 크기
- 35.20GB
- 제작자 설명
- 최고 품질, 보통은 불필요
Q6_K
- 파일 크기
- 29.02GB
- 제작자 설명
- 매우 높은 품질
Q5_K_M
- 파일 크기
- 25.07GB
- 제작자 설명
- 높은 품질
Q4_K_M
- 파일 크기
- 20.79GB
- 제작자 설명
- 대부분 용도의 기본값
IQ3_M
- 파일 크기
- 17.80GB
- 제작자 설명
- 중하 품질
Q2_K
- 파일 크기
- 13.53GB
- 제작자 설명
- 매우 낮은 품질
bartowski GGUF 저장소는 GPU에 전부 올려 빠르게 돌리려면 VRAM보다 1~2GB 작은 파일을, 품질을 최대로 하려면 시스템 RAM과 VRAM을 합친 용량보다 1~2GB 작은 파일을 고르라고 안내해요. 이 파일들은 llama.cpp b11845 릴리스로 만들었으니 그보다 오래된 llama.cpp·LM Studio·Ollama 버전에서는 로드가 실패할 수 있어요.
KV 캐시: 컨텍스트 길이가 메모리를 키워요
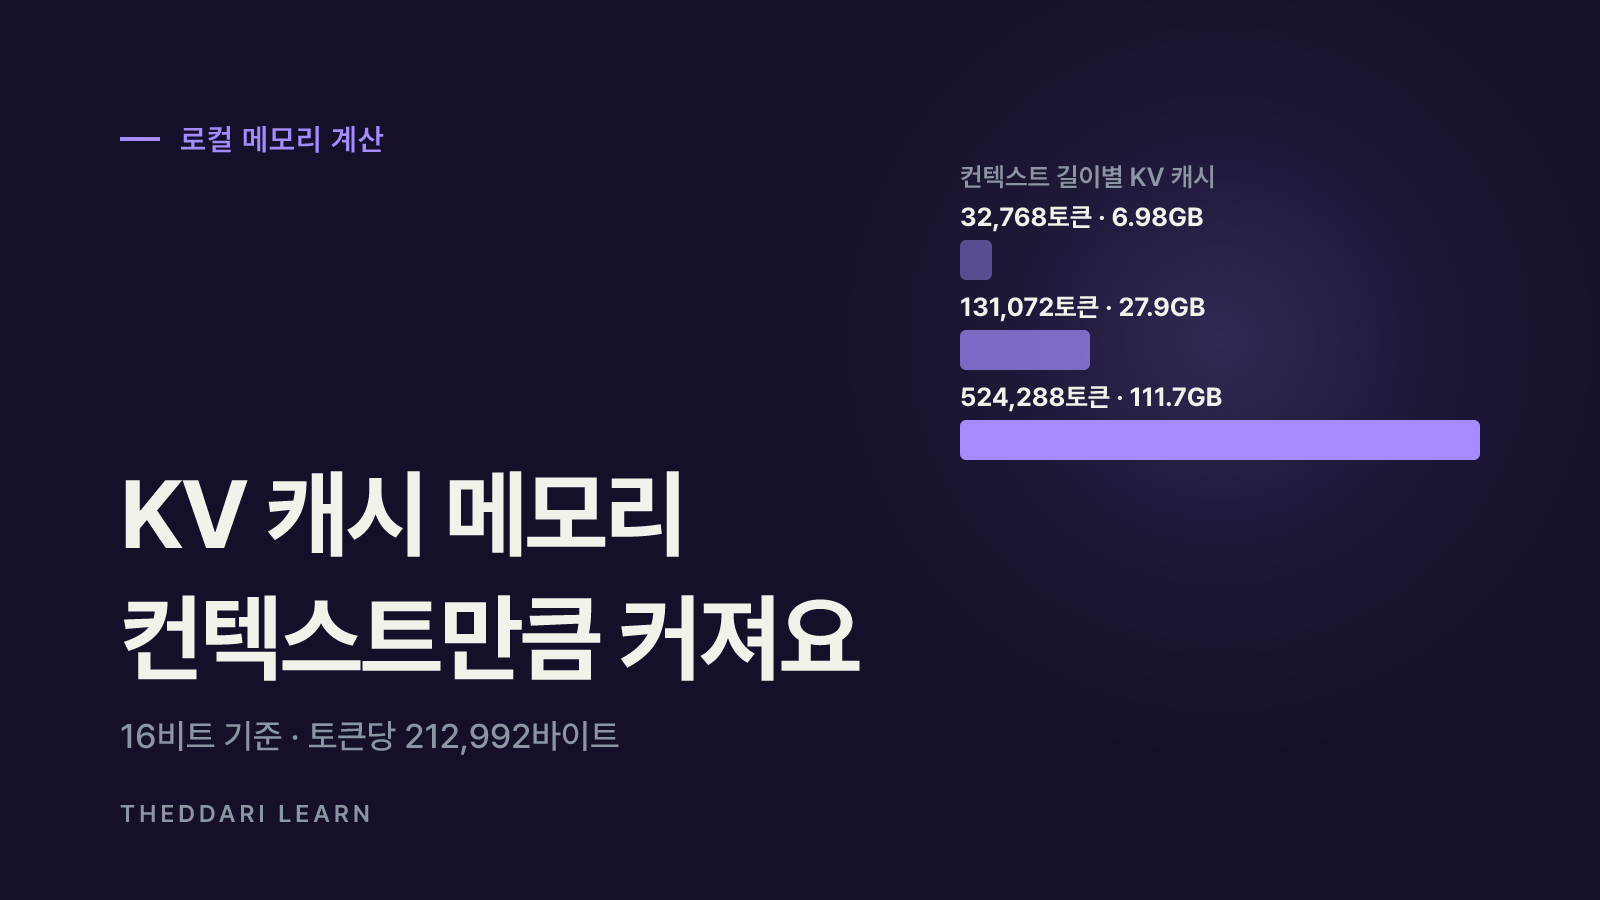
가중치 외에 대화 길이만큼 늘어나는 KV 캐시가 필요해요. config.json 값(레이어 52, KV 헤드 8, 헤드 차원 128)으로 계산하면 16비트 KV 캐시는 토큰당 2(K·V) × 52 × 8 × 128 × 2바이트 = 212,992바이트예요. 32,768토큰이면 약 6.98GB, 131,072토큰이면 약 27.9GB, 최대치인 524,288토큰이면 약 111.7GB가 KV 캐시에만 들어가요. 실제 값은 런타임의 KV 캐시 양자화·페이징 방식에 따라 달라지지만, 512K 지원이 곧 소비자 PC에서 512K를 쓸 수 있다는 뜻은 아니라는 점은 분명해요.
예를 들어 24GB GPU에 Q4_K_M(20.79GB)을 올리면 남는 메모리가 약 3GB라 32K 컨텍스트의 16비트 KV 캐시(약 6.98GB)도 다 담기 어려워요. 이때는 컨텍스트를 줄이거나 KV 캐시를 8비트 이하로 양자화하거나, 일부 레이어를 CPU 메모리로 내리는 선택지를 비교해요. 통합 메모리를 쓰는 Mac도 가중치·KV 캐시·운영체제 사용분을 합친 값이 전체 메모리보다 넉넉히 작아야 해요.
라이선스와 상업적 이용 전에 확인할 점
허브 메타데이터의 라이선스는 apache-2.0이에요. Apache License 2.0은 사용·수정·재배포와 상업적 이용을 허용하고 특허 사용권도 부여해요. 대신 재배포할 때 라이선스 사본을 함께 주고, 수정한 파일에는 변경 사실을 표시하며, 기존 저작권·출처 고지를 유지해야 해요. 상표 사용권은 포함되지 않고, 결과물은 보증 없이 '있는 그대로' 제공돼요.
- 확인 시점 원본 저장소 파일 목록에는 별도 LICENSE·NOTICE 파일이 보이지 않았어요. 메타데이터 태그만으로 법무 판단이 부족하면 개발사 문의 기록을 남겨요.
- 커뮤니티 양자화·파인튜닝 모델은 원본과 라이선스 표기가 다를 수 있어요. 안전 장치를 제거했다고 표시한 abliterated·Heretic 계열은 출력 위험도 함께 검토해요.
- Transformers 예시는
trust_remote_code=True를 써요. 원격 코드를 실행하는 옵션이므로 커밋 해시를 고정하고 코드 내용을 확인한 뒤 격리된 환경에서 실행하는 편이 안전해요. - 모델 출력의 사실성·저작권·개인정보 책임은 사용하는 쪽에 있어요. 고객 대상 서비스라면 별도 평가와 필터링을 계획해요.
로컬 실행 전 체크리스트
- 1
용도와 비교 기준을 정해요
터미널 코딩, 저장소 수정, 문서 작업 중 무엇을 맡길지 정하고 모델 카드에서 그 작업과 가장 닮은 벤치마크를 골라요. 지금 쓰는 모델과 같은 과제 10~20개로 직접 비교할 계획을 세워요.
- 2
메모리 예산을 계산해요
사용할 양자화 파일 크기에 원하는 컨텍스트의 KV 캐시와 1~2GB 여유를 더해 GPU·통합 메모리와 비교해요. 생각 모드를 켜면 출력이 길어지므로 컨텍스트를 넉넉히 잡아요.
- 3
런타임 버전과 템플릿을 확인해요
llama.cpp 계열은 GGUF 제작 릴리스(b11845) 이상인지, vLLM·SGLang은 개발사 예시의 추론·도구 파서 옵션을 쓰는지 확인해요. 템플릿이 맞지 않으면 추론 태그가 그대로 출력되거나 도구 호출이 깨질 수 있어요.
- 4
라이선스와 보안을 기록해요
쓰려는 저장소의 라이선스, 커밋 해시, 원격 코드 실행 여부를 기록해요. 파생 모델을 쓰면 그 저장소의 조건과 제작자를 함께 남겨요.
정리하면 Nanbeige4.3-33B는 에이전트형 코딩·업무 작업에서 같은 크기 모델보다 높은 자체 측정 점수를 내세운 dense 33B 모델이고, Apache 2.0 표기로 상업적 활용 여지가 넓어요. 반면 BF16 원본은 약 66GB, 4비트 GGUF도 20GB 안팎이라 24GB GPU에서는 컨텍스트가 크게 제한돼요. 벤치마크 각주, 내 하드웨어의 메모리 예산, 파생 모델의 라이선스를 먼저 확인한 뒤 작은 과제부터 직접 비교해 보는 순서가 시행착오를 줄여요.