AI 에이전트 로봇 제어, 어디까지 됐나? AgentRoboCritic 연구 정리
AI 에이전트 로봇 제어 능력을 행동 단위로 분석한 AgentRoboCritic 논문을 정리했어요. 실패 복구율, 집기·정렬 한계, 로봇 전용 모델과의 성공률·지연 시간 차이를 설명해요.
목차8개 섹션
핵심 요약
- AgentRoboCritic은 AI 에이전트가 행동마다 '이번 동작의 목적(로컬 의도)'을 적게 하고, 그 의도 대비 성공·실패와 실패 유형을 채점하는 분석 틀이에요.
- 12개 조작 벤치마크 분석에서 실패한 행동의 57.7%는 같은 에피소드 안에서 검증된 방식으로 복구됐고, 성공한 에피소드의 49.8%에는 중간 실패가 하나 이상 있었어요.
- 약점은 물리 실행이에요. 집기(Grasp)가 비촉각 벤치마크 10개 중 9개에서 가장 흔한 실패였고, 정렬(Alignment) 실패의 복구율은 35.7%에 그쳤어요.
- RoboTwin 2.0·YAMLab에서 GPT-6 Astra의 제로샷 성공률은 91%·90%로 π0.5(6%·0%)보다 높았지만, 한 번 판단에 평균 33.3초가 걸려 0.12초인 VLA보다 크게 느렸어요.
- 아직 동료 심사 전 프리프린트이고, 정책과 채점자가 같은 모델이라는 점 등 해석 한계를 함께 봐야 해요.
AI 에이전트 로봇 제어는 '된다, 안 된다'의 문제가 아니라 '어떤 동작에서 되고 어디서 막히느냐'의 문제라는 것이 2026년 11월 19일 arXiv에 공개된 AgentRoboCritic 논문의 핵심이에요. 카네기멜런대·일리노이대(UIUC)·보쉬 연구진은 GPT-6 Astra가 로봇에 숫자 명령을 직접 내린 기록을 12개 조작 벤치마크에서 모아 행동 하나하나를 채점했어요. 결과는 '스스로 실수를 고치고 엉뚱한 물체를 거의 고르지 않지만, 물건을 정확히 집고 끼우는 물리 동작이 병목'이라는 쪽이었어요.
이 글은 2026년 11월 기준 논문 원문과 프로젝트 페이지에서 확인한 수치만 사용해요. 아직 동료 심사를 거치지 않은 프리프린트라 수치와 결론은 이후 개정될 수 있어요.
AgentRoboCritic이란? AI 에이전트 로봇 제어를 행동 단위로 채점하는 방법
기존 평가는 한 에피소드(과제 한 번 수행)가 성공했는지만 0 또는 1로 기록했어요. 그러면 성공한 시도 안에 실수가 몇 번 있었는지, 실패한 시도는 어느 동작에서 무너졌는지 알 수 없어요. 그렇다고 동작 하나를 전체 목표와 바로 비교하면 판정이 모호해져요. 같은 과제를 여러 경로로 해낼 수 있어서, 똑같은 움직임이 덜 뻗은 손일 수도, 빗나간 정렬일 수도, 실패한 집기일 수도 있기 때문이에요.
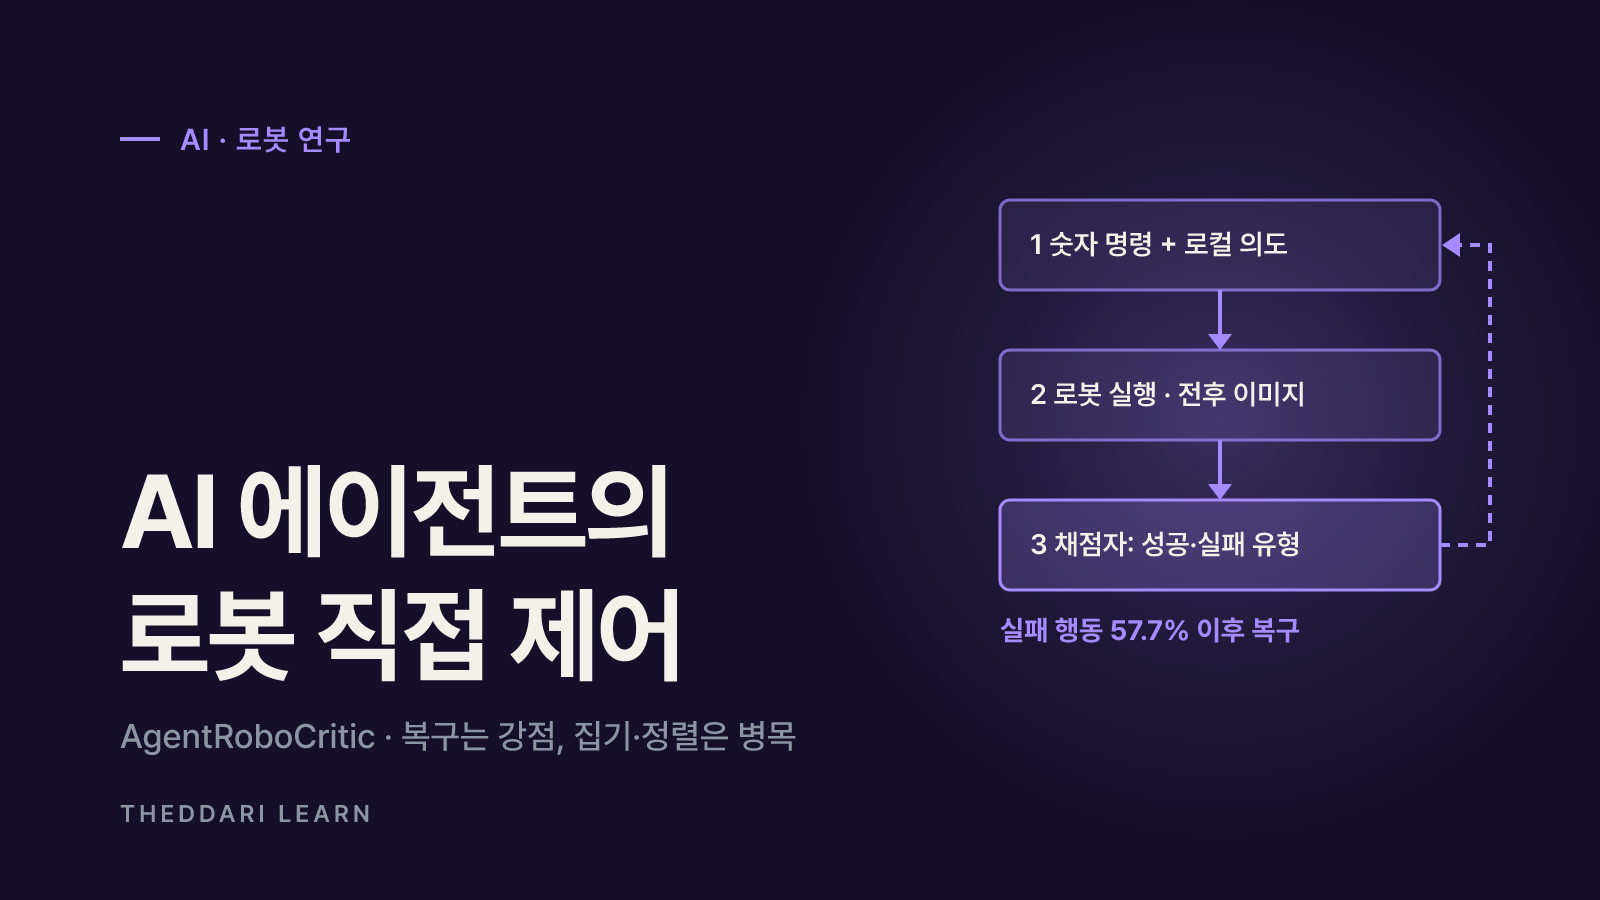
연구진의 해법은 로컬 의도(local intent)예요. 에이전트가 행동 명령을 낼 때마다 같은 도구 호출 안에 '이번 동작으로 무엇을 하려는지'를 자연어로 적게 하고, 이 메모가 빠진 호출은 실행 환경이 거부하도록 했어요. 그 다음 채점자(critic) 모델이 전체 목표, 로컬 의도, 동작 전후의 다중 카메라 이미지를 보고 판정해요.
- 1
에이전트가 명령과 의도를 함께 출력
엔드이펙터 자세·관절 목표·그리퍼 개폐 같은 숫자 명령과 '파란 조각 위에서 그리퍼를 닫는다' 같은 로컬 의도를 한 번에 내보내요.
- 2
로봇이 실행하고 새 이미지를 반환
고수준 스킬 없이 실행 결과 이미지가 다시 에이전트에게 돌아가는 폐루프 구조예요. 집기 동작은 들어 올린 뒤 프레임까지 증거로 써요.
- 3
채점자가 결과와 실패 유형을 판정
결과는 달성·실패·부분·검증 불가 중 하나이고, 실패면 집기·정렬·간섭·효과·미완료 동작·선택·미해결 7가지 유형 중 하나와 짧은 근거 메모를 붙여요.
- 4
사람 라벨로 채점자 검증
사람이 같은 입력으로 라벨한 400개 행동과 비교해 채점자의 신뢰도를 확인해요.
채점자로는 GPT-6 Astra를 썼어요. 사람 라벨 400개(성공 34%, 실패 66%) 기준으로 결과 판정 정확도 79.25%, 실패 유형 정확도 80.68%로 평가 모델 중 가장 높았다고 논문 HTML 본문과 프로젝트 페이지가 밝혀요. 같은 채점자에서 로컬 의도를 빼면 각각 25.25%, 25.00%로 무너졌어요. 행동 단위 평가에는 '무엇을 하려 했는지'가 꼭 필요하다는 뜻이에요.
프런티어 에이전트가 잘한 것: 스스로 복구·정확한 대상 선택·제로샷
실수해도 다시 시도해서 고친다
시연 데이터를 흉내 내도록 학습한 로봇 정책은 한 번 실수하면 학습 분포 밖 상황에 놓이고 오류가 눈덩이처럼 커지는 약점(공변량 이동)이 있어요. 프로젝트 페이지의 복구 분석에 따르면 프런티어 에이전트는 달랐어요. 성공한 에피소드의 49.8%에 실패한 행동이 하나 이상 있었고, 실패가 1~2번 있었던 에피소드도 40.3%가 성공했어요(실패 없는 에피소드는 75.1%).
연구진은 1,989개 에피소드의 실패 행동 12,163개를 끝까지 추적했어요. 이 중 38.9%가 이후 10개 행동 안에, 57.7%가 에피소드가 끝나기 전에 검증된 방식으로 복구됐어요. 예를 들어 집기에 실패한 뒤 다시 잡아서 물체가 그리퍼와 함께 올라가는 것이 확인돼야 복구로 쳤어요. 벤치마크별 복구율과 성공률의 상관계수는 0.81이었어요. 다만 실패 행동 가운데 9,923개가 RoboDojo 하나에서 나와 전체 평균이 이 벤치마크에 크게 끌려간다는 점은 기억해 두세요.
엉뚱한 물체를 고르는 일은 드물다
전체 실패 중 '선택(Choice)' 실패, 즉 의도에 적은 물체·순서·종류와 다르게 행동한 경우는 0.2%였고, 어느 벤치마크에서도 3.3%를 넘지 않았어요. 카메라 위치나 배치가 바뀌면 성능이 크게 떨어지는 기존 로봇 전용 모델과 대비되는 결과예요. 언어 모델의 장면 이해 능력이 '무엇을 집을지'에서는 잘 통한다는 뜻이에요.
과제별 학습 없이도 바로 작동
과제별 미세조정이나 시연 예시 없이 RoboTwin 2.0에서 91%, YAMLab에서 90% 성공률을 냈어요. 같은 조건에서 VLA인 π0.5는 6%와 0%, InternW0-Δ는 두 벤치마크 모두 0%였어요. 하나의 모델이 대화·추론 능력을 그대로 유지하면서 로봇 조작까지 한다는 점도 연구진이 강조한 장점이에요.

아직 못하는 것: 집기·정렬과 고르지 않은 복구
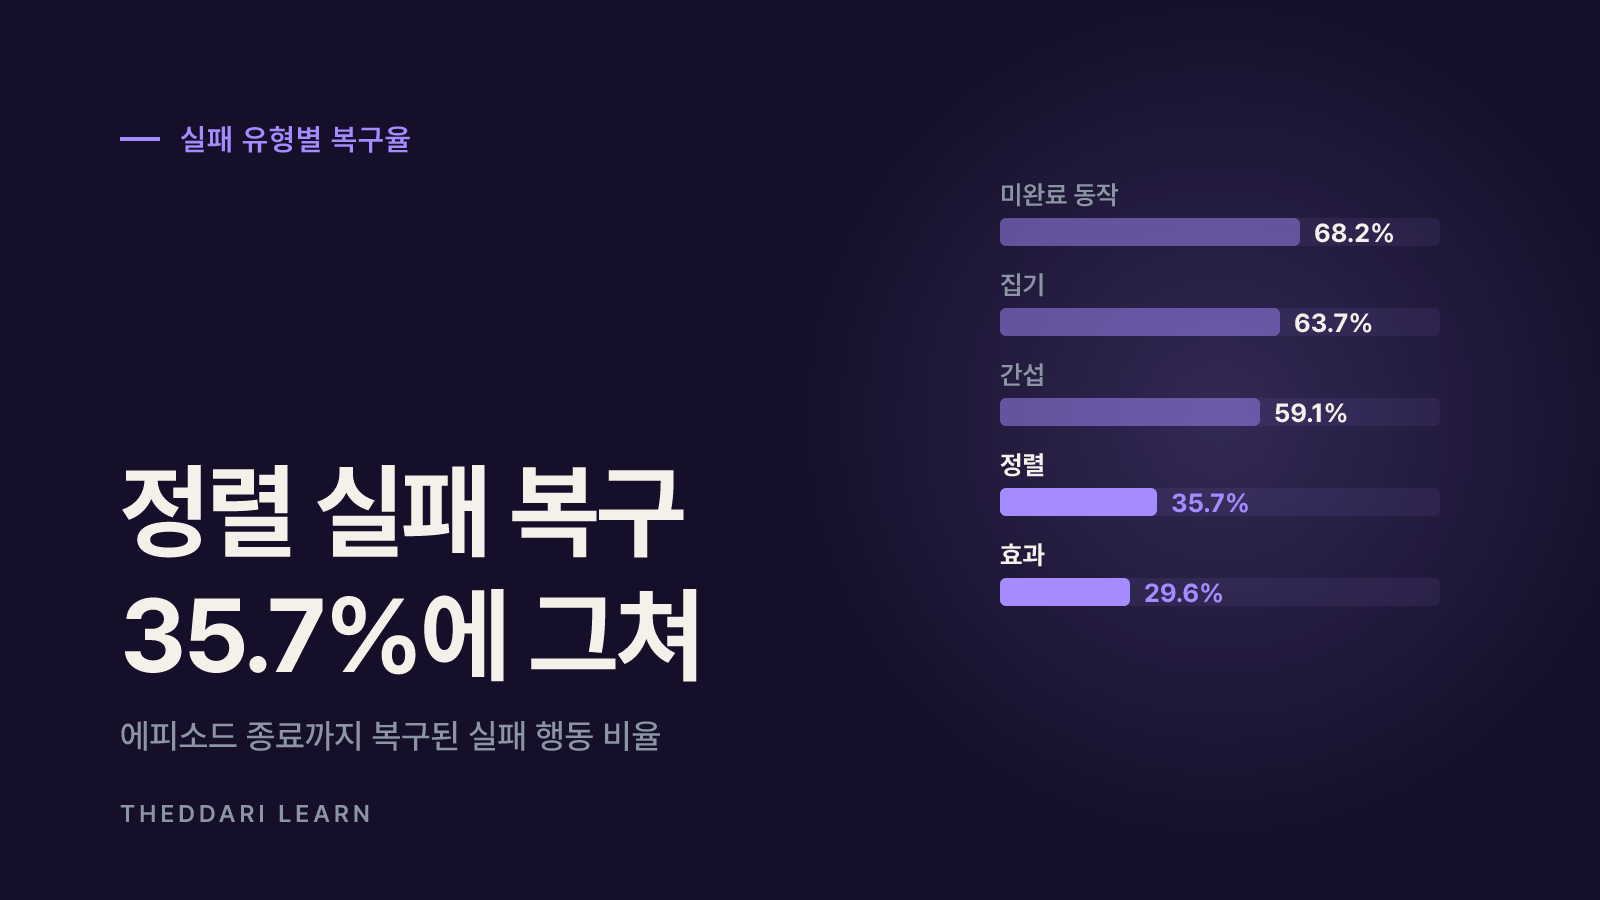
약점은 '무엇을'이 아니라 '어떻게 정확히'에 있었어요. 프로젝트 페이지의 실패 유형 표를 보면 집기(Grasp)가 비촉각 벤치마크 10개 중 9개에서 가장 흔한 실패였어요. 촉각 센서 없이 시각만으로 좁은 공차 삽입을 하는 UniVTAC·OpenViTac에서는 정렬(Alignment) 실패가 각각 75%, 86%를 차지했고, 물건이 많이 흩어진 장면에서는 의도치 않은 충돌(Interference)이 늘었어요.
미완료 동작
- 뜻
- 명령한 이동·열기가 끝나지 않음
- 에피소드 종료까지 복구율
- 68.2% (702건 중 479)
집기(Grasp)
- 뜻
- 물체를 못 잡거나 놓침
- 에피소드 종료까지 복구율
- 63.7% (6,523건 중 4,155)
간섭(Interference)
- 뜻
- 의도치 않은 충돌·밀림
- 에피소드 종료까지 복구율
- 59.1% (2,711건 중 1,602)
정렬(Alignment)
- 뜻
- 잡은 물체가 목표 위치·각도에 안 맞음
- 에피소드 종료까지 복구율
- 35.7% (1,908건 중 681)
효과(Effect)
- 뜻
- 도구를 잡았지만 원하는 효과가 안 남
- 에피소드 종료까지 복구율
- 29.6% (294건 중 87)
표처럼 복구도 유형별로 고르지 않았어요. 집기 실패는 대부분 다시 잡아 해결했지만 정렬과 효과 실패는 셋 중 하나 정도만 복구됐고, 행동을 30번 더 해도 복구율이 3%포인트도 오르지 않았어요. 시도를 늘린다고 정밀도 문제가 풀리지는 않는다는 뜻이에요.
집기 실패를 더 쪼개 보면 다섯 번 중 세 번은 그리퍼를 닫는 순간에 일어났어요. 테두리나 모서리만 집거나, 물체 옆이나 위에서 닫히는 식이에요. 연구진은 병목을 '물체 대비 그리퍼의 미세한 3D 위치 추정'으로 봤어요. 또 집기 실패의 9.5%는 이미 비어 있는 그리퍼로 다음 동작을 시도한 경우였어요. 자기 상태를 잘못 믿고 진행하는 문제도 있다는 뜻이에요.
로봇 전용 모델(VLA)과 비교: 성공률과 속도의 맞교환
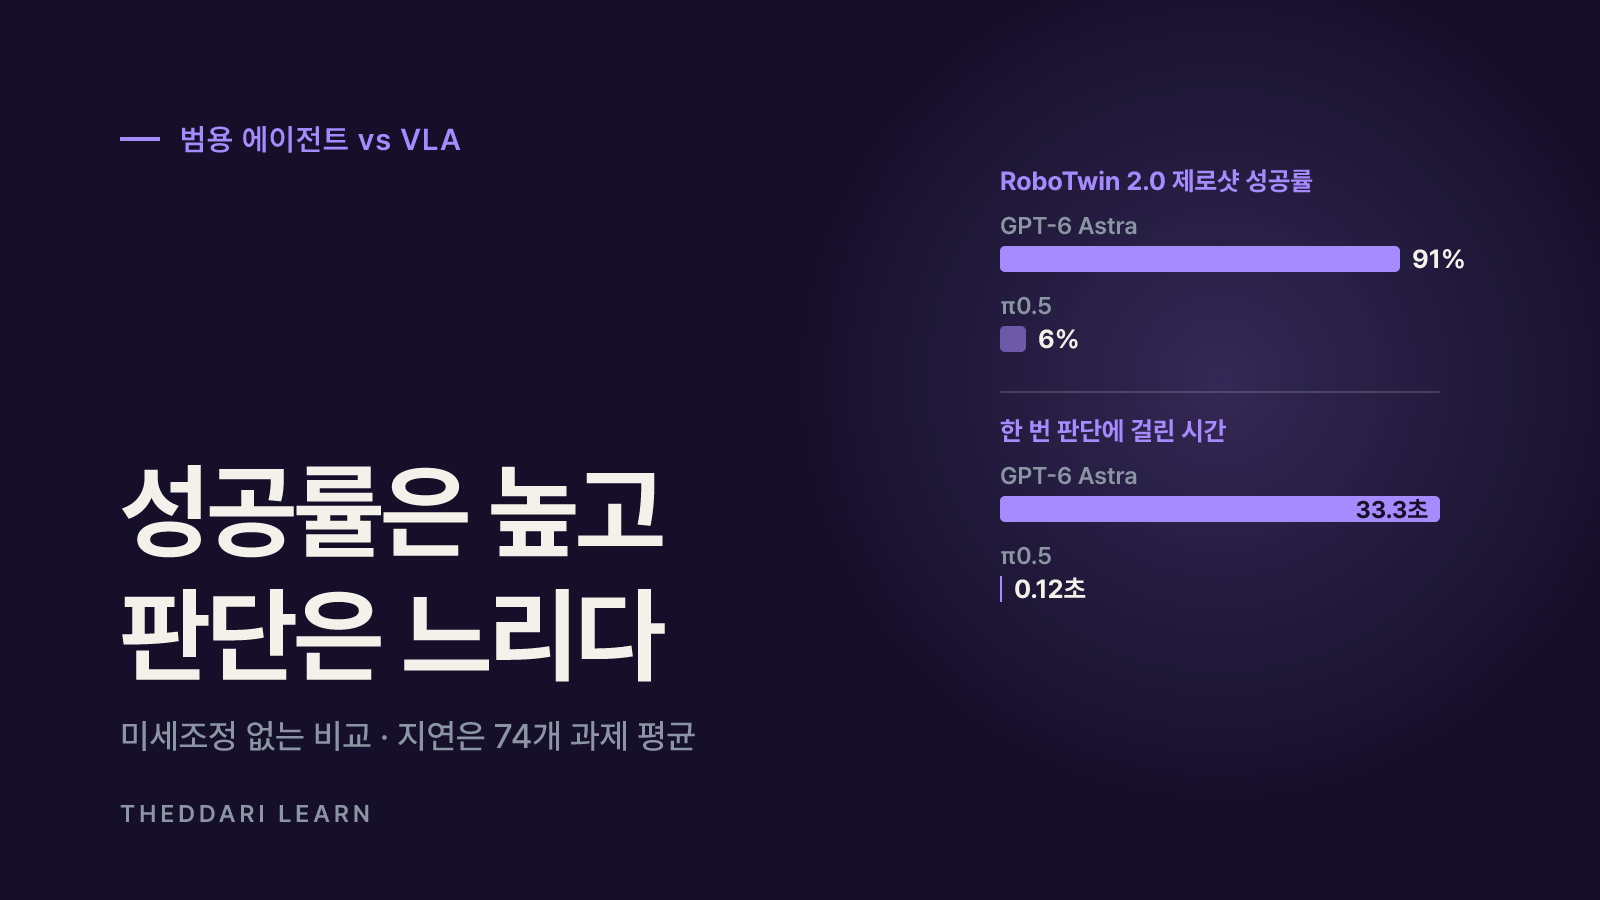
범용 에이전트 방식과 로봇 전용 VLA는 장단점이 뚜렷하게 갈려요. 아래 표는 논문과 프로젝트 페이지에 나온 조건과 수치를 기준으로 정리했어요.
제어 방식
- 프런티어 에이전트(GPT-6 Astra)
- 숫자 명령을 텍스트 도구 호출로 출력
- VLA(π0.5)
- 행동 헤드가 연속 동작을 직접 출력
RoboTwin 2.0 제로샷 성공률
- 프런티어 에이전트(GPT-6 Astra)
- 91%
- VLA(π0.5)
- 6%
YAMLab 제로샷 성공률
- 프런티어 에이전트(GPT-6 Astra)
- 90%
- VLA(π0.5)
- 0%
판단 지연(74개 과제 평균)
- 프런티어 에이전트(GPT-6 Astra)
- 33.3 ± 27.9초
- VLA(π0.5)
- 0.12 ± 0.02초
새 과제 적용
- 프런티어 에이전트(GPT-6 Astra)
- 과제별 미세조정 없이 시도
- VLA(π0.5)
- 보통 과제별 미세조정 필요
일반 대화·추론
- 프런티어 에이전트(GPT-6 Astra)
- 유지
- VLA(π0.5)
- 로봇 데이터 학습 시 저하 보고
지연 시간이 핵심 조건이에요. GPT-6 Astra는 한 턴에 명령 여러 개를 낼 수 있어 개별 간격의 중앙값은 0.17초였지만, 연구진이 실행 단위별 중앙값으로 정리한 평균은 33.3초였어요. 연구진도 프런티어 에이전트가 VLA보다 두 자릿수 이상 긴 판단 지연으로 제로샷 성공률을 얻는다고 적었어요. 움직이는 물체를 잡거나 사람 옆에서 즉시 반응해야 하는 작업에는 아직 맞지 않는 구조예요.
비교 대상 벤치마크가 두 개라는 점도 봐야 해요. 두 벤치마크 모두 GPT-6 Astra의 성공률이 높았던 곳이고, VLA를 미세조정한 상태와 비교한 결과가 아니에요.
이 연구를 읽을 때 확인할 한계
- 동료 심사 전 프리프린트예요. 2026년 11월 19일 v1이 올라왔고, 수치와 해석은 개정판에서 달라질 수 있어요.
- 정책과 채점자가 같은 모델이에요. 연구진은 자기 편향을 점검해 GPT-6 Astra가 사람 기준 실패 264건 중 19건(7.2%)만 '달성'으로 잘못 봤고, 다른 계열인 Claude Fable 5.2의 결과 정확도(78.25%)도 비슷했다고 밝혔어요. 그래도 사람 검증은 400개 표본에 한정돼요.
- 분석 대상 정책이 사실상 한 모델이에요. 다른 프런티어 모델이 로봇을 직접 조종할 때도 같은 실패 분포가 나온다는 보장은 없어요.
- 시뮬레이션 비중이 커요. 실제 로봇 책상 과제인 StationeryBench는 100개 에피소드 중 성공률이 7%였고, RoboDojo 전체 에피소드 성공률도 22%였어요. 벤치마크마다 성공률 편차가 커서 평균 하나로 능력을 말하기 어려워요.
- 채점자 자체의 오차가 있어요. 최고 채점자도 결과 판정 정확도가 80%에 못 미쳐서, 실패 유형 비율은 대략적인 경향으로 읽는 편이 안전해요.
연구자·실무자가 지금 확인할 순서
- 로봇 에이전트 데모를 볼 때 에피소드 성공률만 보지 말고 중간 실패와 복구 기록이 공개됐는지 확인해요.
- 과제가 집기 위주인지, 좁은 공차의 삽입·정렬이 필요한지 나눠 봐요. 이 연구 기준으로는 후자가 훨씬 어려워요.
- 판단 지연을 꼭 물어요. 수십 초 단위의 지연이 허용되는 작업인지가 범용 에이전트 방식을 쓸지 결정해요.
- 행동 단위 분석이 필요하면 공개된 12,844개 행동 데이터셋과 Muse-Glimmer-30B 채점자를 살펴봐요. 사람 라벨 기준 비용이 0.79달러로 GPT-6 Astra 채점(26.06달러)보다 30배 이상 저렴했지만 정확도는 더 낮았어요.
- 후속 연구와 업계 반응은 더따리 AI 텔레그램 트렌드와 블로그 트렌드에서 함께 확인해요.
정리하면 AgentRoboCritic은 '범용 AI 에이전트가 로봇 두뇌가 될 수 있느냐'에 대해 높은 의미 이해와 자기 복구라는 근거, 그리고 정밀한 물리 동작과 느린 판단이라는 분명한 병목을 함께 보여 줬어요. 앞으로 볼 지점은 집기·정렬 정확도를 높이는 방법과 판단 지연을 줄이는 구조예요.
자주 묻는 질문
AI 에이전트가 로봇을 직접 조종한다는 게 정확히 무슨 뜻인가요?
그럼 GPT-6 Astra가 로봇 전용 모델보다 낫다는 결론인가요?
로컬 의도(local intent)를 적게 하면 왜 평가가 정확해지나요?
이 연구로 가정용 로봇이 곧 나온다고 볼 수 있나요?
공개된 데이터셋과 채점 모델은 어디에 쓸 수 있나요?
출처·참고 자료
관련 글
 AI
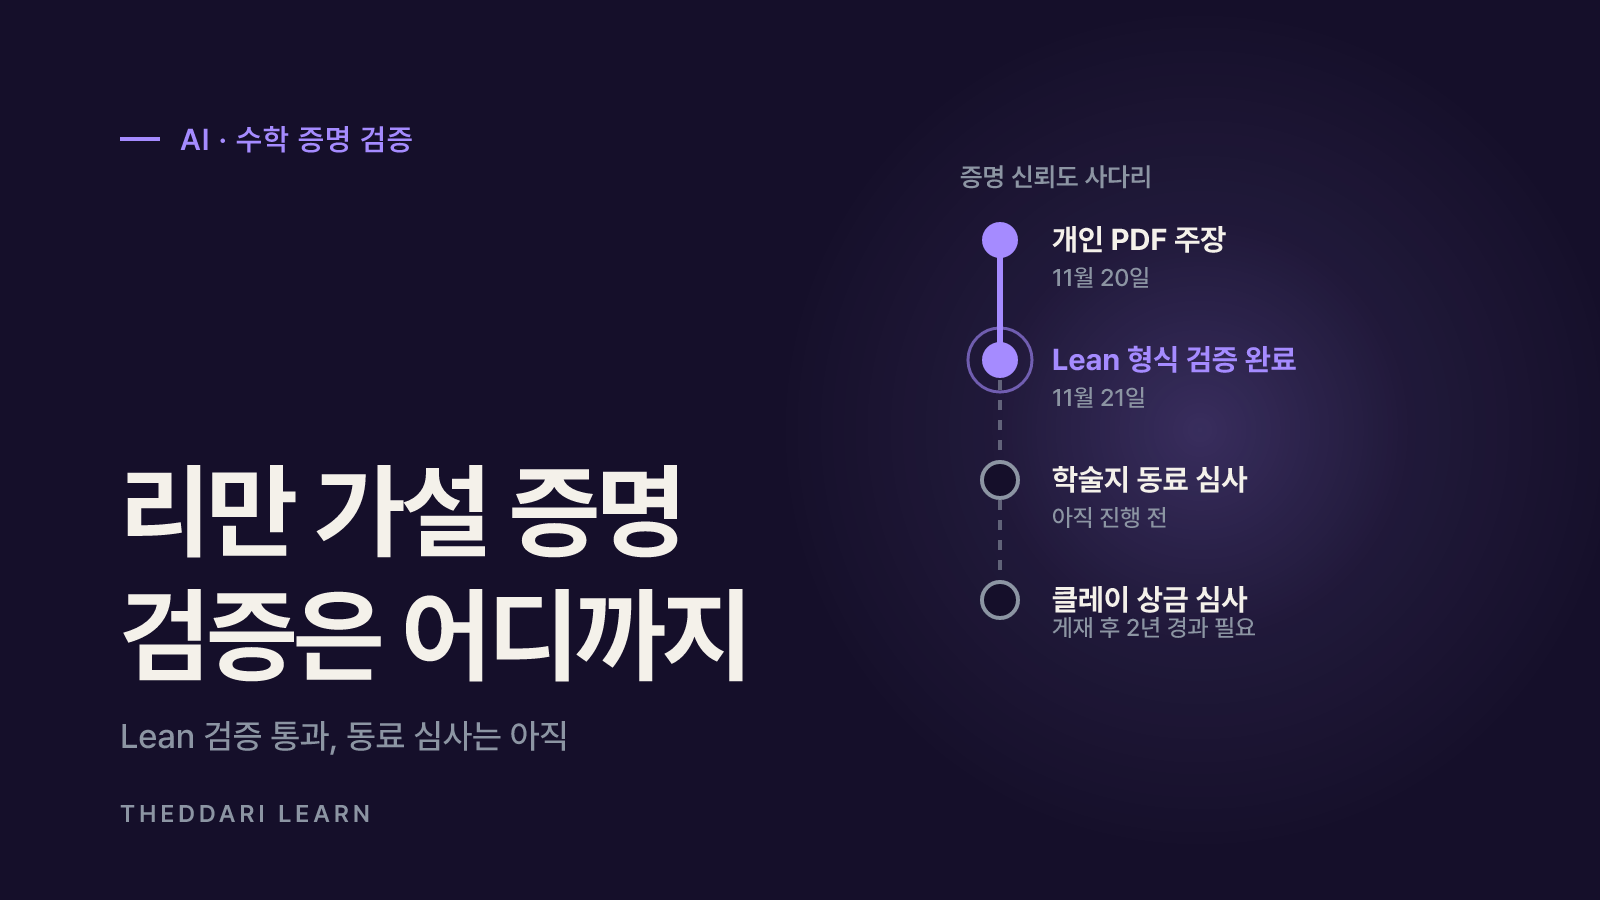
앤트로픽 리만 가설 증명, 사실일까? 수학 난제 증명 검증하는 법
2026년 11월 20일 앤트로픽 연구원 레벤트 알푀게가 Claude와 함께 리만 가설을 증명했다고 밝혔어요. 하루 만에 Lean 커뮤니티가 형식 검증을 인증했지만, 사람이 읽는 논문·동료 심사·클레이 상금 절차는 아직 남아 있어요. 증명 주장을 단계별로 확인하는 법을 정리했어요.
 AI
Inkling 2 Mini란? Inkling 2 Small 차이와 로컬 실행 전 확인할 점
Inkling 2 Mini는 씽킹 머신즈가 2026년 11월 20일 공개한 26.4B 파라미터 오픈 가중치 모델이에요. 약 20GB 체크포인트로 32GB 메모리 맥에서도 돌릴 수 있지만, 지식·지시 이행·한국어 품질은 Inkling 2 Small보다 약해요. 차이와 확인할 점을 공식 발표·모델 카드 기준으로 정리했어요.
 AI
Frostbite CPU란? AI가 설계·검증했다는 새 칩, 주장 확인할 점
AI가 ISA부터 RTL·검증·GDS까지 만들었다는 Frostbite CPU 발표를 읽는 법이에요. 무엇을 AI가 했다고 주장하는지, 4.59배 수치의 비교 대상과 조건, 아직 실리콘으로 확인되지 않은 부분을 나눠 봐요.