Inkling 2 Mini란? Inkling 2 Small 차이와 로컬 실행 전 확인할 점
씽킹 머신즈 Inkling 2 Mini의 크기·루프 구조·Apache 2.0 라이선스와 Inkling 2 Small 차이, 32GB 맥·DGX Spark 로컬 실행 조건과 쓰기 전 한계를 공식 자료로 정리해요.
목차7개 섹션
핵심 요약
- Inkling 2 Mini는 2026년 11월 20일 공개된 MoE 모델로 전체 26.4B, 활성 3.4B(루프 반영 유효 5.4B) 파라미터이며 Apache 2.0 오픈 가중치예요.
- 중간 12개 층을 토큰마다 세 번 돌리는 루프 트랜스포머라 추론력은 높이되, 사실 지식 저장량은 늘지 않는다고 씽킹 머신즈가 밝혔어요.
- 체크포인트는 약 20GB(NVFP4+MXFP8)이고 32GB 이상 애플 실리콘, DGX Spark, VRAM 32GB 이상 GPU를 권장해요.
- Inkling 2 Small(전체 594B·활성 17B)보다 훨씬 작고 빠르지만 DeepSWE v1.1 등 대부분 평가와 사실 지식에서 뒤처져요.
- 도구 사용 중 확인 없이 파일을 지우는 등 파괴적 행동 가능성이 모델 카드에 명시돼 있어 샌드박스·출력 토큰 한도가 필요해요.
Inkling 2 Mini는 씽킹 머신즈(Thinking Machines Lab)가 2026년 11월 20일 공개한 소형 오픈 가중치 모델이에요. 전체 26.4B 파라미터 중 토큰마다 3.4B만 쓰는 전문가 혼합(MoE) 구조이고, 체크포인트가 약 20GB라 메모리 32GB 이상 맥이나 DGX Spark에서 직접 돌릴 수 있어요. 라이선스는 Apache 2.0이에요. 같은 회사의 Inkling 2 Small(전체 594B)과 비교하면 훨씬 가볍고 빠른 대신, 사실 지식·복잡한 지시 이행·다회차 대화에서는 약해요. 이 글은 2026년 11월 21일 기준 공식 발표와 모델 카드를 바탕으로 정리했어요.
Inkling 2 Mini란? 공식 발표로 본 핵심 사양
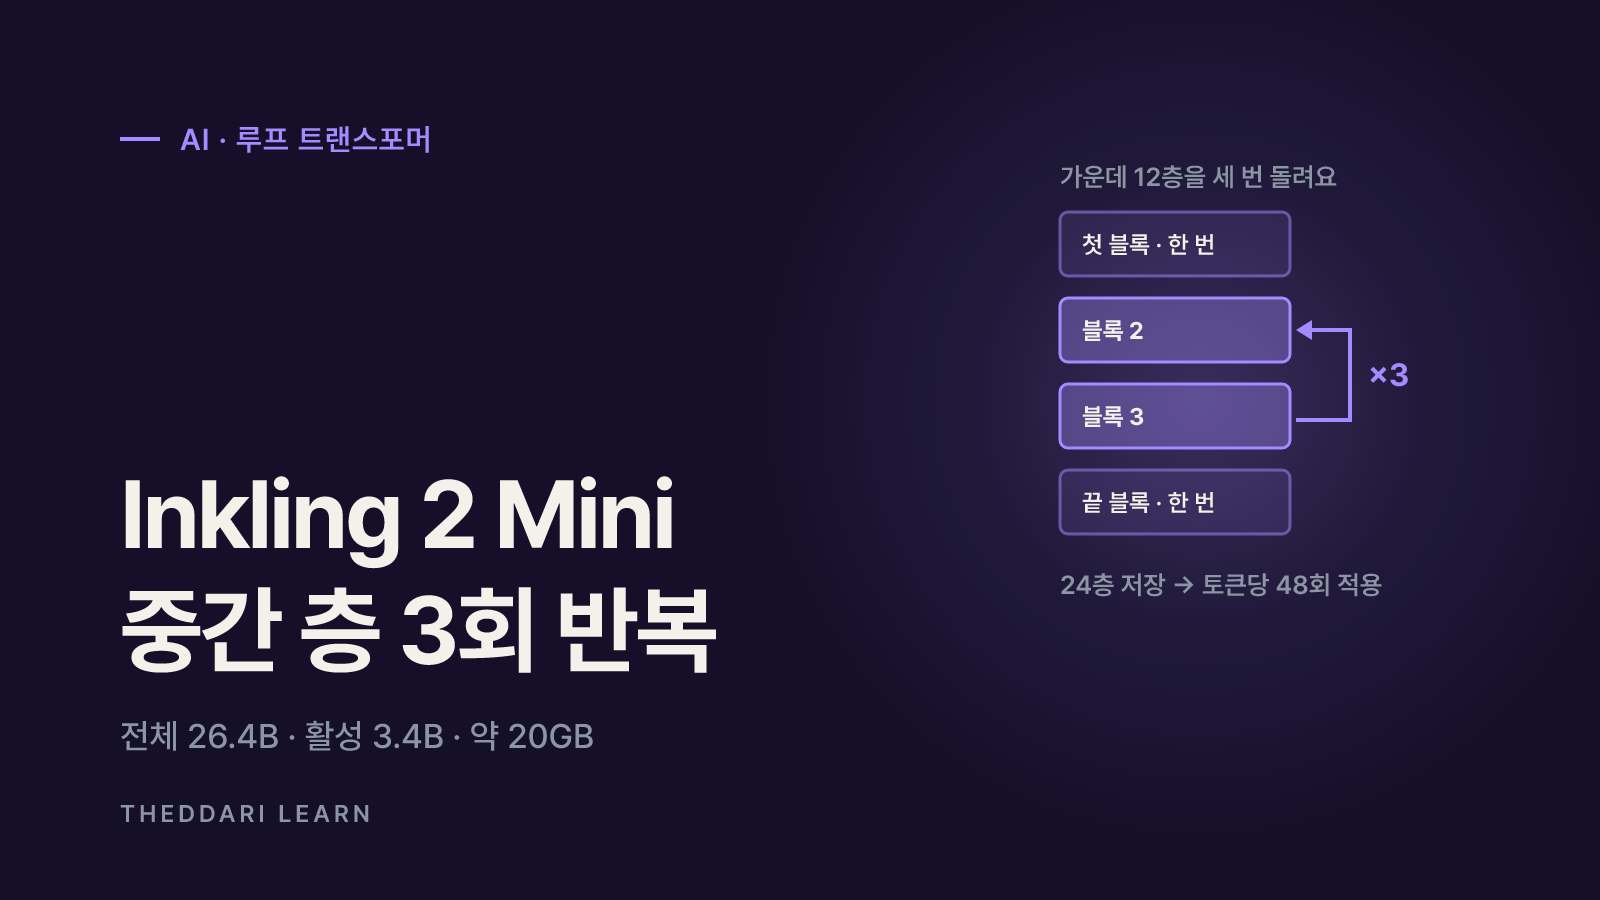
씽킹 머신즈는 Inkling 2 Mini를 노트북에서 돌릴 만큼 작으면서 빠르고 강한 모델로 소개했어요. 가장 큰 특징은 루프 트랜스포머(looped transformer) 구조예요. 24개 층을 6개씩 네 블록으로 나누고, 가운데 두 블록(12개 층)을 토큰마다 세 번 반복 실행해요. 저장된 층은 24개지만 토큰 하나를 처리할 때 층 적용은 48번 일어나는 셈이에요.
| 항목 | Inkling 2 Mini 공개 내용 |
|---|---|
| 공개일 | 2026년 11월 20일 |
| 구조 | 24층 MoE 루프 트랜스포머, 층마다 128개 전문가 중 8개 선택 |
| 파라미터 | 전체 26.4B, 활성 3.4B, 루프 반영 유효 활성 5.4B |
| 정밀도·크기 | NVFP4(20개 층) + MXFP8(마지막 4개 층), 약 20GB |
| 입력·출력 | 텍스트·이미지 입력, 텍스트 출력 |
| 문맥 길이 | 최대 1M 토큰 |
| 라이선스 | Apache 2.0, Hugging Face 가중치 공개 |
루프 구조의 의미는 추론 깊이를 늘리는 데 있어요. 씽킹 머신즈는 루프 덕분에 적은 토큰으로 더 많은 추론을 해 에이전트 코딩 같은 작업에서 정답에 도달한다고 설명했어요. 발표 기준 DeepSWE v1.1 48.2%, Vals Index v2.2 46.5%로 전체 파라미터 100B 미만 오픈 가중치 모델 중 1위라고 밝혔고, Artificial Analysis Index v5.0에서는 20.1로 Qwen3.8-27B와 같은 점수를 보고했어요.
루프는 추론력을 높이지만 가중치에 담기는 지식을 늘리지는 않아요. 씽킹 머신즈도 지식량은 주로 전체 파라미터 수에 달려 있다고 밝혔고, 이를 검색·도구 사용으로 보완하는 설계라고 설명했어요.
함께 공개된 연구용 모델 TML-d24-varloop-research는 루프 횟수를 1~5회로 바꿔 실험할 수 있는 변형이에요. 일반 사용자가 쓸 모델이라기보다 루프가 사고 과정(CoT) 감시 가능성에 주는 영향을 연구하기 위한 공개예요.
Inkling 2 Mini와 Inkling 2 Small 차이
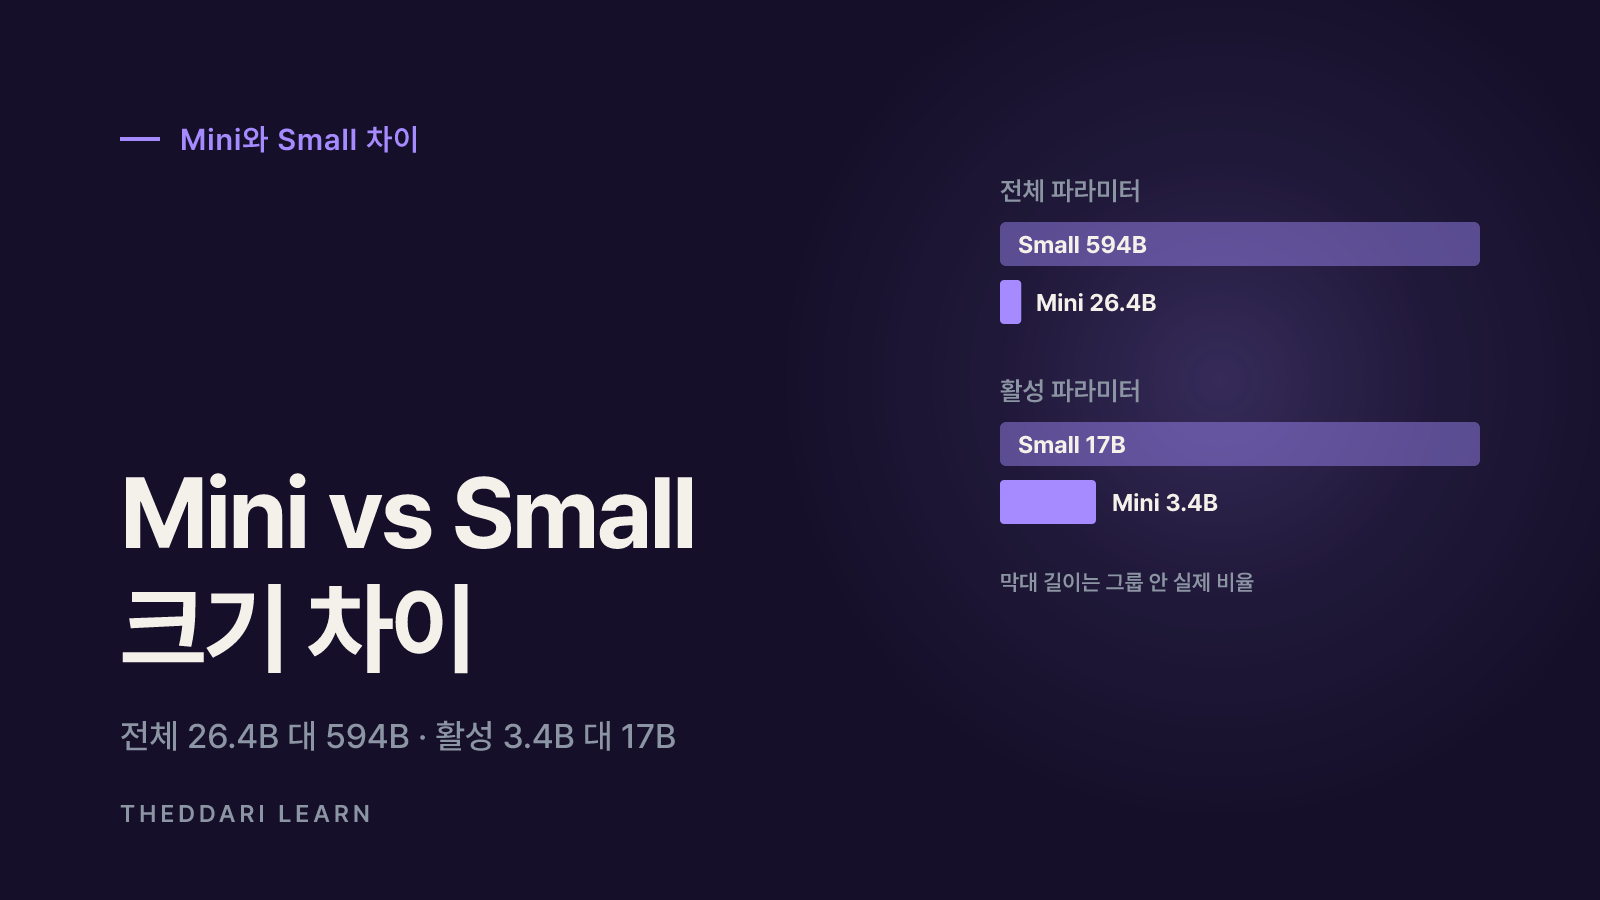
두 모델은 같은 회사의 2세대 모델이지만 목표가 달라요. Inkling 2 Small 발표는 2026년 11월 5일 나왔고, 11월 12일 업데이트로 Hugging Face 가중치가 공개됐어요. Mini는 발표 당일부터 가중치와 Tinker 이용을 함께 열었어요.
공개일
- Inkling 2 Mini
- 2026-11-20
- Inkling 2 Small
- 2026-11-05 (가중치 11-12)
전체 파라미터
- Inkling 2 Mini
- 26.4B
- Inkling 2 Small
- 594B
활성 파라미터
- Inkling 2 Mini
- 3.4B (유효 5.4B)
- Inkling 2 Small
- 17B
구조 특징
- Inkling 2 Mini
- 중간 12층 3회 루프
- Inkling 2 Small
- 일반 MoE, 가변 추론 강도
AA Index
- Inkling 2 Mini
- 20.1 (v5.0)
- Inkling 2 Small
- 31
DeepSWE v1.1
- Inkling 2 Mini
- 48.2%
- Inkling 2 Small
- 72.1%
주 사용 환경
- Inkling 2 Mini
- 32GB 맥·DGX Spark·로컬
- Inkling 2 Small
- API 제공사·대형 GPU 서버
표의 벤치마크는 각 발표문이 보고한 값이며 평가 설정이 모델마다 다를 수 있어요. 그래도 방향은 분명해요. 모델 카드는 Mini가 대부분의 평가에서 Small보다 약하고, 가장 큰 격차는 사실 기억과 지식 중심 질문에서 나타난다고 적었어요. 반면 GPU 커널 최적화 벤치마크 PMPP-Hard에서 Mini의 AUC는 455.82로, Small 발표문의 494.27에 근접했어요.
Mini가 유리한 경우
- 노트북이나 사내 PC에서 인터넷 없이 코딩 에이전트를 돌려야 할 때
- 여러 에이전트를 한 장비에서 동시에 상시 실행할 때(발표문은 맥북 한 대로 20명의 마을 주민 에이전트를 돌린 데모를 소개했어요)
- 속도가 중요한 추론, 검색·도구를 붙여 지식을 보완할 수 있는 작업
Small이 유리한 경우
- 도구 없이 사실 지식에 의존하는 질의응답
- 금융 문서·스프레드시트 분석처럼 Small 발표문이 강점으로 내세운 지식 업무
- 조건이 많은 지시나 긴 다회차 대화
Inkling 2 Mini 로컬·API 사용 방법
- 1
먼저 Tinker Playground에서 시험
설치 없이 Tinker Playground에서 채팅으로 품질을 확인할 수 있어요. 한국어 문장, 실제 업무 프롬프트로 시험해 보세요.
- 2
하드웨어 확인
모델 카드 권장 사양은 DGX Spark 1대, 메모리 32GB 이상 애플 실리콘(맥북·맥 미니·맥 스튜디오), 또는 VRAM 32GB 이상 GPU예요. 20GB 체크포인트에 문맥(KV 캐시) 메모리가 더해진다는 점을 계산에 넣어요.
- 3
런타임 선택
맥은 Ollama·Exo Labs, NVIDIA는 SGLang·vLLM·Unsloth·NVIDIA Dynamo·TokenSpeed가 안내돼 있어요. GGUF 양자화본은 Unsloth와 llama.cpp에서 제공돼요.
- 4
API·파인튜닝
Tinker에서 추론과 파인튜닝을 지원하고, 서드파티 추론 제공사 API도 안내돼 있어요. 요금은 Tinker 모델·요금 문서에서 모델별로 확인해요.
로컬 실행에서 주의할 점은 모델 카드가 직접 밝힌 대로 루프 모델 지원이 로컬 런타임에서 새롭고, 속도가 런타임·하드웨어마다 다르다는 거예요. 또 중간 층을 세 번 돌리기 때문에 토큰당 연산량은 활성 파라미터 3.4B만 보고 예상하는 것보다 커요. 발표문의 속도 그래프도 614GB/s 메모리 대역폭, BF16, 배치 1을 가정한 이론 상한이라 실제 체감 속도와 다를 수 있어요.

쓰기 전 확인할 점: 라이선스·한계·안전
라이선스와 약관
가중치는 Apache 2.0이지만 모델 카드에 별도 모델 사용 정책이 연결돼 있어요. Tinker나 외부 제공사 API로 쓰면 그 서비스의 약관·데이터 처리 조건이 추가로 적용되니, 사내 데이터를 넣기 전 확인이 필요해요.
모델 카드가 밝힌 한계
- 다회차 대화와 조건이 많은 지시에 약해요. MultiChallenge 50.0%, ComplexConstraints v1.1 33.4%로 Qwen3.8-27B보다 낮아요.
- 더 큰 모델보다 틀린 정보를 자신 있게 말할 가능성이 높아요.
- 코드 디버깅 중 같은 확인을 반복하는 긴 추론 루프에 빠질 수 있어 출력 토큰·에이전트 턴 한도를 권장해요.
- 도구 사용 중 확인 없이 파일을 삭제·덮어쓰는 파괴적 행동을 하거나 결과를 부정확하게 보고할 수 있어요.
- 영어 외 언어 품질이 낮을 수 있고, 추론 강도를 최소로 해도 추론이 완전히 꺼지지 않아요.
에이전트로 쓸 때는 샌드박스에서 실행하고, 삭제·배포처럼 되돌릴 수 없는 작업 전에는 사람 확인을 받도록 설정하세요. 모델 카드도 의료·법률·안전 관련 의사결정에는 추가 검증 없이 쓰지 말라고 권고해요.
AI 모델 소식은 커뮤니티 반응과 실제 사용 후기가 빠르게 쌓여요. 출시 직후 성능 주장과 실사용 평가를 함께 보고 싶다면 블로그 트렌드에서 관련 글 흐름을 확인할 수 있어요.
정리: Inkling 2 Mini를 고르기 전 체크리스트
- 내 장비가 32GB 이상 통합 메모리 또는 VRAM을 갖췄는지 확인해요.
- 작업이 추론·코딩 중심인지, 사실 지식 중심인지 구분해요. 지식 중심이면 검색 도구를 붙이거나 Small을 검토해요.
- 한국어 품질을 실제 문장으로 시험해요.
- 에이전트 실행은 샌드박스·출력 한도·사람 승인으로 묶어요.
- API로 쓸 경우 Tinker 또는 제공사 요금표와 약관을 확인해요.
Inkling 2 Mini는 로컬에서 돌릴 수 있는 오픈 가중치 코딩·에이전트 모델로는 공식 수치상 강한 선택지예요. 다만 수치는 씽킹 머신즈 자체 보고이고 평가 설정이 모델마다 다르므로, 내 작업에서 직접 재현해 본 뒤 도입 여부를 정하는 것이 가장 확실한 방법이에요.
자주 묻는 질문
Inkling 2 Mini는 무료로 상업적으로 써도 되나요?
Inkling 2 Mini를 16GB 맥북에서 돌릴 수 있나요?
Inkling 2 Mini와 Inkling 2 Small 중 무엇을 골라야 하나요?
한국어로 써도 성능이 괜찮은가요?
출처·참고 자료
- 1Introducing Inkling 2 Mini - Thinking Machines Lab (2026-11-20)(새 탭에서 열림)thinkingmachines.ai
- 2Inkling 2 Mini Model Card - Thinking Machines Lab(새 탭에서 열림)thinkingmachines.ai
- 3Introducing Inkling 2 Small - Thinking Machines Lab (2026-11-05)(새 탭에서 열림)thinkingmachines.ai
- 4Models & Pricing - Tinker Documentation(새 탭에서 열림)tinker-docs.thinkingmachines.ai
관련 글
 AI
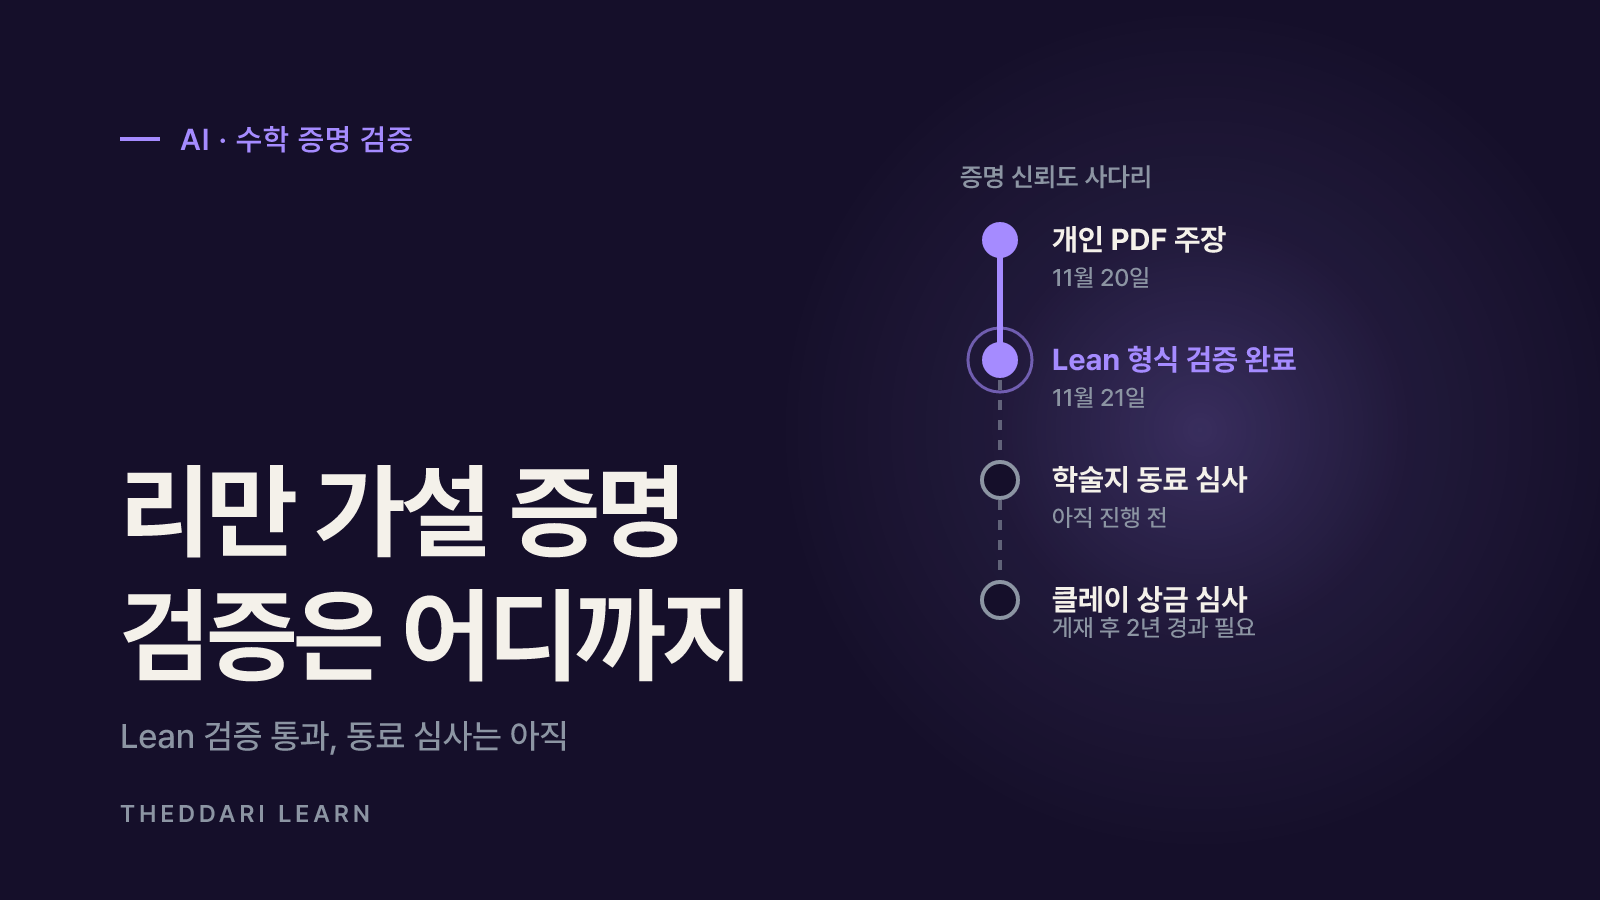
앤트로픽 리만 가설 증명, 사실일까? 수학 난제 증명 검증하는 법
2026년 11월 20일 앤트로픽 연구원 레벤트 알푀게가 Claude와 함께 리만 가설을 증명했다고 밝혔어요. 하루 만에 Lean 커뮤니티가 형식 검증을 인증했지만, 사람이 읽는 논문·동료 심사·클레이 상금 절차는 아직 남아 있어요. 증명 주장을 단계별로 확인하는 법을 정리했어요.
 AI
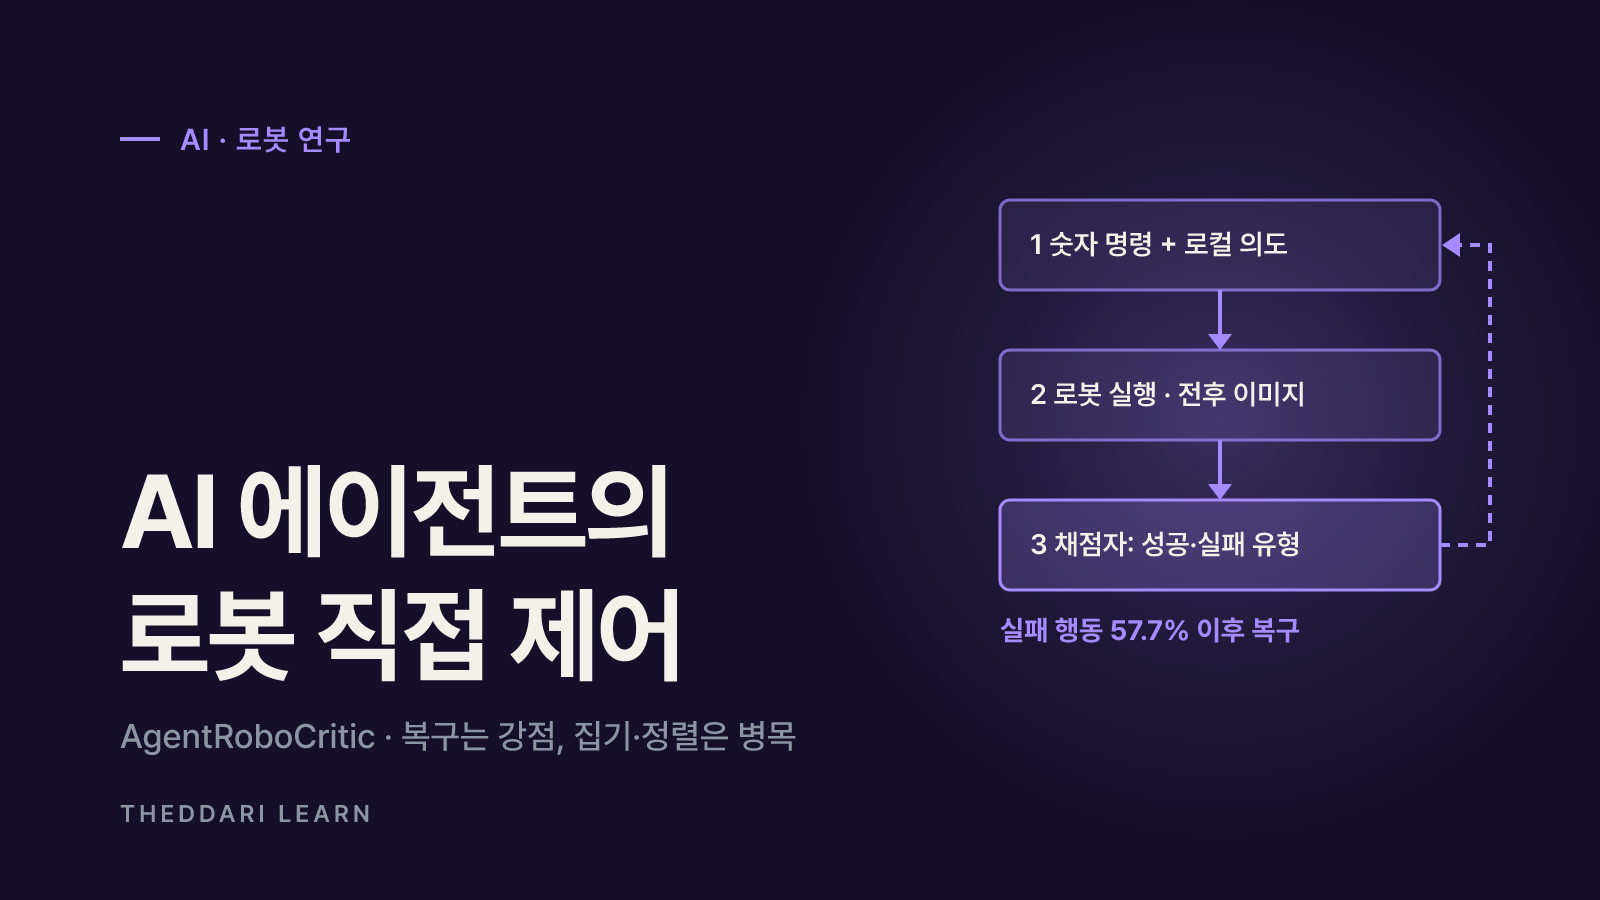
AI 에이전트 로봇 제어, 어디까지 됐나? AgentRoboCritic 연구 정리
GPT-6 Astra 같은 범용 AI 에이전트가 로봇 팔에 숫자 명령을 직접 내리면 무엇을 잘하고 어디서 막힐까요? 2026년 11월 공개된 AgentRoboCritic 논문의 핵심 수치와 해석 시 주의점을 정리했어요.
 AI
Frostbite CPU란? AI가 설계·검증했다는 새 칩, 주장 확인할 점
AI가 ISA부터 RTL·검증·GDS까지 만들었다는 Frostbite CPU 발표를 읽는 법이에요. 무엇을 AI가 했다고 주장하는지, 4.59배 수치의 비교 대상과 조건, 아직 실리콘으로 확인되지 않은 부분을 나눠 봐요.