긴 문맥 AI는 왜 비쌀까? 서브쿼드라틱 어텐션과 비용 줄이는 법
긴 문맥 AI가 비싼 이유를 어텐션 연산량의 제곱 증가로 풀고, 2026년 10월 공개된 서브쿼드라틱 어텐션 논문 LSA·ZHA의 아이디어와 한계, 지금 쓸 수 있는 롱컨텍스트 비용 절감법을 정리해요.
목차8개 섹션
핵심 요약
- 일반(전체) 어텐션은 모든 토큰 쌍을 비교하므로 연산량과 메모리가 문맥 길이의 제곱에 비례해 늘어나요.
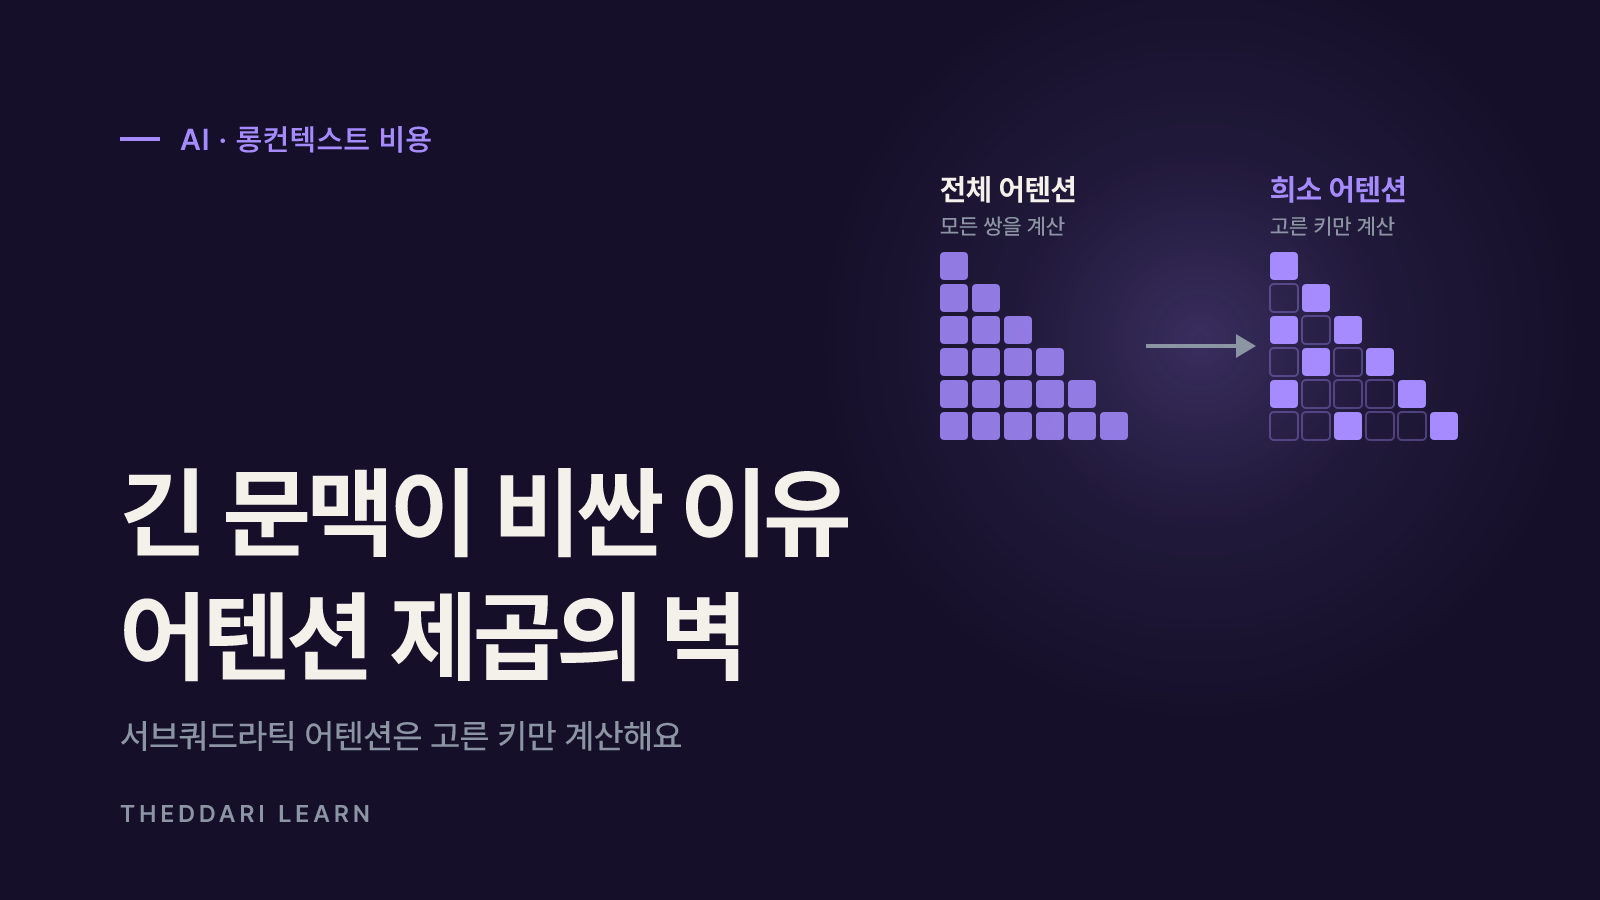
- 서브쿼드라틱 어텐션은 쿼리마다 일부 키만 골라 계산해 증가 속도를 제곱보다 낮추려는 접근이에요. 핵심은 '어떤 키를 고를지' 정하는 인덱서 비용까지 줄이는 거예요.
- 2026년 10월 30일 arXiv에 올라온 LSA·ZHA 논문은 계층형 클러스터·트리 인덱서로 100만 토큰 이상에서 큰 속도 향상을 보고했지만, 동료 평가 전 사전 공개본이에요.
- API 사용자는 연산량을 직접 내지 않고 토큰 단가로 내요. 일부 모델은 특정 길이를 넘으면 단가가 올라가므로 임계값 확인·프롬프트 캐싱·배치 처리·문맥 다이어트가 당장 효과적인 절감법이에요.
긴 문맥 AI가 비싼 가장 큰 이유는 트랜스포머의 일반 어텐션이 모든 토큰 쌍을 서로 비교하기 때문이에요. 문맥이 2배 길어지면 비교할 쌍은 4배, 10배 길어지면 100배가 돼요. 서브쿼드라틱 어텐션은 이 '제곱의 벽'을 낮추려고 쿼리마다 일부 키만 골라 계산하는 연구 흐름이에요. 이 글은 2026년 11월 3일에 확인한 arXiv 논문 두 편(2026년 10월 30일 제출)과 Anthropic·OpenAI의 공식 가격 문서를 근거로, 원리와 최신 연구가 주장하는 것, 그리고 사용자가 지금 롱컨텍스트 비용을 줄이는 방법을 정리해요.
긴 문맥 AI가 비싼 이유: 어텐션 연산량은 길이의 제곱이에요
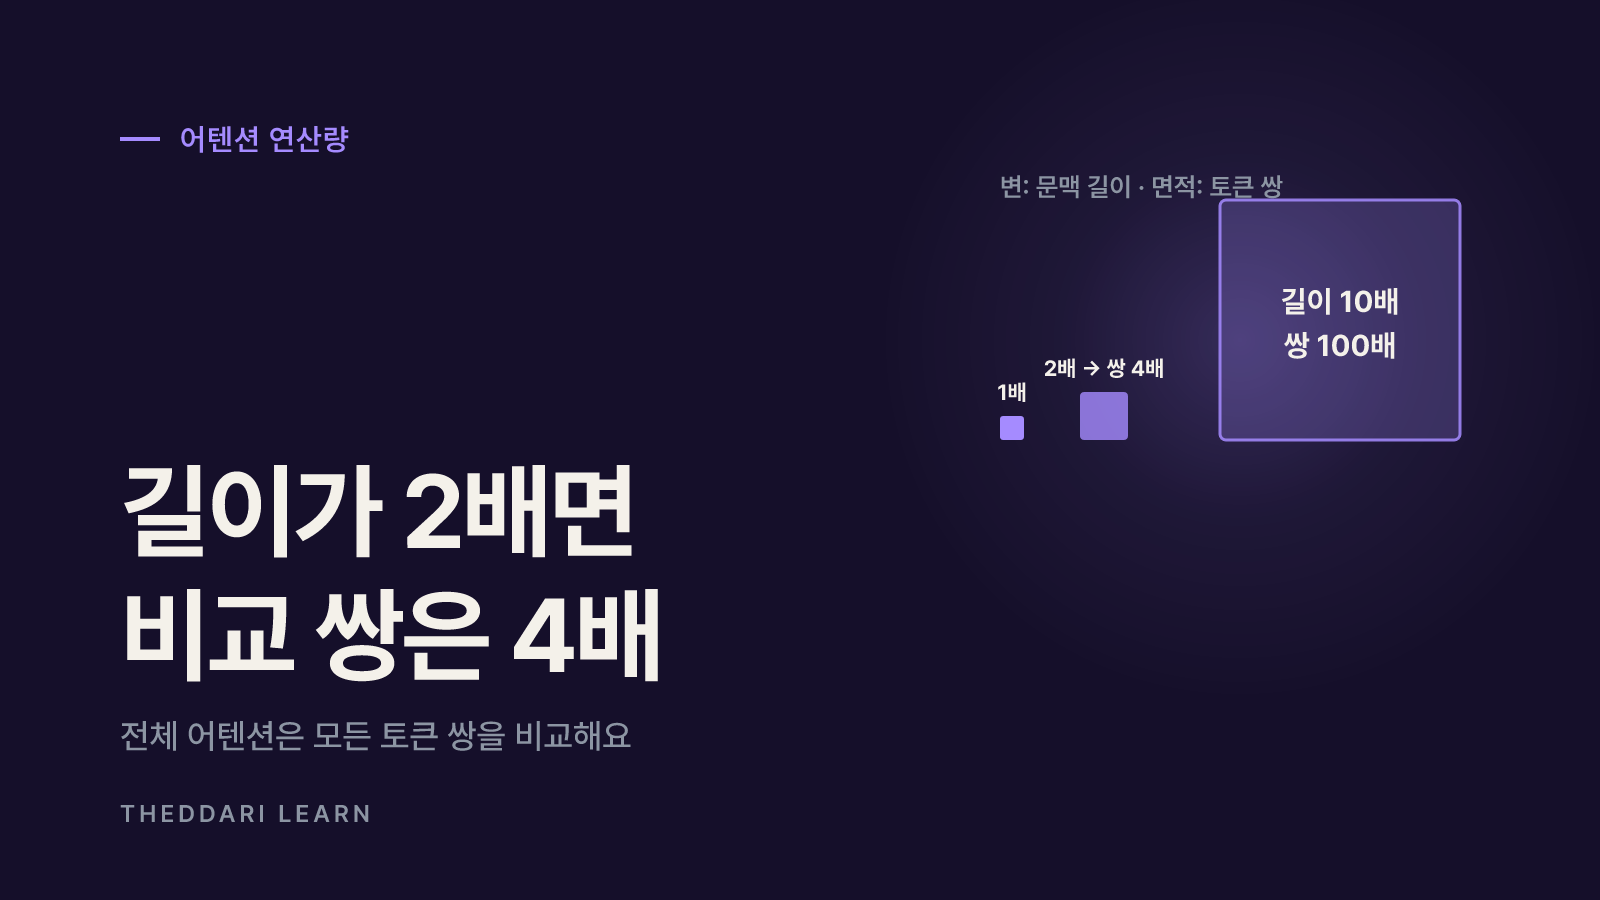
대형 언어 모델(LLM)은 문장을 토큰 단위로 처리해요. 어텐션 층에서 각 토큰은 '쿼리'가 되어 앞선 모든 토큰의 '키'와 얼마나 관련 있는지 점수를 매기고, 그 점수로 '값'을 섞어 다음 표현을 만들어요. 토큰이 n개라면 점수를 매길 쌍은 대략 n×n개예요. 그래서 FlashAttention 논문도 초록에서 셀프 어텐션의 시간·메모리 복잡도가 시퀀스 길이의 제곱이라 긴 시퀀스에서 느리고 메모리를 많이 쓴다고 설명해요(arXiv 2205.14135).
1배
- 비교할 토큰 쌍(전체 어텐션)
- 1배
- 증가 방식
- 기준
2배
- 비교할 토큰 쌍(전체 어텐션)
- 4배
- 증가 방식
- 제곱
10배
- 비교할 토큰 쌍(전체 어텐션)
- 100배
- 증가 방식
- 제곱
100배
- 비교할 토큰 쌍(전체 어텐션)
- 1만 배
- 증가 방식
- 제곱
위 표는 개념 계산이에요. 실제 모델에서는 어텐션 외에도 피드포워드 층처럼 길이에 비례해 늘어나는 연산이 있어서 전체 비용이 정확히 제곱으로 늘지는 않아요. 다만 문맥이 수십만~수백만 토큰으로 커지면 어텐션 몫이 압도적으로 커져요. LSA 논문은 100만 토큰을 넘는 초장문맥에서 전체 어텐션이 '감당하기 어려울 만큼 비싸다'고 표현해요(arXiv 2610.42147).
프리필과 디코드, 그리고 KV 캐시
사용자가 체감하는 비용은 두 단계로 나눠 보면 이해가 쉬워요. 프리필(prefill)은 입력 프롬프트 전체를 한 번에 읽는 단계로, 긴 문서를 붙여 넣었을 때 첫 글자가 나오기까지 기다리는 시간이 여기서 생겨요. 디코드(decode)는 답변을 한 토큰씩 생성하는 단계로, 새 토큰 하나가 앞선 모든 토큰을 다시 참조해요. 이때 이미 계산한 키·값을 저장해 두는 것이 KV 캐시인데, 문맥이 길수록 KV 캐시가 GPU 메모리를 많이 차지해 한 GPU가 동시에 처리할 수 있는 요청 수가 줄어요. 결국 같은 하드웨어로 처리할 수 있는 사용자 수가 줄어드는 것이 제공사 입장의 비용이에요.
서브쿼드라틱 어텐션이란? 희소·계층형 인덱서의 아이디어
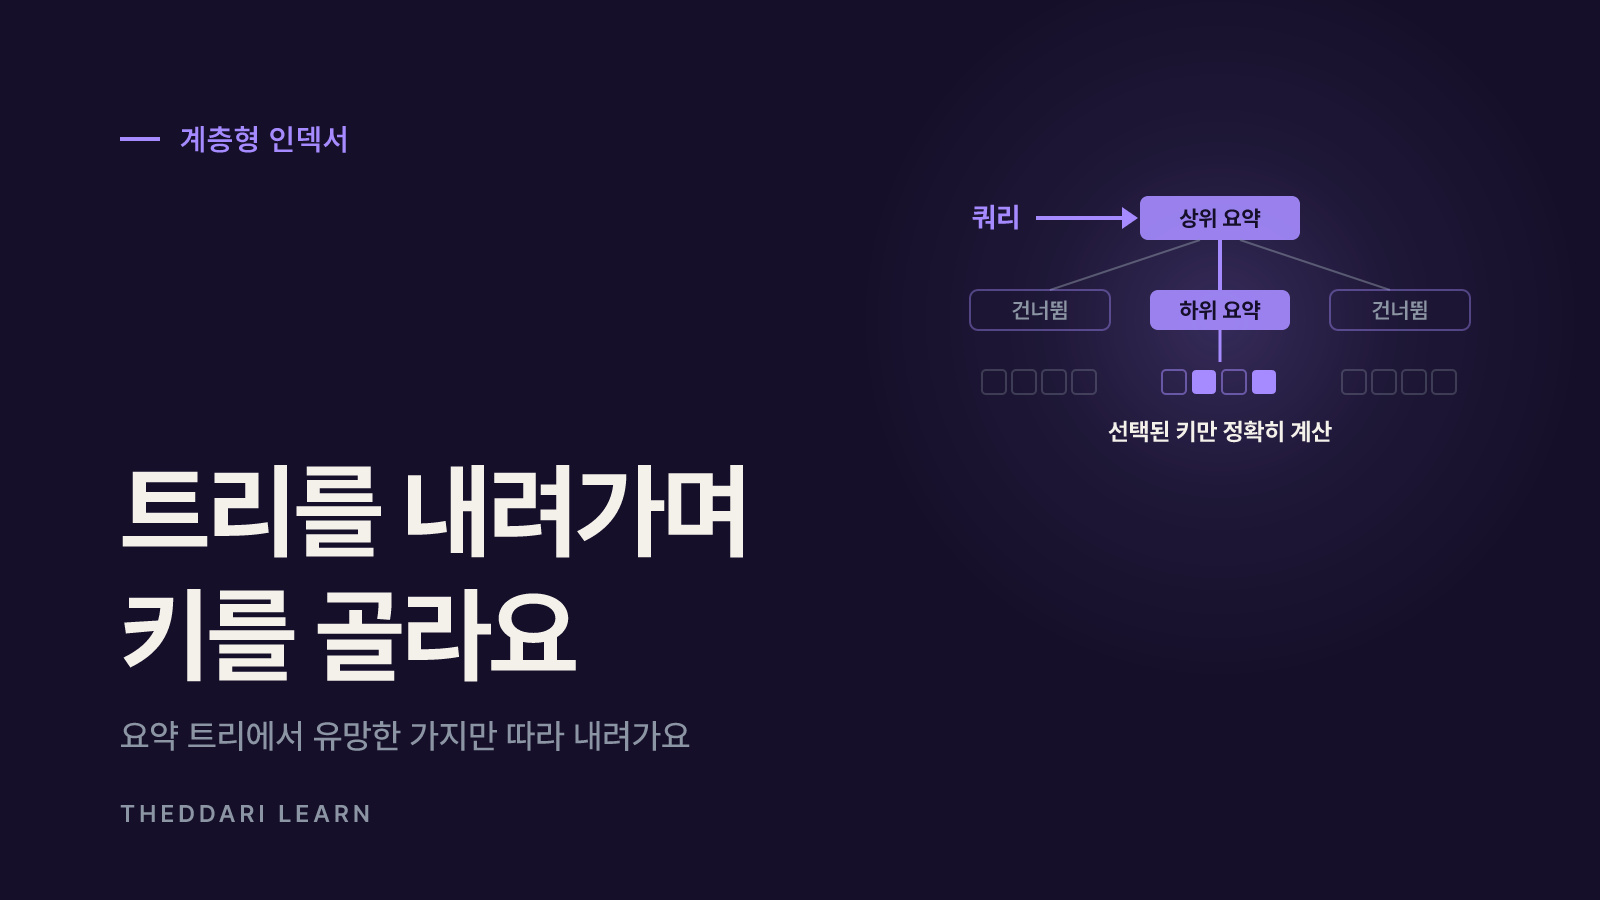
서브쿼드라틱 어텐션은 연산량이 문맥 길이의 제곱보다 느리게 늘어나는 어텐션 방법을 통틀어 부르는 말이에요. 대표적인 방향은 희소 어텐션이에요. 쿼리가 모든 키를 보지 않고 관련 있어 보이는 일부 키만 골라 정확한 어텐션을 계산해요. 문제는 '어떤 키가 관련 있는지'를 고르는 인덱서 자체가 모든 키를 훑으면 여전히 제곱 비용이 든다는 점이에요. ZHA 논문은 기존 접근을 두 부류로 나눠 비판해요. 슬라이딩 윈도우나 고정 크기 상태를 쓰는 선형 어텐션은 표현력이 부족하고, 인덱서가 제곱으로 늘어나는 희소 어텐션은 상수배 속도 향상에 그친다는 거예요(arXiv 2610.42112).
전체 어텐션
- 핵심 아이디어
- 모든 키와 비교
- 길이에 따른 증가
- 제곱
- 주의할 점
- 정확하지만 초장문맥에서 비쌈
FlashAttention
- 핵심 아이디어
- 같은 계산을 메모리 효율적으로
- 길이에 따른 증가
- 제곱(연산 쌍 수는 동일)
- 주의할 점
- 결과는 정확, 증가 속도 자체는 그대로
슬라이딩 윈도우·선형 어텐션
- 핵심 아이디어
- 가까운 토큰만 보거나 고정 크기 상태로 요약
- 길이에 따른 증가
- 대체로 선형
- 주의할 점
- 먼 정보를 놓치거나 표현력이 제한될 수 있음
희소 어텐션(평면 인덱서)
- 핵심 아이디어
- 인덱서가 일부 키를 선택
- 길이에 따른 증가
- 인덱서가 제곱이면 상수배 개선
- 주의할 점
- 인덱서 비용이 병목으로 남음
계층형 인덱서(LSA·ZHA)
- 핵심 아이디어
- 키를 클러스터·트리로 묶어 위에서부터 탐색
- 길이에 따른 증가
- 제곱보다 느림(논문 주장)
- 주의할 점
- 사전 공개본, 재현·실서비스 검증 필요
계층형 인덱서의 직관은 도서관 분류와 비슷해요. 책 한 권 한 권을 다 뒤지는 대신 대분류 → 중분류 → 서가 순으로 내려가면 확인할 후보가 크게 줄어요. 키를 요약 단위로 묶어 두고 쿼리가 상위 요약부터 점수를 매긴 뒤 유망한 가지만 따라 내려가면, 모든 키를 하나씩 채점하지 않아도 돼요. 이렇게 고른 일부 키에만 정확한 어텐션을 적용하는 것이 두 논문의 공통 구조예요.
최신 논문 두 편이 주장하는 것: LSA와 ZHA
Latent Sparse Attention(LSA)
LSA는 키를 학습된 잠재 공간에서 계층적으로 클러스터링하고, 쿼리가 모든 키 대신 클러스터 계층에 점수를 매기도록 해요. 그 결과 프리필·디코드·학습이 모두 긴 문맥에서 빨라진다고 주장해요. 기존 사전학습 모델에 증류로 붙이는 D-LSA와, 다음 토큰 예측 손실만으로 처음부터 학습하는 N-LSA 두 가지 변형을 제안했어요. 초록에 따르면 1,000만 토큰 문맥에서 D-LSA는 어텐션 층 하나 기준으로 GLM-5.3-FLASH의 기존 희소 어텐션 대비 프리필 22.7배·디코드 4.6배, QWEN-3.8-27B의 전체 어텐션 대비 프리필 72.4배·디코드 42.5배 빨랐고 여러 과제에서 비슷한 정확도를 유지했다고 해요. N-LSA는 12만 8천(128k) 토큰에서 층당 학습 속도 1.6배로 전체 어텐션과 같은 정확도를 냈다고 보고했어요(arXiv 2610.42147).
Zyphra Hierarchical Attention(ZHA)
ZHA는 KV 캐시 위에 키 요약을 재귀적으로 압축한 트리를 만들고, 이후 쿼리가 위에서 아래로 트리를 따라가 희소한 키 부분집합을 가져와요. 문맥이 길어질수록 트리 깊이를 늘리면 라우팅과 최종 어텐션을 합친 쿼리당 비용이 길이보다 느리게 늘고, 그래서 전체는 '제곱보다 느리지만 선형보다는 빠른' 증가를 보인다고 설명해요. 기존 사전학습 모델에 수십억 토큰 규모의 짧은 KL 증류 단계만으로 적용할 수 있고, 장문 검색·추론·수학·에이전트 코딩 평가에서 성능을 유지했으며 6단계 깊이 트리에서도 견고했다고 해요. 성능 모델 분석으로는 100만 토큰 이상에서 경쟁 방법을 크게 앞서고, 장기적으로 유효 문맥을 수억~수십억 토큰까지 늘릴 잠재력이 있다고 주장해요(arXiv 2610.42112).
두 논문 모두 2026년 10월 30일 arXiv에 제출된 v1 사전 공개본이에요. 동료 평가·독립 재현을 거치지 않았고, 속도 수치는 '어텐션 층 하나' 또는 성능 모델 기준이라 모델 전체의 응답 속도나 요금 변화로 그대로 옮길 수 없어요.
이런 연구 흐름을 계속 따라가고 싶다면 더따리의 AI 텔레그램 트렌드와 블로그 트렌드에서 새 모델·논문이 언급되는 흐름을 확인할 수 있어요. 다만 화제성이 곧 검증된 성능을 뜻하지는 않으니 원문 초록과 평가 범위를 함께 읽는 습관이 중요해요.

사용자가 체감하는 롱컨텍스트 비용: API 요금은 이렇게 매겨져요
API 사용자는 어텐션 연산량을 직접 내지 않고 토큰 수 × 토큰 단가로 요금을 내요. 그래서 청구서에서는 길이에 '비례해' 늘어나는 것처럼 보이지만, 제공사는 제곱으로 늘어나는 계산과 메모리 부담을 단가 정책에 반영해요. 2026년 11월 3일 확인한 공식 문서 기준으로 정책은 크게 두 갈래예요.
Anthropic Claude 4.6 이후 모델(Haiku 5.5 제외)
- 롱컨텍스트 정책
- 100만 토큰 컨텍스트 전체에 표준 단가, 900k 요청도 9k 요청과 같은 토큰당 단가
- 확인 문서
- Claude Pricing 문서
Anthropic Claude Haiku 5.5
- 롱컨텍스트 정책
- 프롬프트 100,000토큰 초과 요청은 더 높은 단가(입력 $0.10 → $0.50 / 100만 토큰)
- 확인 문서
- Claude Pricing 문서
OpenAI GPT-5.4
- 롱컨텍스트 정책
- 1.05M 컨텍스트, 272K 초과 입력 시 세션 전체에 입력 2배·출력 1.5배
- 확인 문서
- GPT-5.4 모델 문서
Anthropic 문서는 Haiku 5.5의 프롬프트 길이에 캐시 읽기·쓰기 토큰까지 포함되며, 일부가 캐시 적중이어도 임계값을 넘으면 그 요청 전체가 높은 단가를 낸다고 명시해요(Claude Pricing). OpenAI는 GPT-5.4에서 272K 입력 토큰을 넘는 프롬프트에 표준·배치·플렉스 모두 입력 2배·출력 1.5배를 적용한다고 안내해요(GPT-5.4 문서). 즉 같은 '100만 토큰 창'이라도 어느 모델이냐에 따라 임계값 근처에서 비용이 계단처럼 뛸 수 있어요. 가격은 자주 바뀌므로 사용 전 최신 표를 다시 확인하세요.
지금 롱컨텍스트 비용을 줄이는 실전 방법
새 어텐션 기법이 상용 모델에 들어오기를 기다리지 않아도, 사용자 쪽에서 줄일 수 있는 비용이 꽤 있어요. 아래 순서로 점검해 보세요.
- 1
모델별 임계값을 먼저 확인해요
쓰는 모델의 가격 문서에서 롱컨텍스트 할증 기준(예: 100,000토큰, 272K)이 있는지 봐요. 임계값을 살짝 넘는 요청이 많다면 문맥을 조금 줄여 아래 구간에 머무는 것만으로 단가가 크게 달라질 수 있어요.
- 2
반복되는 앞부분은 프롬프트 캐싱으로 재사용해요
같은 시스템 프롬프트·문서·대화 기록을 매번 보내면 매번 다시 처리돼요. Anthropic 기준 캐시 적중은 기본 입력 단가의 0.1배(일부 모델은 더 낮음)이고, 5분 캐시 쓰기는 1.25배라 한 번만 다시 읽어도 이득이에요. 다만 캐시 유지 시간이 지나면 다시 써야 해요.
- 3
급하지 않은 작업은 배치로 보내요
Anthropic의 Batch API는 입력·출력 모두 50% 할인이에요. 대량 문서 요약처럼 즉시 응답이 필요 없는 일에 적합해요. OpenAI도 GPT-5.4 문서에서 배치 엔드포인트를 지원한다고 안내해요.
- 4
문맥 다이어트: 필요한 부분만 넣어요
전체 문서를 통째로 넣기보다 검색(RAG)으로 관련 단락만 고르거나, 오래된 대화를 요약해 교체해요. 입력 토큰이 줄면 요금과 첫 응답 대기 시간이 함께 줄어요.
- 5
품질은 작은 평가셋으로 확인해요
문맥을 줄이거나 저렴한 모델로 바꾼 뒤에는 실제 업무 질문 몇십 개로 답변 품질을 비교해요. 비용 절감이 정확도 하락과 맞바꿔지지 않았는지 숫자로 남겨 두는 것이 안전해요.
품질 저하 가능성과 논문 결과를 읽을 때의 한계
희소 어텐션의 본질적인 위험은 고르지 않은 키는 계산에서 빠진다는 점이에요. 인덱서가 정답 근거가 담긴 키를 놓치면 모델은 그 정보를 본 적이 없는 것처럼 답할 수 있어요. 긴 계약서에서 예외 조항 하나, 큰 코드베이스에서 설정 파일 한 줄처럼 드물지만 결정적인 정보가 특히 취약할 수 있어요. 그래서 논문이 말하는 '비슷한 정확도'는 어떤 과제·모델·길이에서 측정했는지와 함께 읽어야 해요.
- 속도 수치의 단위를 확인해요: LSA의 22.7배·72.4배는 어텐션 층 하나 기준이며 모델 전체의 지연 시간이 아니에요.
- 비교 대상을 확인해요: '기존 희소 어텐션 대비'와 '전체 어텐션 대비'는 다른 기준선이에요.
- 적용 방식을 확인해요: 증류로 붙인 버전은 원래 모델과 행동이 미묘하게 달라질 수 있어요.
- 재현 여부를 확인해요: 코드·가중치 공개와 다른 연구진의 재현 결과가 나오기 전까지는 잠정적인 결과로 다뤄요.
- 상용화 여부를 확인해요: 논문 공개가 곧 API 요금 인하나 특정 서비스 적용을 의미하지 않아요.
정리하면, 긴 문맥 AI가 비싼 이유는 '모든 쌍을 비교하는' 어텐션 구조에 있고, 서브쿼드라틱 어텐션은 계층형 인덱서로 비교 대상을 줄여 이 구조적 비용을 낮추려는 시도예요. 연구가 실서비스로 이어지기까지는 검증 시간이 필요하니, 당장은 모델별 임계값 확인, 프롬프트 캐싱, 배치 처리, 문맥 다이어트로 비용을 관리하고 품질은 직접 평가하는 것이 가장 확실한 방법이에요.