목차9개 섹션
LFM3는 미국 AI 기업 리퀴드AI(Liquid AI)가 2026년 10월 27일 공개한 2B급 오픈 웨이트 모델 계열이에요. 핵심은 '작아서 휴대폰·노트북 안에서 돌아가고, 특정 업무에 맞게 다시 학습시키기 쉬운 모델'이라는 점이에요. 텍스트 전용 LFM3-1.7B는 4비트로 줄이면 약 1GB 메모리에 들어가고, LFM3-VL-2B는 이미지·영상을, LFM3-Omni-2B는 이미지·영상·음성을 한 모델로 이해해요. 이 글은 2026년 11월 3일 기준 리퀴드AI 공식 블로그와 허깅페이스 모델 카드를 직접 확인해 정리했어요.
출시 직후 허깅페이스 트렌딩에 1.7B·VL-2B·Omni-2B가 나란히 올랐지만, 세 모델은 쓰임새가 꽤 달라요. 아래에서 변형별 차이, 기기에서 실제로 할 수 있는 일, '1GB'라는 숫자의 의미, 상업적 이용 조건과 한계를 순서대로 볼게요.
LFM3란? 리퀴드AI 소형 모델 계열 한눈에 보기
LFM3는 'Liquid Foundation Model' 3세대예요. 리퀴드AI는 하나의 큰 범용 모델 대신 같은 뼈대(LFM3-1.7B-Base)에서 갈라 나온 2B급 모델 6종을 내놨어요. 텍스트, 비전, 오디오, 옴니 네 가지가 입력 형태별 모델이고, 나머지 둘(d1-2B, d1-Omni-2B)은 문서·화면·음성을 보고 정해진 질문에 확률과 함께 답하는 '의사결정' 모델이에요.
구조도 일반적인 트랜스포머와 조금 달라요. LFM3-1.7B 모델 카드에 따르면 24개 층 가운데 13개가 게이트형 짧은 합성곱, 5개가 슬라이딩 윈도 어텐션, 6개만 전역 어텐션이에요. 긴 문맥에서도 계산량과 메모리를 덜 쓰도록 설계했다는 뜻이에요. 사전학습에는 총 22조(22T) 토큰을 썼다고 밝혔어요.
- 공개 형태: 기본(Base) 모델과 사후학습 모델 모두 오픈 웨이트로 허깅페이스·리퀴드AI API·플레이그라운드에서 제공해요.
- 지원 언어(텍스트): 영어, 한국어, 일본어, 중국어, 스페인어 등 16개 언어예요.
- 실행 경로: GGUF(llama.cpp·Ollama·LM Studio), 애플 실리콘용 MLX 4비트, ONNX, GPU용 BF16·FP8 등 여러 형식이 함께 올라왔어요.
- 맞춤 학습: 리퀴드AI는 모든 모델을 GPU 한 장으로 파인튜닝할 수 있다고 설명해요.
LFM3-1.7B·VL-2B·Omni-2B 차이 비교
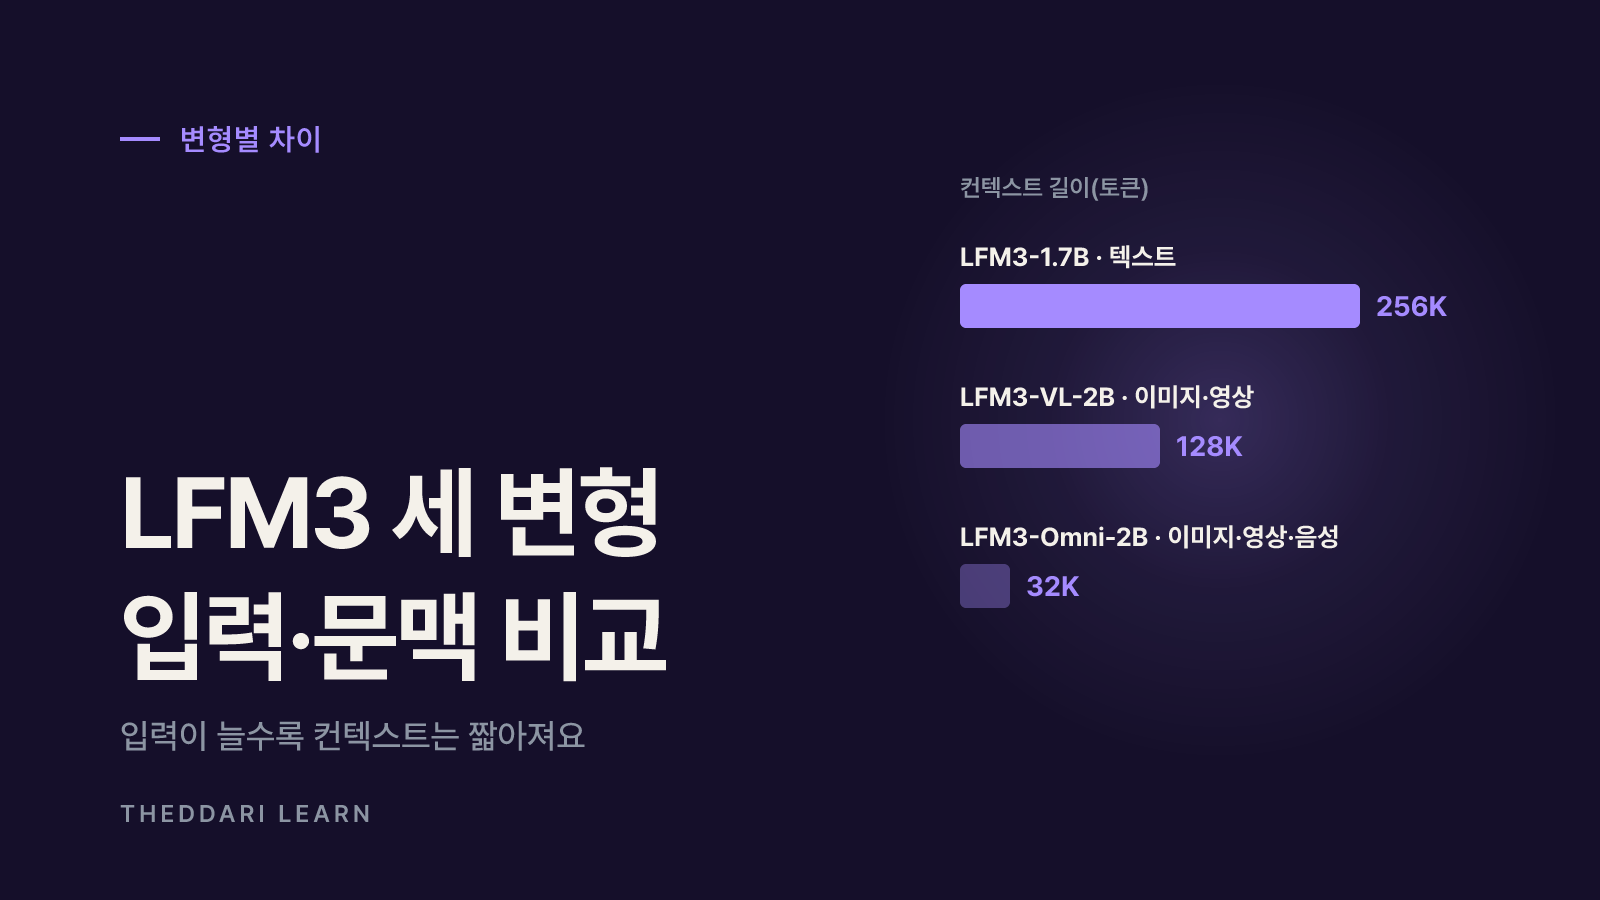
트렌딩에 함께 오른 세 모델을 모델 카드 수치로 나란히 놓으면 이래요. 파라미터 수는 비슷하지만 입력·출력과 컨텍스트 길이, 추론(thinking) 방식이 달라요.
파라미터
- LFM3-1.7B
- 1.73B
- LFM3-VL-2B
- 1.92B (언어 1.73B + 비전 인코더 164M + 프로젝터 25M)
- LFM3-Omni-2B
- 2.17B
입력
- LFM3-1.7B
- 텍스트
- LFM3-VL-2B
- 텍스트·이미지·영상
- LFM3-Omni-2B
- 텍스트·이미지·영상(소리 포함)·16kHz 음성
출력
- LFM3-1.7B
- 텍스트
- LFM3-VL-2B
- 텍스트
- LFM3-Omni-2B
- 텍스트·24kHz 음성·둘을 섞은 응답
컨텍스트
- LFM3-1.7B
- 256K 토큰
- LFM3-VL-2B
- 128K 토큰
- LFM3-Omni-2B
- 32K 토큰
추론 모드
- LFM3-1.7B
- 기본 켜짐
- LFM3-VL-2B
- 답하기 전 단계별 추론
- LFM3-Omni-2B
- 비추론 모델
주 용도
- LFM3-1.7B
- 로컬 에이전트·도구 호출·구조화 출력
- LFM3-VL-2B
- 영상 질의, 문서·차트·앱 화면 읽기, 사물 위치 찾기
- LFM3-Omni-2B
- 음성 대화, 받아쓰기·번역, 사진에 말로 질문
권장하지 않는 일
- LFM3-1.7B
- 코딩 에이전트, 복잡한 다단계 추론
- LFM3-VL-2B
- 코딩, 긴 다회차 대화, 복잡한 추론
- LFM3-Omni-2B
- 어려운 추론이 필요한 작업
LFM3-1.7B: 텍스트 에이전트용
Hermes Agent, OpenClaw 같은 에이전트 하네스에서 돌아가도록 사후학습한 텍스트 모델이에요. 도구 호출은 XML 형식으로 내보내고, 도구가 많을 때 정의를 프롬프트에 다 넣지 않고 검색으로 불러오는 '지연 로딩(deferred tools)'도 지원해요. 리퀴드AI 자체 측정에서 웹 자동화 벤치마크 WebArena-Verified 38.42점으로 Qwen3.5-9B(28.94점)보다 높았지만, 지식 문제인 GPQA Diamond는 63.37점으로 Qwen3.5-9B(80.40점)에 크게 못 미쳤어요. 작은 모델이 '형식과 도구'에는 강해도 '아는 양'에는 한계가 있다는 점을 보여 줘요.
LFM3-VL-2B: 이미지·영상 이해용
LFM 비전 모델 중 처음으로 영상을 입력받아요. 영상은 초당 2프레임으로 4~768프레임을 샘플링하고, 문서·차트·앱 화면 읽기와 물체 위치 찾기에 강점을 둬요. VL-2B 모델 카드는 62개 비전 벤치마크 평균 71.4점으로 Gemma 4 12B(71.7점)와 비슷하다고 밝혔어요. 다만 vLLM 지원은 진행 중이고 SGLang 지원은 검토 단계라고 적혀 있어, GPU 서버에서 쓰려면 버전을 확인해야 해요.
LFM3-Omni-2B: 보고 듣고 말하는 모델
음성 인식(ASR), 이미지 이해, 언어 모델, 음성 합성(TTS)을 따로 붙이던 구성을 한 모델로 대신하겠다는 시도예요. 사진을 보여 주고 말로 묻거나, 소리가 있는 영상을 보고 듣고 답하게 할 수 있어요. 음성 지원 언어에 한국어가 포함돼요. 대신 컨텍스트가 32K로 짧고 비추론 모델이라, 긴 영상이나 어려운 문제에서는 프레임 수를 줄이거나 다른 모델을 함께 써야 해요.
휴대폰·노트북에서 LFM3로 할 수 있는 일
소형 모델을 기기 안에서 돌리는 가장 큰 이유는 데이터가 기기 밖으로 나가지 않고, 인터넷이 없어도 동작하며, 호출할 때마다 API 요금이 붙지 않는다는 점이에요. LFM3 모델 카드와 블로그가 예로 든 작업을 정리하면 다음과 같아요.
- 정해진 형식 뽑기: 지저분한 문서·영수증 사진에서 JSON으로 항목 추출(모델 카드에 파인튜닝 노트북 예시가 있어요).
- 기기 조작 비서: 말이나 글로 한 요청을 '볼륨 30으로' 같은 도구 호출로 바꾸기. 108개 도구가 있는 폰 앱 예시도 공개됐어요.
- 메일·일정 분류: 받은 편지함 정리, 일정 관리, 아침 브리핑 같은 반복 업무를 에이전트로 처리하기.
- 화면·문서 읽기: 스크린샷, 차트, 앱 화면을 보고 질문에 답하기(VL·Omni).
- 음성 받아쓰기·번역: 녹음 파일을 글로 옮기거나 말한 내용을 다른 언어로 옮기기(Omni).
- 검색과 결합한 답변: 지식이 필요한 질문은 검색·RAG로 자료를 붙여 답하게 하기.
속도는 리퀴드AI가 AMD Ryzen AI Max+ 395 노트북, Apple M5 Max, iPhone 17 Pro에서 llama.cpp·Q4_0·32K 컨텍스트 조건으로 측정했어요. LFM3-1.7B가 비교 모델보다 생성 속도가 1.8~2.8배 빨랐다고 밝혔지만, 한 번에 요청 하나를 처리한 조건이라 실제 앱 체감은 다를 수 있어요. 허깅페이스에는 브라우저(WebGPU)에서 Omni-2B를 돌리는 데모도 올라와 있어요.
새 오픈 모델은 출시 직후 커뮤니티 반응이 빠르게 바뀌어요. 개발자들이 어떤 모델을 실제로 써 보고 있는지 흐름을 보려면 AI 텔레그램 트렌드에서 관련 언급을 함께 확인해 보세요.

메모리와 사양 확인: '약 1GB'가 뜻하는 것
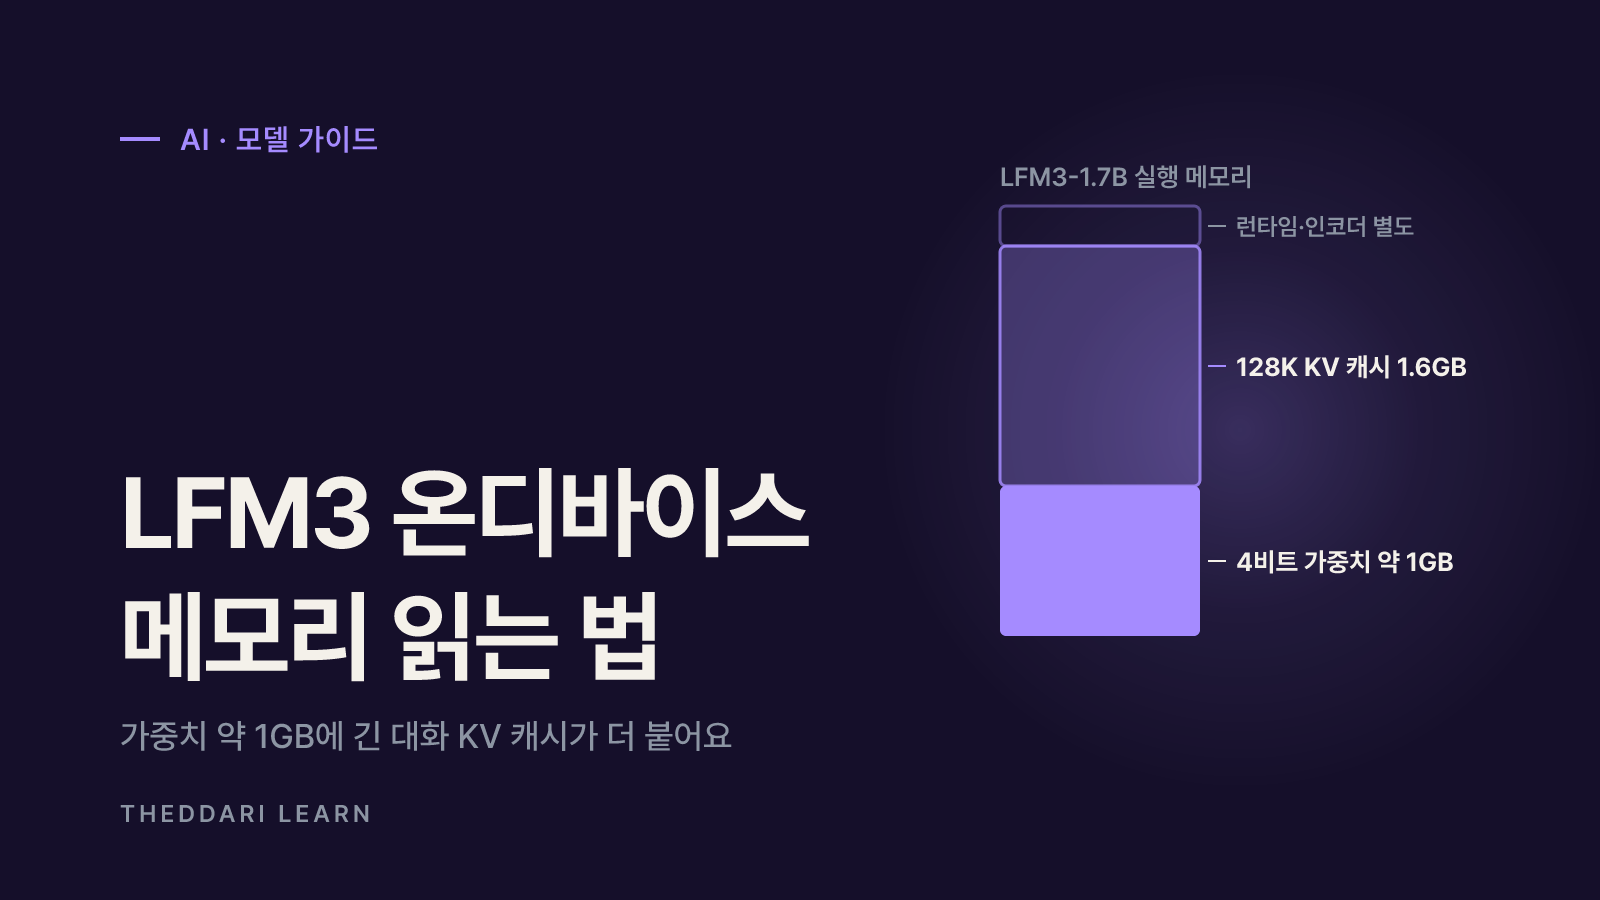
가장 많이 오해하는 숫자가 '약 1GB'예요. 이 값은 LFM3-1.7B 가중치를 4비트로 양자화했을 때의 크기예요. 실제 실행에는 다음 메모리가 더 붙어요.
- KV 캐시: 대화가 길수록 늘어나는 작업 메모리예요. 리퀴드AI는 128K 토큰을 꽉 채우면 KV 캐시만 1.6GB가 필요하다고 밝혔어요(Qwen3.5-4B 4.3GB, MiniCPM5-2B 5.6GB와 비교).
- 런타임·앱: llama.cpp, MLX, ONNX Runtime 같은 실행기와 앱 자체가 쓰는 메모리예요.
- 인코더: VL·Omni는 비전·오디오 인코더와 이미지·영상 토큰이 추가로 메모리를 써요. 영상 프레임이 많을수록 더 늘어나요.
- 운영체제 여유분: 휴대폰은 다른 앱과 메모리를 나눠 쓰므로, 백그라운드에서 강제 종료되지 않을 여유가 필요해요.
처음에는 짧은 컨텍스트(예: 8K~32K)와 4비트 GGUF로 시작해 메모리 사용량을 재고, 필요할 때만 컨텍스트를 늘리세요. 영상 입력은 초당 프레임 수와 최대 프레임 수를 낮추면 메모리를 아낄 수 있어요(llama.cpp에서는 이 모델의 프레임 설정이 고정이라는 점도 모델 카드에 적혀 있어요).
또 하나 확인할 점은 실행기 버전이에요. 1.7B 모델 카드는 LFM3를 지원하는 llama.cpp 빌드를 써야 한다고 안내하고, VL-2B는 llama.cpp b11960 이상을 권장해요. Transformers로 불러올 때는 trust_remote_code=True가 필요해 저장소의 사용자 정의 코드를 실행하게 되므로, 공식 LiquidAI 저장소인지 확인하고 받는 것이 안전해요. 파생 양자화 파일은 91개 이상 올라와 있지만 업로더가 제각각이라 출처를 꼭 봐야 해요.
라이선스: 연 매출 1,000만 달러 기준 확인하기
LFM3는 오픈 웨이트지만 아파치 2.0 같은 완전 개방 라이선스는 아니에요. LFM Open License v1.0 원문을 보면 복제·수정·재배포 권한을 주면서도 5조에 상업적 이용 제한을 둬요.
개인·연구·비상업 용도
- 상업적 이용
- 가능
- 비고
- 재배포 시 라이선스 사본 포함, 수정 파일에 변경 표시
연 매출 1,000만 달러 미만 법인
- 상업적 이용
- 가능
- 비고
- 매출이 기준을 넘으면 조건이 바뀌어요
연 매출 1,000만 달러 이상 법인
- 상업적 이용
- 라이선스 범위 밖
- 비고
- 리퀴드AI와 별도 계약이 필요해요
적격 비영리 단체
- 상업적 이용
- 비상업·연구 목적이면 매출 기준 미적용
- 비고
- 미국 501(c)(3) 또는 해외 동등 단체
'법인(Legal Entity)'은 지배·피지배 관계의 계열사를 합쳐 정의하므로, 작은 자회사라도 모회사 매출이 크면 기준을 넘을 수 있어요. 조건을 어기면 라이선스가 자동 종료되고 사본을 삭제해야 한다는 조항도 있어요. 제품에 넣기 전에 법무 검토를 거치는 게 좋아요.
LFM3를 직접 써 보기 전 확인 순서
- 1
용도부터 고르기
글만 다루면 1.7B, 이미지·영상·문서면 VL-2B, 음성 입출력이 필요하면 Omni-2B를 골라요. 단순 분류·추출이면 d1 의사결정 모델도 후보예요.
- 2
기기와 실행기 정하기
맥은 MLX 4비트, 윈도·리눅스 노트북은 GGUF+llama.cpp/LM Studio, 앱 내장은 ONNX를 우선 검토해요. LFM3를 지원하는 버전인지 먼저 확인해요.
- 3
내 데이터로 작은 시험
실제 업무 문장·사진 20~50개로 정답을 정해 두고 결과를 비교해요. 벤치마크 점수보다 이 결과가 판단 기준이에요.
- 4
메모리·속도 재기
쓰려는 컨텍스트 길이에서 최대 메모리와 첫 토큰까지 걸리는 시간을 재요. 휴대폰은 발열과 배터리 소모도 함께 봐요.
- 5
라이선스·보안 점검
회사 매출 기준, 재배포 고지 의무, 원격 코드 실행 여부, 양자화 파일 출처를 확인한 뒤 배포를 결정해요.
한계와 위험: 벤치마크를 그대로 믿기 전에
- 자체 측정 수치: 공개된 비교표는 리퀴드AI가 직접 측정한 값이에요. 독립 검증은 아직 적으니 '확인할 주장'으로 보는 게 좋아요.
- 지식·코딩 한계: 1.7B는 지식 문제와 코딩 에이전트에서 9B급 모델에 밀려요. 사실 질문은 검색 결과를 붙여야 해요.
- 언어별 편차: 다국어 점수는 여러 언어 평균이라 한국어 품질은 따로 확인해야 해요.
- 도구 생태계 초기: 출시 직후라 실행기·앱 지원이 버전마다 다르고, 일부 서버 프레임워크 지원은 아직 진행 중이에요.
- 추론 끄기 불안정: 1.7B는 추론이 기본으로 켜져 있고, 끄는 옵션은 작업에 따라 일관되지 않을 수 있다고 모델 카드가 밝혀요.
새 모델 소식은 블로그 글로도 빠르게 정리돼요. 국내외 반응을 비교하고 싶다면 블로그 트렌드 대시보드에서 관련 키워드를 살펴볼 수 있어요.
정리하면 LFM3는 '작은 모델 하나로 모든 걸 해결'하는 도구가 아니라, 기기 안에서 좁은 업무를 빠르고 싸게 처리하려는 개발자에게 맞는 출발점이에요. 텍스트·비전·음성 중 필요한 입력을 먼저 정하고, 실제 기기에서 메모리를 재고, 회사 매출 기준을 확인하는 세 단계만 거쳐도 시행착오를 크게 줄일 수 있어요.