인텔 D270 AI 가속기란? 480GB LPDDR5X 메모리 추론 칩이 의미하는 것
인텔 D270은 최대 480GB LPDDR5X·1.5TB/s·350W 공랭 PCIe 추론 GPU예요. HBM 대신 LPDDR5X를 쓴 의미, RTX PRO 6000과의 비교, 출시·가격 현황을 정리했어요.
목차8개 섹션
핵심 요약
- 인텔 D270은 2026년 10월 12일 공개된 데이터센터용 추론 GPU로, 최대 480GB LPDDR5X·1.5TB/s 대역폭·FP8 1.3 PFLOPS·350W 공랭 PCIe 카드예요.
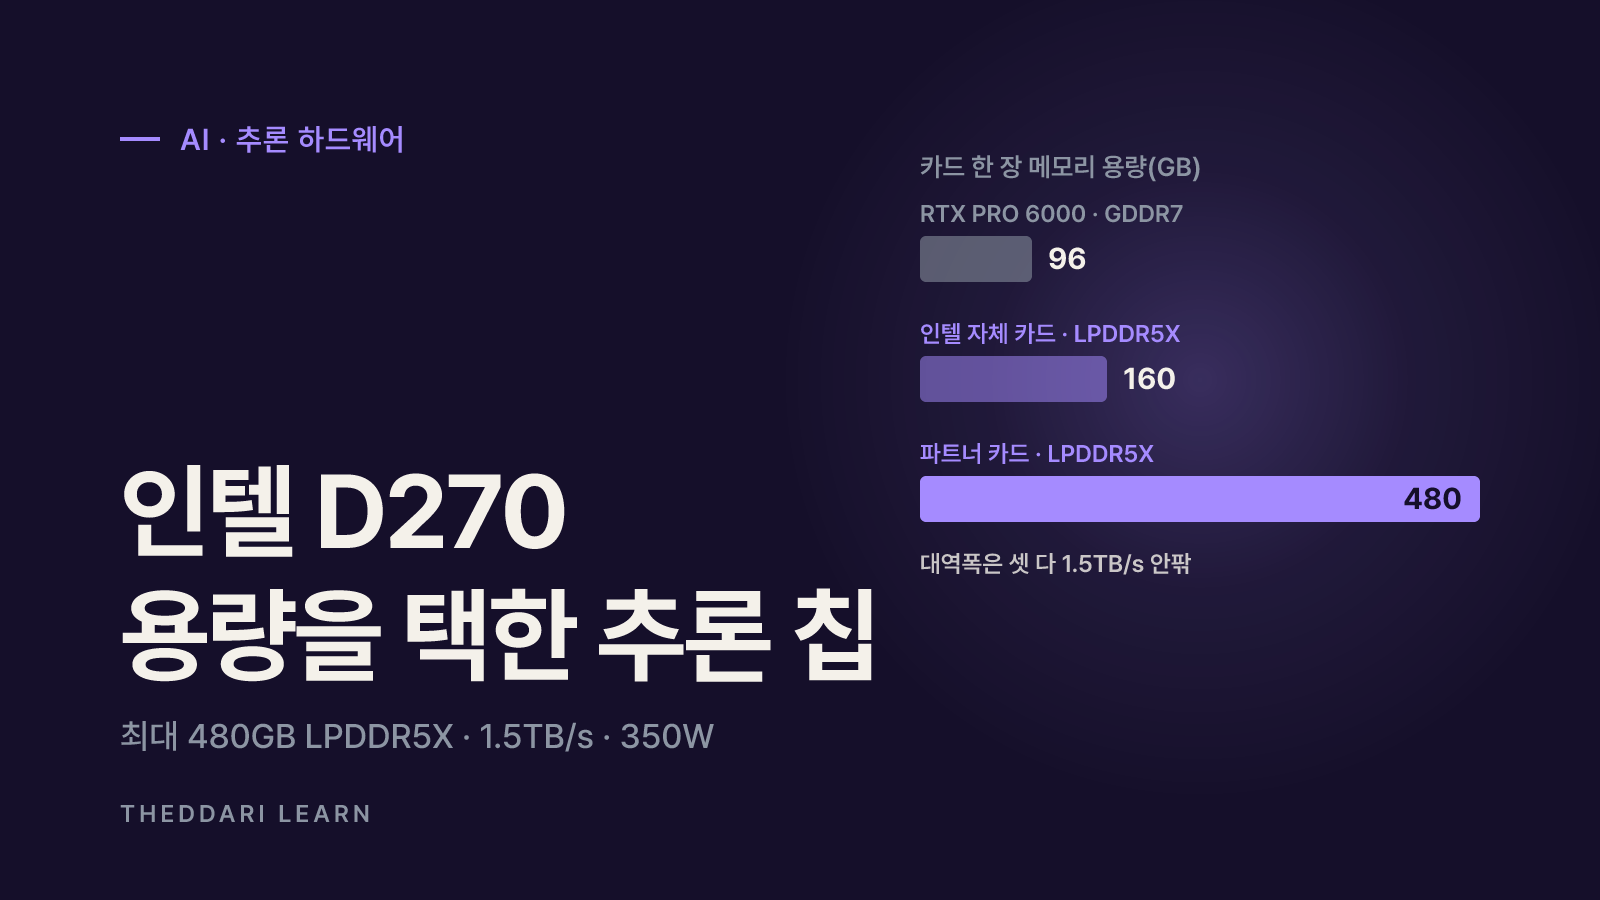
- 480GB는 파트너(ODM) 카드 기준이고, 인텔 자체 브랜드 카드는 160GB예요. 가격과 정식 출시일은 2026년 10월 13일 기준 미발표이며 고객 샘플링 단계예요.
- HBM 대신 LPDDR5X를 써서 대역폭은 HBM 플래그십보다 낮지만, 큰 모델·긴 문맥·많은 동시 세션을 한 카드에 담는 용량을 택한 설계예요.
- 한 사용자의 토큰 생성 속도는 대역폭에 묶이므로 비슷한 대역폭의 RTX PRO 6000과 크게 다르지 않을 가능성이 높고, 차이는 동시 처리량과 전력에서 나요.
- 판단에는 메모리 구성(160GB/480GB), 독립 벤치마크, 토큰당 전력·비용, 소프트웨어 지원, 실제 출시 일정을 함께 확인해야 해요.
인텔 D270은 인텔이 2026년 10월 12일 OCP(Open Compute Project) 글로벌 서밋에서 공개한 데이터센터용 AI 추론 GPU예요. 개발명은 Crescent Island였고, 제품군 이름은 Intel GPU D-series예요. 핵심은 고가의 HBM 대신 노트북·스마트폰에 쓰이던 LPDDR5X 메모리를 카드 한 장에 최대 480GB까지 붙였다는 점이에요. 대역폭(1.5TB/s)보다 많이 담는 쪽을 택한 설계라서, 한 사용자의 답변을 더 빠르게 만드는 칩이라기보다 더 큰 모델·더 긴 문맥·더 많은 동시 세션을 한 카드에 올리려는 칩에 가까워요.
이 글은 2026년 10월 13일 기준 인텔 보도자료와 인텔 제품 페이지를 바탕으로 정리했어요. 가격과 정식 출시일은 아직 발표되지 않았고, 성능 수치는 모두 인텔이 밝힌 이론값이에요.
인텔 D270 핵심 사양: 공식 발표로 확인된 숫자
인텔은 D270을 학습이 아니라 이미 만들어진 모델을 실제 서비스에서 돌리는 추론 전용으로 규정했어요. 에이전트형 AI, 긴 문맥 RAG, 코딩 어시스턴트, 문서 이해, 멀티모달, 확산 모델, 대량 동시 서빙이 인텔이 제품 페이지에 적은 대상 워크로드예요.
아키텍처
- 인텔 D270
- Xe3P
- 비고
- 인텔 최신 Xe 계열
연산 유닛
- 인텔 D270
- Xe3P 코어 32개, XMX 행렬 엔진 256개
- 비고
- 그래픽·레이 트레이싱 영역을 행렬 연산에 재배분
메모리
- 인텔 D270
- 최대 480GB LPDDR5X
- 비고
- 인텔 자체 카드 160GB, 480GB는 ODM 파트너 카드
메모리 대역폭
- 인텔 D270
- 1.5TB/s
- 비고
- HBM 미사용
FP8 연산
- 인텔 D270
- 1.3 PFLOPS
- 비고
- 인텔 발표 이론 최고치
전력·냉각
- 인텔 D270
- 350W, 공랭
- 비고
- 액체 냉각 개조 불필요
인터페이스
- 인텔 D270
- PCIe 5.0
- 비고
- 표준 서버 슬롯에 장착
지원 모델 규모
- 인텔 D270
- 단일 카드 최대 3,000억 파라미터, 8장 시스템 1조 이상
- 비고
- 전제 조건(정밀도·메모리 구성) 미공개
상태
- 인텔 D270
- 고객 샘플링 중
- 비고
- 가격·출시일 미발표
가장 먼저 짚을 점은 480GB가 모든 카드의 기본값이 아니라는 것이에요. 인텔 보도자료 각주는 인텔 브랜드 PCIe 카드가 160GB LPDDR5X이고, 설계상 파트너가 최대 480GB까지 유연하게 구성한 ODM 카드를 만들 수 있다고 적었어요. ServeTheHome은 인텔 카드가 8GB 칩 20개, 480GB 구성은 24GB LPDDR5X 칩으로 가능하다고 설명했고, 대역폭은 약 9,375MT/s의 1,280비트 메모리 버스에서 나온다고 분석했어요. 같은 매체는 클럭을 약 2.5GHz, L2 캐시를 32MB, FP64 벡터 성능을 10.2 TFLOPS로 정리했어요.
또 하나는 이름은 GPU지만 그래픽카드가 아니라는 점이에요. 인텔은 그래픽·레이 트레이싱 파이프라인에 쓰던 다이 면적을 Xe3P 코어와 행렬 연산으로 옮겨 추론 효율을 높였다고 밝혔어요.
왜 HBM이 아니라 LPDDR5X일까: 용량과 대역폭의 맞교환
고성능 AI 가속기는 보통 GPU 옆에 쌓아 올린 HBM을 써서 매우 높은 대역폭을 얻어요. 대신 비싸고 용량을 늘리기 어려워요. D270은 반대로 대역폭을 어느 정도 포기하고 저렴하고 전력 효율이 좋은 LPDDR5X를 대량으로 붙였어요. 이 선택의 의미를 이해하려면 LLM 추론이 어떻게 돌아가는지부터 봐야 해요.
LLM 추론은 프리필과 디코드로 나뉘어요
- 프리필(prefill): 사용자가 보낸 프롬프트 전체를 한꺼번에 처리하는 단계예요. 행렬 연산이 몰려서 연산 성능이 중요해요. 인텔은 32개 코어와 256개 XMX 엔진이 프리필을 가속해 긴 문맥·에이전트 작업의 비용을 줄인다고 강조했어요.
- 디코드(decode): 답변 토큰을 하나씩 생성하는 단계예요. 토큰 하나를 만들 때마다 모델 가중치를 메모리에서 거의 통째로 읽어야 해서 메모리 대역폭이 속도를 좌우해요.
- KV 캐시: 앞서 처리한 문맥을 다시 계산하지 않도록 저장해 두는 메모리예요. 문맥이 길수록, 동시 사용자가 많을수록 커져서 메모리 용량을 빠르게 잡아먹어요.
디코드 속도의 대략적인 상한 계산
단일 사용자의 디코드 속도는 대략 메모리 대역폭 ÷ 토큰당 읽어야 하는 바이트로 상한을 가늠할 수 있어요. 예를 들어 700억 파라미터 모델을 FP8(파라미터당 1바이트)로 올리면 가중치가 약 70GB예요. D270의 1.5TB/s(1,500GB/s)를 70GB로 나누면 초당 약 21토큰이 이론 상한이에요. 실제로는 KV 캐시 읽기와 효율 손실 때문에 이보다 낮아요. 이 계산은 설명을 위한 단순화이고, 인텔이 발표한 벤치마크 수치가 아니에요.
이 공식에서 보듯 메모리 용량을 늘려도 한 사용자의 생성 속도는 빨라지지 않아요. 용량이 바꾸는 것은 동시에 몇 명을, 얼마나 긴 문맥으로 처리하느냐예요.
용량이 늘면 바뀌는 것: KV 캐시와 동시 세션
디코드 단계에서는 여러 사용자의 요청을 묶어(배칭) 한 번의 가중치 읽기로 여러 토큰을 동시에 만들 수 있어요. 묶을 수 있는 요청 수는 각 요청의 KV 캐시를 담을 메모리가 얼마나 남느냐에 달려 있어요. 메모리가 크면 더 많은 세션을 상주시켜 카드 전체의 초당 토큰 처리량을 높일 수 있고, 10만 토큰급 긴 문맥도 여러 개 올려 둘 수 있어요. 인텔이 제품 페이지에서 10만 토큰 문맥과 수십 개 동시 세션을 언급하며 에이전트를 상주시킨다고 표현한 이유가 여기에 있어요.
또 모델이 한 카드에 들어가면 여러 GPU로 나눠 담을 때 생기는 통신 부담과 GPU 대수를 줄일 수 있어요. 인텔이 HBM 없이 더 적은 GPU로 전체 문맥을 다룬다고 강조한 것도 같은 맥락이에요.
HBM을 쓰지 않는 대가
대역폭이 HBM 플래그십보다 낮으니 한 사용자에게 빠른 응답이 중요한 서비스에는 불리할 수 있어요. ServeTheHome은 D270이 엔비디아 Blackwell Ultra나 AMD MI455X 같은 플래그십과 같은 급을 노린 제품이 아니라 더 작고 저렴한 제품이라고 평가했어요. 같은 PCIe 폼팩터인 AMD MI350P가 밀집 FP8 2.3 PFLOPS를 내는 데 비해 D270은 약 40% 낮다는 분석도 덧붙였어요. 다만 이 매체도 이론 성능만으로 실제 경쟁력을 판단하기 어렵다며, 프리필 효율과 와트당 성능이 관건이라고 봤어요.
엔비디아 RTX PRO 6000과 비교하면
인텔은 제품 페이지 각주에서 성능 전망을 엔비디아 RTX PRO 6000과 비교했고, 메모리 용량 비교는 비슷한 대역폭 기준이라고 밝혔어요. 아래 표는 엔비디아 공식 페이지의 RTX PRO 6000 Blackwell Server Edition 사양과 인텔 발표 수치를 나란히 놓은 것이에요.
메모리
- 인텔 D270
- 160GB(인텔 카드) / 최대 480GB(ODM) LPDDR5X
- 엔비디아 RTX PRO 6000 Server Edition
- 96GB GDDR7
메모리 대역폭
- 인텔 D270
- 1.5TB/s
- 엔비디아 RTX PRO 6000 Server Edition
- 1,597GB/s
FP8 표기 성능
- 인텔 D270
- 1.3 PFLOPS
- 엔비디아 RTX PRO 6000 Server Edition
- 2 PFLOPS(엔비디아 표기, 산정 기준 차이 가능)
전력
- 인텔 D270
- 350W
- 엔비디아 RTX PRO 6000 Server Edition
- 최대 600W(설정 가능)
폼팩터
- 인텔 D270
- PCIe 5.0, 공랭
- 엔비디아 RTX PRO 6000 Server Edition
- PCIe 5.0, 듀얼 슬롯 패시브
상태
- 인텔 D270
- 샘플링, 가격·출시일 미발표
- 엔비디아 RTX PRO 6000 Server Edition
- 출시된 제품
대역폭이 거의 같으니 앞의 계산대로라면 700억 파라미터 FP8 모델의 단일 사용자 디코드 상한은 D270 약 21토큰/초, RTX PRO 6000 약 23토큰/초(1,597 ÷ 70)로 비슷해요. 차이는 용량이에요. 480GB 구성은 96GB의 5배, 160GB 인텔 카드도 약 1.7배라서 같은 모델을 올린 뒤 KV 캐시에 쓸 수 있는 공간이 훨씬 커요. 반면 엔비디아는 CUDA 생태계와 이미 판매 중이라는 확실성이 있고, 표기 연산 성능도 더 높아요. 어느 쪽이 유리한지는 서비스가 지연 시간 중심인지, 동시 처리량·전력 중심인지에 따라 달라져요.
D270 같은 LLM 추론 칩을 볼 때 확인할 지표
- 1
메모리 구성부터 확인
견적이나 기사에 나온 카드가 160GB 인텔 카드인지, 최대 480GB ODM 카드인지 먼저 확인해요. 용량 계산과 가격 비교가 완전히 달라져요.
- 2
모델 크기와 KV 캐시 합산
쓰려는 모델의 가중치 크기(파라미터 수 × 정밀도 바이트)에 목표 문맥 길이와 동시 세션 수만큼의 KV 캐시를 더해 카드 한 장에 들어가는지 계산해요.
- 3
프리필·디코드를 나눈 독립 벤치마크
같은 모델·같은 배치·같은 문맥 조건에서 첫 토큰까지 걸리는 시간, 사용자당 토큰 속도, 카드 전체 처리량, 소비 전력이 함께 공개된 제3자 결과를 기다려요. 인텔 수치는 아직 이론값이에요.
- 4
토큰당 비용과 전력
카드 가격·서버 비용·전력비를 측정한 초당 토큰으로 나눠 비교해요. 350W 공랭이라는 장점은 랙당 전력 한도가 빠듯한 곳에서 커져요.
- 5
소프트웨어 지원 범위
인텔은 vLLM과 PyTorch를 지원하고 SGLang·OpenAI Triton은 승인된 경우로 표기했어요. 쓰는 서빙 엔진과 커널이 실제로 최적화돼 있는지 확인해요.
- 6
출시 일정과 공급
샘플링은 평가용 카드가 돈다는 뜻이지 일반 판매가 시작됐다는 뜻이 아니에요. 서버 제조사의 탑재 제품 발표와 정식 출시일을 따로 확인해요.
인텔의 출시 일정 언급은 분기 실적 발표 콘퍼런스콜에서 나오는 경우가 많아요. 더따리 실적 캘린더에서 인텔 실적 발표일을 확인해 두면 후속 정보를 놓치지 않을 수 있어요.

남은 불확실성과 위험
- 가격·출시일 미정: 2026년 10월 13일 기준 인텔은 고객 샘플링 중이라고만 밝혔어요. ServeTheHome은 연내 출시도 확인되지 않았다며 2027년을 봐야 한다고 평가했어요.
- 제품 계획 이력: ServeTheHome에 따르면 D270은 2021년 Ponte Vecchio 이후 인텔의 첫 상용 AI 데이터센터 GPU이고, 후속작이던 Rialto Bridge(2023년)와 Falcon Shores(2025년)는 취소됐어요. 사양 발표가 곧 안정적인 공급을 뜻하지는 않아요.
- 제조사 수치만 존재: 1.3 PFLOPS와 1.5TB/s는 이론 최고치이고, RTX PRO 6000 대비 성능 전망은 인텔이 2026년 2월 기준 공개 정보와 내부 분석으로 산출했다고 각주에 적었어요.
- 3,000억 파라미터 조건 불명확: 어떤 메모리 구성과 정밀도에서 단일 카드 3,000억 파라미터가 가능한지 발표문에 없어요. 160GB 카드로 같은 결과를 기대하면 안 돼요.
- 생태계 성숙도: 인텔은 공통 Xe 소프트웨어 기반의 이식성과 신규 오픈 모델 Day 0 지원을 내세우지만, 실제 서빙 성능은 커널 최적화 수준에 크게 좌우돼요.
AI 하드웨어 소식은 발표 직후 커뮤니티에서 빠르게 해석이 쏟아져요. 더따리 텔레그램 AI 트렌드에서 관련 채널 흐름을 보고, 블로그 트렌드에서 국내 해설 글이 어떤 쟁점을 다루는지 함께 확인하면 과장된 해석을 걸러내는 데 도움이 돼요.
정리: 인텔 D270이 의미하는 것
인텔 D270은 최고 속도 경쟁 대신 메모리 용량·전력·표준 서버 호환성으로 추론 비용을 낮추겠다는 제안이에요. 에이전트처럼 긴 문맥을 많이 읽고 동시 세션이 많은 워크로드가 늘어날수록 이런 설계가 의미를 가질 수 있어요. 다만 2026년 10월 기준으로는 가격·출시일·독립 벤치마크가 모두 비어 있어서, 지금 단계에서는 명확한 설계 방향이 공개된 것이지 검증된 대안이 등장한 것은 아니에요. 판단할 때는 160GB와 480GB 구성을 구분하고, 같은 조건의 프리필·디코드 결과와 토큰당 전력·비용이 나오는지 지켜보면 돼요.