Frostbite CPU란? AI가 설계·검증했다는 새 칩, 주장 확인할 점
Frostbite CPU는 Architect Labs가 AI 에이전트로 설계·검증했다고 밝힌 새 CPU예요. 4.59배 전성비 주장의 비교 조건과 실제 칩 제작 여부, 확인할 점을 정리해요.
목차7개 섹션
핵심 요약
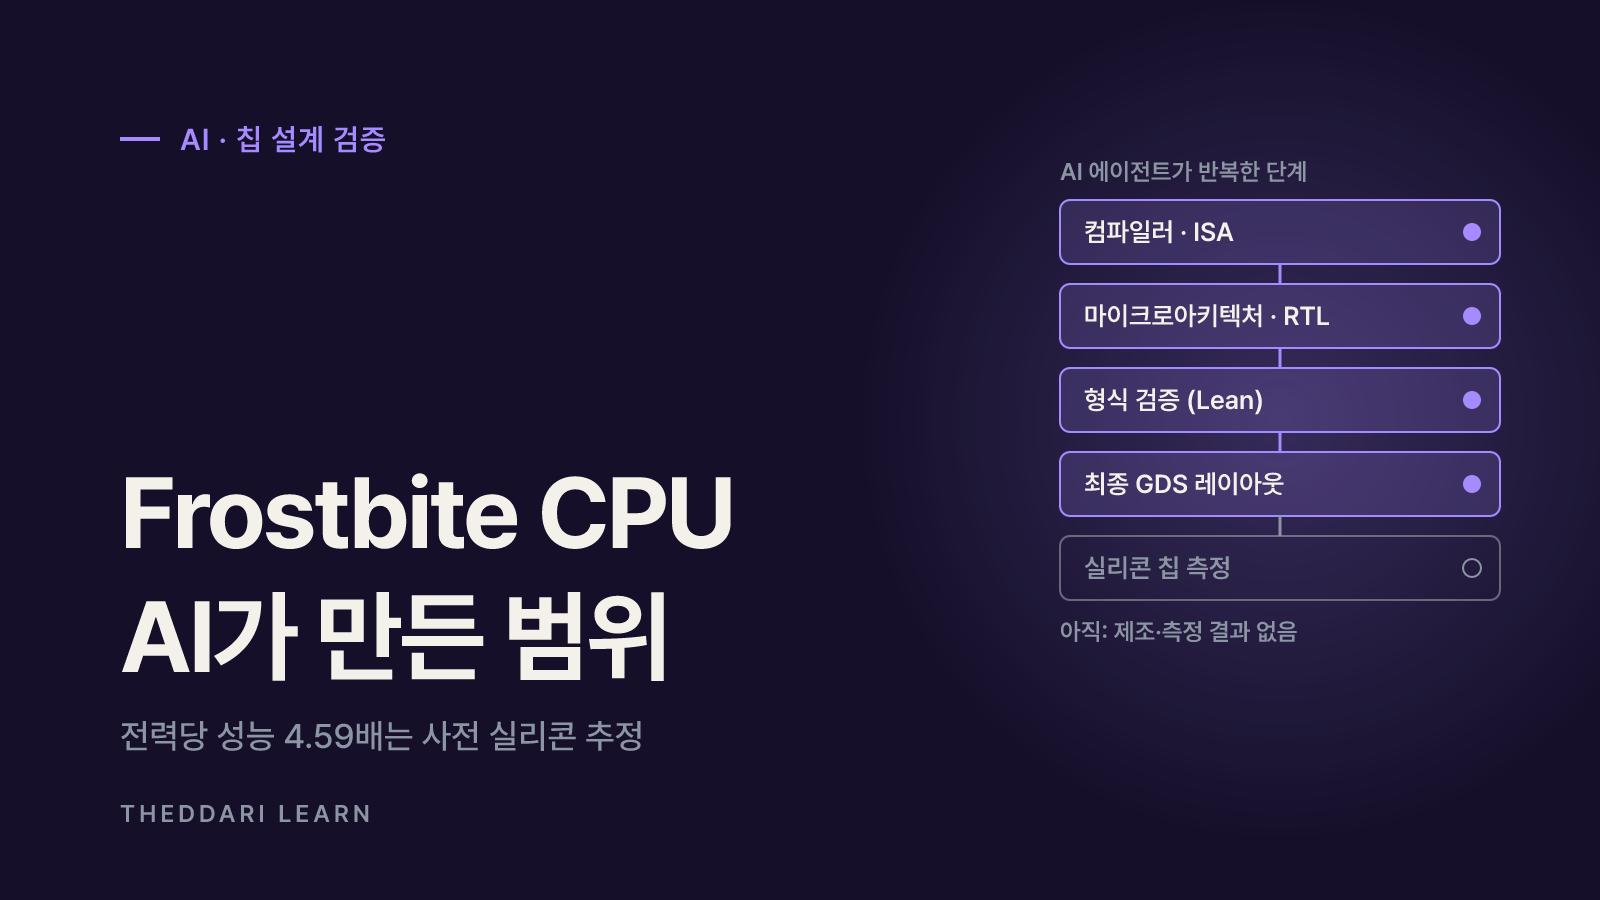
- Frostbite CPU는 Architect Labs가 2026년 11월 18일 공개한 실험용 CPU 아키텍처로, AI 에이전트가 컴파일러·ISA·RTL·검증·최종 GDS까지 반복 설계했다고 회사가 주장해요.
- 핵심 수치 4.59배는 이름이 공개되지 않은 2폭 인오더 CPU 코어 1개와 비교한 '전력당 성능' 기하평균이며, 튜닝에 쓰지 않은 15개 작업만 보면 3.83배예요.
- 2026년 11월 21일 기준 실제로 제조된 칩(실리콘) 결과나 상용 출시 발표는 없고, 수치는 7nm 합성·레이아웃 단계의 사전 실리콘 추정이에요.
- RTL·ISA 공개, FPGA 체험 환경, SPEC·PARSEC 벤치마크는 회사의 향후 계획이므로 독립 재현 전까지는 '회사 주장'으로 읽는 것이 안전해요.
Frostbite CPU는 미국 스타트업 Architect Labs가 2026년 11월 18일 블로그로 공개한 실험용 범용 CPU 아키텍처예요. 회사는 AI 에이전트들이 명령어 집합(ISA)부터 마이크로아키텍처, RTL, 검증, 최종 GDS 레이아웃까지 반복 설계했고, 그 결과 기존 CPU 코어 대비 전력당 성능 4.59배를 얻었다고 주장해요. 다만 2026년 11월 21일 기준 이 수치는 실제 제조된 칩이 아닌 사전 실리콘(pre-silicon) 추정이고, 비교 대상 CPU의 이름도 공개되지 않았어요. 이 글은 발표 원문이 무엇을 AI가 했다고 말하는지, 수치가 어떤 조건에서 나왔는지, 아직 확인되지 않은 것은 무엇인지를 나눠 정리해요.
Frostbite CPU는 무엇이 다른가요: 인터랙션 넷 기반 구조
Frostbite의 출발점은 1990년 이브 라퐁(Yves Lafont)이 제안한 계산 모델인 인터랙션 넷(interaction nets)이에요. 프로그램을 노드로 이루어진 그래프로 보고, 포트로 연결된 노드 한 쌍을 다시 쓰는 방식으로 계산이 진행돼요. 각 다시쓰기는 그래프의 작은 부분만 건드리고 활성 쌍끼리 겹치지 않으므로 어떤 순서로, 혹은 동시에 처리해도 결과가 같다는 성질(합류성)이 있어요. 모든 값이 정확히 한 번만 쓰이기 때문에 여러 코어가 같은 메모리를 공유하며 서로 지켜봐야 하는 상황도 줄어든다는 것이 회사의 설명이에요.
일반 CPU는 프로그램의 의존 관계를 런타임에 다시 찾아내기 위해 아웃오브오더 실행 장치와 깊은 캐시, 캐시 일관성 프로토콜에 많은 면적과 전력을 써요. Frostbite는 이 비용을 줄이려고 작은 타일을 격자로 배치하고, 각 타일 옆에 작은 로컬 메모리를 두는 구조를 택했어요. 프로그램은 러스트와 비슷한 문법의 Vine 언어로 작성하고 Ivy라는 중간 표현으로 컴파일해요. 타일은 자기 일을 먼저 하고, 일이 없으면 이웃 타일의 남는 작업을 가져오며, 그것도 없으면 쉬면서 전력을 아끼는 '작업 훔치기' 규칙을 따른다고 해요. 회사는 이 규칙을 사람이 명시하지 않았고 에이전트가 성능 회귀를 고치다 만들어 냈다고 설명해요.
새로운 아이디어일까요
인터랙션 넷과 데이터플로 하드웨어는 오래된 연구 주제예요. 해커뉴스 토론에서도 과거 데이터플로 아키텍처(WaveScalar), 인터랙션 넷 런타임 HVM과 Bend 언어 사례가 거론됐고, 기존 소프트웨어를 새 모델로 옮기는 비용이 채택의 가장 큰 장벽이라는 지적이 나왔어요. 즉 Frostbite의 새로움은 계산 모델 자체보다 그 모델을 AI 에이전트로 칩 레이아웃까지 구현했다는 과정 쪽에 있다고 보는 편이 정확해요.
AI 칩 설계 주장: AI가 한 일과 사람이 정한 일
발표를 읽을 때 가장 먼저 나눌 것은 '누가 무엇을 했는가'예요. 회사 설명에 따르면 사람 팀은 병렬·단계형·순차·분기·재귀의 다섯 범주로 25개 작업 묶음을 정하고, 각 범주를 탐색용(search set)과 최종 평가용(held-out)으로 나눴어요. 또 자체 명세 언어 ASL과 시스템 모델 Arcmodel, Lean 정리 증명기로 이어지는 검증 체계를 만들었어요. AI 에이전트 무리는 이 틀 안에서 구조 후보를 비교하고, 명세·모델·RTL·전력 측정을 함께 반복하며 아이디어를 채택하거나 버렸어요.
작업 선정
- 회사 설명
- 사람이 25개 작업과 평가 분할을 정함
- 읽을 때 주의할 점
- SPLASH-2 계열 커널은 원래보다 64배 작게 실행
구조 탐색
- 회사 설명
- 에이전트가 논문·벤치마크를 종합해 141쪽 초안 작성
- 읽을 때 주의할 점
- 초안은 첫 RTL 이후 삭제, 수치가 물리적으로 크게 빗나갔다고 회사가 인정
명세·검증
- 회사 설명
- ASL 계약을 진실의 원천으로 두고 Lean 80만 줄 이상으로 변환
- 읽을 때 주의할 점
- 증명이 '유용한 성질'을 다루는지는 공개 자료로 확인 불가
반복 개선
- 회사 설명
- 4차례 탐색과 마무리 실험에서 58개 아이디어 중 37개 채택
- 읽을 때 주의할 점
- 채택 기준과 실패 사례의 세부는 미공개
물리 구현
- 회사 설명
- 7nm 합성 800MHz, 최종 GDS 500MHz
- 읽을 때 주의할 점
- 제조·측정된 실리콘 결과는 없음
정리하면 'AI가 설계·검증했다'는 문장은 사람이 만든 문제 정의와 검증 도구 안에서 에이전트가 설계 공간을 빠르게 탐색하고 구현했다는 의미에 가까워요. 해커뉴스에서도 핵심 통찰은 기존 연구에서 나왔고 AI는 이를 제품 수준 설계로 엮었다는 평가가 있었어요. 형식 검증에 대해서는 '증명이 실제 칩과 대응하는지, 어떤 성질을 증명했는지'를 묻는 댓글이 나왔는데, 이 질문에 답하려면 회사가 예고한 ASL 상세 글과 RTL 공개를 기다려야 해요.
성능 수치 읽는 법: 4.59배는 어떤 조건인가요
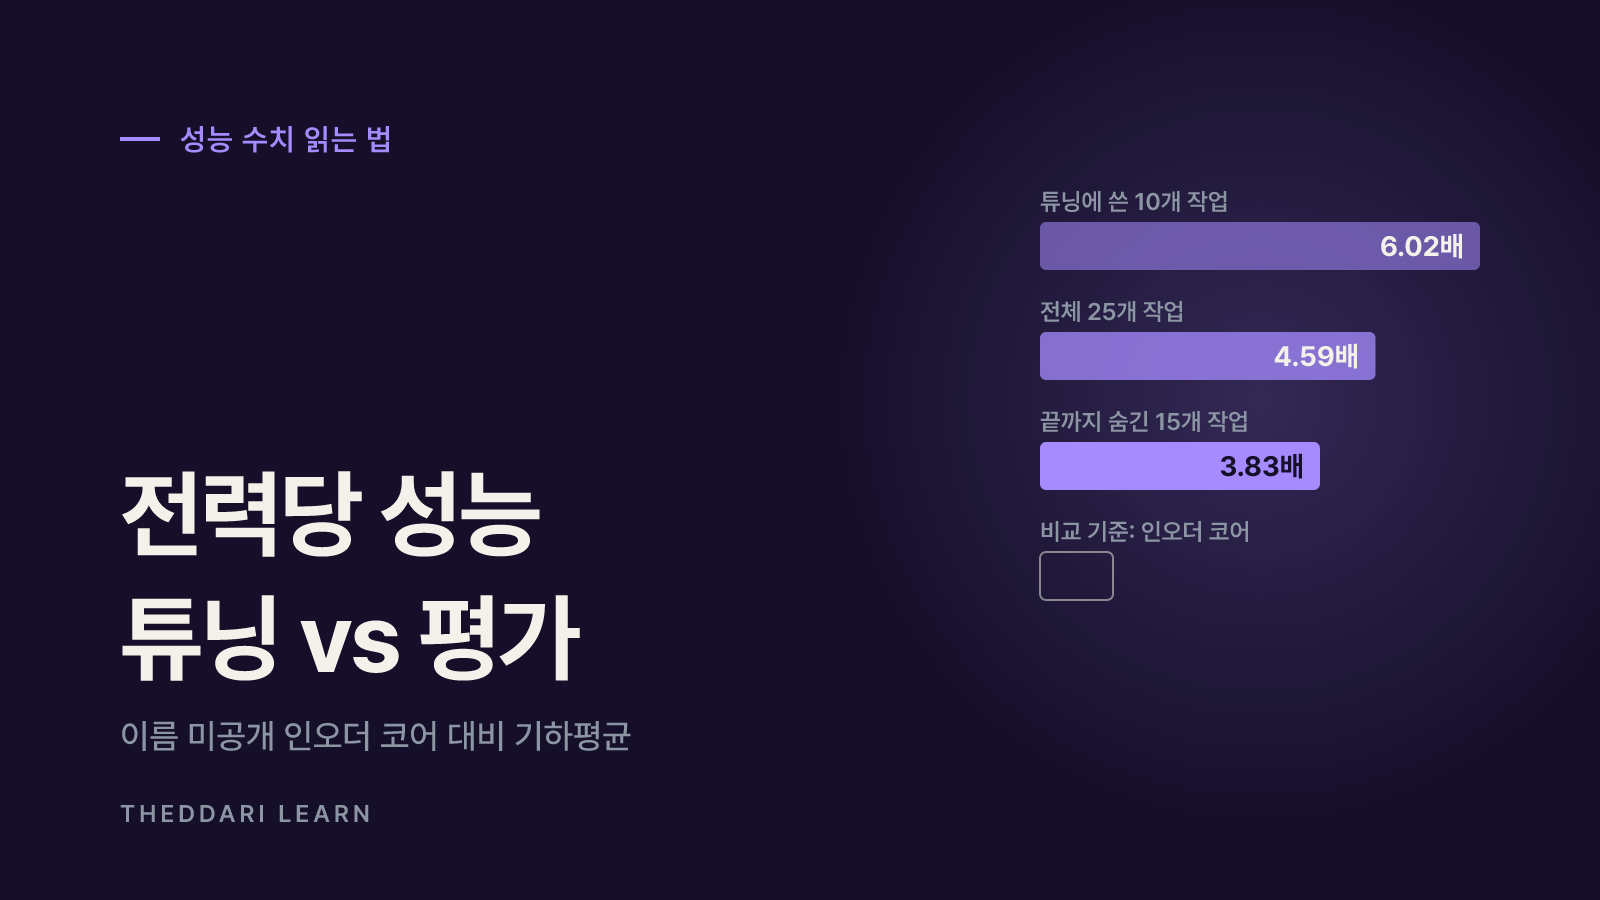
발표의 대표 수치는 25개 작업 전체의 전력당 성능(perf/W) 기하평균 4.59배예요. 비교 단위는 Frostbite 쿼드 1개(2×2 타일과 L3 노드 4개, 0.792㎟)와, 같은 공정에서 0.895㎟인 기존 CPU 코어 1개(회사 표현 TCPU)예요. 면적당 성능은 평균 8.77배라고 해요. 그런데 이 평균을 나누어 보면 그림이 달라져요. 에이전트가 튜닝에 사용한 10개 작업에서는 6.02배, 끝까지 숨겨 둔 15개 작업에서는 3.83배예요.
- 튜닝용과 평가용의 차이: 6.02배와 3.83배의 차이는 설계가 본 적 있는 작업에 맞춰졌을 가능성을 보여 줘요. 일반화 성능에 더 가까운 값은 3.83배예요.
- 비교 대상: 이름 미공개의 2폭 인오더 코어 1개예요. 회사는 법적 이유로 정확한 CPU를 밝힐 수 없다고 했어요. 노트북·서버의 넓은 아웃오브오더 코어와의 비교는 아직 없어요.
- 지표의 의미: perf/W는 효율 지표라서 절대 속도가 빠르다는 뜻이 아니에요. 최종 레이아웃 클럭은 500MHz예요.
- 작업 편차: 작업별 결과는 conv2d 23.12배부터 재귀 피보나치 1.15배까지 넓게 퍼져 있어요. 병렬성이 큰 작업에서 가장 강하다고 회사도 밝혔어요.
- 에너지 구성: 클럭 분배를 뺀 에너지에서 메모리 비중은 TCPU 57%에서 38%로, 명령어 인출·해석·발행은 27%에서 6%로 줄었지만 온칩 네트워크·스케줄러에 26%를 새로 써요.
회사는 앞으로 SPEC·PARSEC 같은 업계 표준 벤치마크로 다중 코어 CPU와 더 크고 넓은 아웃오브오더 CPU와 비교하겠다고 했어요. 해커뉴스에서는 인오더 기준선이 약하다는 비판과, perf/W 기준이라면 인오더 코어가 오히려 효율적인 비교 대상이라는 반론이 함께 나왔어요. 둘 다 일리가 있으므로 결론은 표준 벤치마크 결과가 나온 뒤로 미루는 것이 합리적이에요.
아직 확인되지 않은 것: 실리콘·재현·소프트웨어
Notebookcheck 보도도 짚었듯 Frostbite는 생산 준비가 된 프로세서가 아니라 실험용 아키텍처예요. 2026년 11월 21일 기준 공개 자료로 확인되지 않는 항목은 다음과 같아요.
- 실제 칩 측정값: 전력·성능은 합성과 레이아웃 흐름의 추정이에요. 회사도 이것이 사전 실리콘 전력 수치이며 여러 번의 테이프아웃을 거쳐야 실측과 맞출 수 있다고 적었어요.
- 독립 재현: RTL과 ISA 공개는 계획 단계라 외부 연구자가 같은 결과를 재현할 수 없어요.
- 기존 소프트웨어 호환: 프로그램을 Vine으로 작성해야 하므로 운영체제·데이터베이스·브라우저 같은 일반 소프트웨어를 얼마나 옮길 수 있는지는 보여 주지 않았어요.
- 확장성: 4×4 타일 배열에서도 전력 분포가 비슷했다고 하지만, 다중 코어 CPU와의 비교는 앞으로의 계획이에요.
- 설계 인력 절감 효과: 에이전트가 몇 명의 엔지니어 시간을 대체했는지, 비용이 얼마였는지는 공개되지 않았어요.
'AI가 만든 CPU가 인텔·AMD를 이긴다'는 식의 요약은 원문보다 강한 주장이에요. 원문 비교는 소형 인오더 코어 1개와의 효율 비교이며, 상용 데스크톱·서버 CPU와의 성능 비교가 아니에요.
AI 반도체 설계 발표를 읽는 체크리스트
Frostbite 외에도 AI 반도체 설계를 내세운 발표는 계속 나올 거예요. 아래 순서로 읽으면 홍보 문구와 검증된 사실을 구분하기 쉬워요. 화제가 된 AI 기술 소식이 어디서 어떻게 퍼지는지는 더따리 텔레그램 AI 트렌드와 블로그 트렌드에서 함께 살펴볼 수 있어요. 다만 트렌드 순위는 관심도를 보여 줄 뿐 기술 주장의 사실 여부를 판정하지 않아요.
- 1
단계를 확인해요
시뮬레이션, RTL, 합성, GDS, 테이프아웃, 실리콘 측정 중 어디까지 왔는지 원문에서 찾아요. GDS까지라도 실제 칩 측정은 아니에요.
- 2
비교 대상과 지표를 적어요
비교 CPU의 이름·세대·코어 수, 그리고 지표가 절대 성능인지 전력당·면적당 성능인지 확인해요. 평균 방식(기하평균 등)도 함께 봐요.
- 3
튜닝 데이터와 평가 데이터를 나눠요
설계 중에 본 작업과 숨겨 둔 작업의 결과를 따로 읽고, 작업 크기를 줄였는지도 확인해요.
- 4
AI와 사람의 역할을 구분해요
문제 정의·평가 기준·검증 도구를 누가 만들었는지, AI가 자율적으로 결정한 범위가 어디까지인지 적어요.
- 5
재현 가능성을 확인해요
RTL·ISA·벤치마크 코드 공개 여부와 외부 검증, 표준 벤치마크(SPEC 등) 결과가 있는지 확인하고 없으면 '회사 주장'으로 기록해요.

정리하면 Frostbite CPU는 AI 에이전트가 형식 명세와 증명 도구의 도움을 받아 새로운 계산 모델의 칩을 레이아웃 단계까지 구현했다는 점에서 눈여겨볼 사례예요. 하지만 4.59배라는 숫자는 튜닝에 쓰인 작업이 섞인 평균이고, 비교 대상은 공개되지 않은 소형 코어이며, 실리콘 측정과 독립 재현이 없어요. 회사가 예고한 RTL·ISA 공개와 FPGA 체험 환경, SPEC·PARSEC 결과가 나왔을 때 다시 확인하는 것이 이 발표를 가장 정확하게 읽는 방법이에요.
자주 묻는 질문
Frostbite CPU는 실제로 살 수 있는 칩인가요?
AI가 정말 사람 없이 CPU를 설계했나요?
4.59배 빠르다는 뜻인가요?
이 발표가 반도체 주식에 바로 영향을 주나요?
출처·참고 자료
- 1Architect Labs: Introducing Frostbite (2026-11-18)(새 탭에서 열림)architectlabs.com
- 2Hacker News: Frostbite 토론 스레드(새 탭에서 열림)news.ycombinator.com
- 3Notebookcheck: AI designed an all-new CPU (2026-11-20)(새 탭에서 열림)www.notebookcheck.net
- 4The Vine Programming Language(새 탭에서 열림)vine.dev
관련 글
 AI
텐센트 Hy4-flash란? 특징과 API·로컬 실행 전 확인할 점
허깅페이스에서 주목받는 텐센트 Hy4-flash의 구조(총 220B·활성 12B), 공식 벤치마크를 읽는 법, OpenRouter API 가격, 로컬 GGUF 용량과 GPU 조건, Tencent Hy License의 상업 이용 조건을 2026년 11월 20일 기준으로 정리했어요.
 AI
Haru-4B란? 허깅페이스 트렌딩 1위 음성 대화 모델과 로컬 실행 전 확인할 점
허깅페이스 트렌딩 1위에 오른 Haru-4B는 텍스트 소형 LLM이 아니라 전화 통화처럼 듣고 말하기를 동시에 하는 음성 대화 기반 모델이에요. 구조, 로컬 실행 사양, 양자화 버전, 연구용 한계를 공식 자료로 정리했어요.
 AI
제미나이 네온(Gemini 4 Neon)이란? Hydrogen·Argon 차이와 요금
Gemini 4 Neon은 Carbon과 Hydrogen 사이에서 깊이와 속도를 절충한 구글의 새 모델이에요. 입력 100만 토큰당 3달러·출력 15달러이고 무료 티어가 없어요. Hydrogen·Argon과 요금·성능·이용 범위를 비교하고 쓰기 전 확인할 점을 정리했어요.