목차7개 섹션
허깅페이스 모델 이름은 대체로 기반 모델 → 크기 → 학습 목적 → 버전 → 가중치 인코딩(양자화) → 파일 종류 순서로 읽으면 돼요. 예를 들어 Qwen3-30B-A3B에서 30B는 전체 파라미터 규모, A3B는 토큰마다 실제 계산에 쓰이는 활성 파라미터 규모예요. 파일명 끝의 Q4_K_M이나 저장소 이름의 GGUF는 성능 등급이 아니라 저장 형식과 압축 정도를 알려 주는 표기예요. 다만 이 순서는 권장 관례일 뿐 강제 표준이 아니어서 최종 판단은 모델 카드와 파일 메타데이터로 해야 해요. 이 글은 2026년 10월 기준으로 ggml의 GGUF 사양, 허깅페이스 Hub·TRL 공식 문서, Qwen 공식 모델 카드를 직접 확인해 정리했어요.
허깅페이스 모델 이름은 어떤 순서로 붙을까요
가장 구체적인 기준은 ggml의 GGUF 명명 규약이에요. 파일명을 [Sidecar]-BaseName-SizeLabel-FineTune-Version-Encoding-Type-Shard.gguf 순서로, 각 요소를 하이픈으로 이어 붙이도록 권장해요. 문서는 이 규칙이 사람이 한눈에 중요한 정보를 파악하도록 돕기 위한 것이며, 이미 퍼진 파일명이 다양해서 기계가 완벽하게 해석하는 것을 목표로 하지는 않는다고 밝혀요. 허깅페이스 저장소 이름(조직/모델)은 이 규약을 따를 의무도 없어요. 그래서 이름은 단서로 쓰고 사실 확인은 모델 카드로 하는 습관이 필요해요.
Sidecar(선택)
- 예시
- mmproj, mtp
- 뜻
- 단독 모델이 아니라 기반 모델과 함께 불러오는 보조 모듈이에요. mmproj는 멀티모달 프로젝터, mtp는 다중 토큰 예측 헤드예요.
BaseName
- 예시
- Qwen3, Mixtral
- 뜻
- 기반 모델 또는 아키텍처 이름이에요.
SizeLabel
- 예시
- 27B, 8x7B
- 뜻
- 파라미터 규모예요. 전문가 수x규모 형식도 써요.
FineTune
- 예시
- Instruct, Chat
- 뜻
- 미세조정 목적이에요.
Version
- 예시
- v0.1, v1.0
- 뜻
- 버전이에요. 없으면 v1.0으로 간주해요.
Encoding
- 예시
- F16, Q4_K_M
- 뜻
- 가중치 인코딩(양자화) 방식이에요.
Type
- 예시
- LoRA, vocab
- 뜻
- 없으면 일반 모델 파일, LoRA는 어댑터, vocab은 어휘 전용 파일이에요.
Shard(선택)
- 예시
- 00003-of-00009
- 뜻
- 여러 파일로 나눈 경우의 순번이에요. 5자리로 쓰고 00001부터 시작해요.
규약 문서는 최소한 BaseName·SizeLabel·Version이 있어야 규약을 지킨 파일로 검증할 수 있다고 설명해요. 버전이 빠지면 Encoding을 FineTune으로 잘못 읽기 쉽다는 예도 들어요. 실제로 커뮤니티 저장소 이름에는 버전이 없거나 기법 약어가 여러 개 붙어 있는 경우가 많으니, 하이픈 위치만 보고 기계적으로 쪼개지 말고 각 조각이 위 표의 어느 요소에 해당하는지 의미로 판단하세요.
B·M·T 단위와 8x7B 같은 표기
크기 표기의 단위 글자는 K(천), M(백만), B(10억), T(조), Q(천조) 파라미터예요. 27B는 약 270억 개, 600M은 약 6억 개 파라미터라는 뜻이에요. 소수점을 반올림해 쓰는 것도 허용되므로 이름의 숫자와 모델 카드의 정확한 수치가 조금 다를 수 있어요. Mixtral-8x7B처럼 앞에 숫자와 x가 붙으면 전문가(expert) 개수와 전문가 단위 규모를 뜻해요. 8과 7을 곱한 값이 곧 전체 파라미터라고 계산하지 말고, 공유되는 층이 있을 수 있으니 모델 카드의 총 파라미터 수를 확인하세요. 규약은 -ContextLength4k처럼 다른 속성을 크기 뒤에 덧붙이는 것도 허용해요.
A3B·A4B는 MoE 활성 파라미터예요
이름에 30B-A3B, 29B-A4B처럼 크기가 두 번 나오면 대부분 MoE(Mixture of Experts, 전문가 혼합) 모델이에요. 앞 숫자는 전체 파라미터, A 뒤 숫자는 토큰 하나를 처리할 때 실제로 활성화되는 파라미터예요. Qwen3-30B-A3B 모델 카드를 보면 전체 30.5B, 활성 3.3B, 전문가 128개 중 토큰마다 8개를 사용한다고 적혀 있어요. 이름의 30B·3B는 이 값을 반올림한 꼬리표인 셈이에요. 같은 방식으로 A4B는 활성 파라미터가 약 4B라는 뜻으로 읽을 수 있지만, 정확한 값은 해당 모델 카드에서 확인해야 해요.
토큰당 계산에 쓰는 파라미터
- 일반(dense) 모델
- 전체
- MoE 모델(예: 30B-A3B)
- 활성 파라미터만(예: 3.3B)
파일에 담긴 가중치
- 일반(dense) 모델
- 전체
- MoE 모델(예: 30B-A3B)
- 모든 전문가를 포함한 전체(예: 30.5B)
다운로드·저장 용량 기준
- 일반(dense) 모델
- 전체 규모
- MoE 모델(예: 30B-A3B)
- 전체 규모
이름 표기
- 일반(dense) 모델
- 27B
- MoE 모델(예: 30B-A3B)
- 30B-A3B
가장 흔한 오해는 A3B 모델을 3B 모델처럼 가볍게 생각하는 거예요. 활성 파라미터가 작으면 토큰당 계산량은 줄지만 파일에는 모든 전문가의 가중치가 들어 있어요. 실제로 Qwen3-30B-A3B의 Hub 페이지는 모델 크기를 31B 파라미터로 표시해요. 그래서 내려받을 용량과 저장 공간은 전체 파라미터를 기준으로 잡아야 하고, 실행 속도와 필요한 메모리는 사용하는 프로그램이 전문가 가중치를 어디에 두는지에 따라 달라져요. 활성 3B라는 숫자만으로 3B 일반 모델과 품질이나 속도를 직접 비교하지 마세요.
GGUF 뜻과 Q4_K_M 같은 양자화 표기 읽기
허깅페이스 Hub의 GGUF 문서에 따르면 GGUF는 GGML과 그 기반 실행기(llama.cpp 등)를 위한 바이너리 파일 형식이에요. 텐서만 담는 safetensors와 달리 텐서와 표준 메타데이터를 한 파일에 함께 담아요. 그래서 저장소 이름 끝의 -GGUF는 원본 모델을 이 형식으로 변환해 올렸다는 표시이고, 모델 자체가 달라졌다는 뜻은 아니에요. Hub의 GGUF 파일 뷰어로 메타데이터와 텐서별 형식을 내려받기 전에 확인할 수 있어요.
GGUF 저장소에는 보통 같은 모델을 여러 정밀도로 양자화한 파일이 함께 있어요. 양자화는 가중치를 더 적은 비트로 표현해 파일과 메모리 사용량을 줄이는 방법이에요. 아래 비트 수는 Hub 문서가 설명한 가중치당 평균 비트예요.
F16 / BF16
- 가중치당 비트
- 16
- 특징
- 16비트 부동소수점이에요. 보통 원본에 가장 가까운 기준 파일이에요.
Q8_0
- 가중치당 비트
- 8비트
- 특징
- 32개 가중치 블록 단위의 반올림 방식이에요. 문서는 레거시 방식으로 분류해요.
Q6_K
- 가중치당 비트
- 6.5625
- 특징
- K 계열 슈퍼블록 구조예요.
Q5_K
- 가중치당 비트
- 5.5
- 특징
- K 계열이에요.
Q4_K
- 가중치당 비트
- 4.5
- 특징
- K 계열이에요. Q4_K_M 같은 파일의 주된 형식이에요.
IQ4_XS
- 가중치당 비트
- 4.25
- 특징
- 중요도 행렬(importance matrix)을 써서 가중치를 구해요.
Q3_K
- 가중치당 비트
- 3.4375
- 특징
- K 계열이에요.
Q2_K
- 가중치당 비트
- 2.625
- 특징
- K 계열이에요. 크기는 작지만 정밀도 손실이 가장 커요.
표기를 쪼개 보면 Q 뒤 숫자가 대략의 비트 수, K는 블록을 묶은 슈퍼블록 방식(k-quant), 앞의 I는 중요도 행렬을 쓰는 방식이에요. Q4_0·Q5_1 같은 _0, _1 표기는 Hub 문서가 레거시로 분류한 단순 블록 방식이에요. Q4_K_M의 끝 글자는 같은 계열 안에서 텐서별 형식을 섞은 변형을 구분해요. GGUF 사양의 general.file_type 값이 MOSTLY_Q4_K_M처럼 대부분(mostly)이라는 단어를 쓰는 이유도, 일부 텐서는 다른 형식으로 저장될 수 있기 때문이에요. 또 양자화 이름과 별개로 general.quantization_version 필드가 있어서 같은 이름이라도 형식 버전이 다를 수 있어요.
파일 크기는 파라미터 수 × 비트 ÷ 8로 어림해요
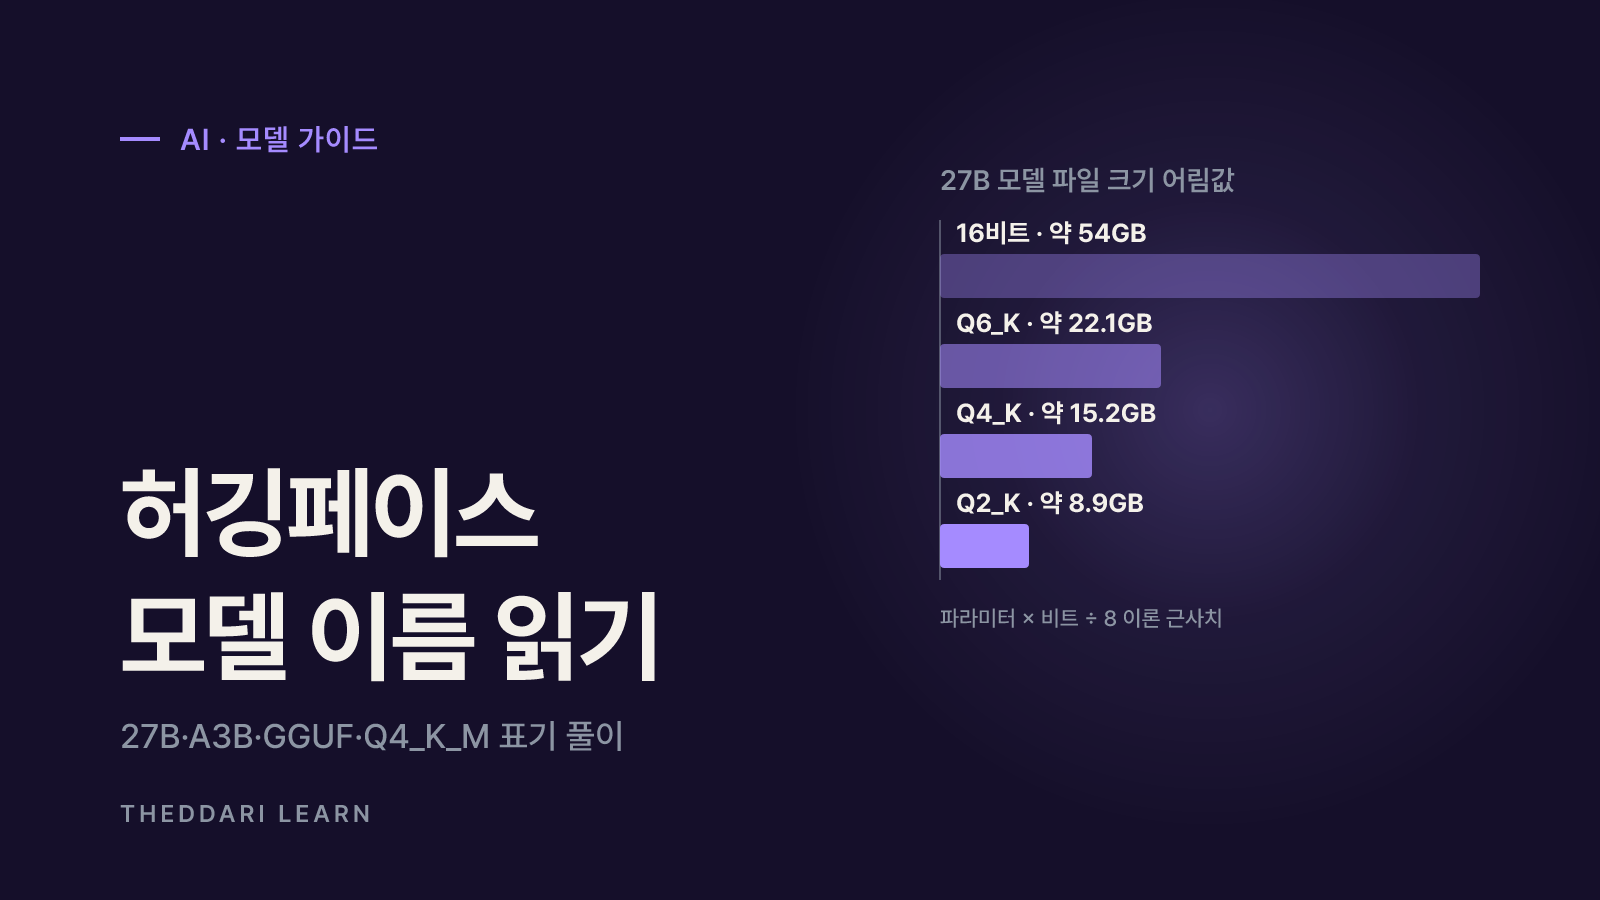
대략적인 파일 크기는 파라미터 수에 가중치당 비트를 곱하고 8로 나눠 바이트로 바꾸면 돼요. 27B 모델이라면 16비트는 약 54GB, Q6_K(6.5625비트)는 약 22.1GB, Q4_K(4.5비트)는 약 15.2GB, Q2_K(2.625비트)는 약 8.9GB예요(10억 바이트 기준 이론 근사치). 실제 파일은 텐서별 형식 혼합과 메타데이터 때문에 이 값과 차이가 나고, 실행할 때는 대화 길이에 따른 추가 메모리도 필요해요. 비트가 낮을수록 정밀도 손실 가능성이 커지지만 체감 차이는 모델과 작업마다 다르므로, 들어가는 범위에서 두세 가지 파일을 직접 비교해 보는 편이 안전해요.
SFT·RLOO·Instruct 같은 학습 표기의 의미
Instruct·Chat은 GGUF 규약의 FineTune 요소로, 지시를 따르거나 대화하도록 추가 학습한 버전이라는 뜻이에요. Base가 붙으면 사전학습만 마친 모델인 경우가 많아요. TRL의 SFT 문서는 SFT(Supervised Fine-Tuning, 지도 미세조정)를 입력과 출력 시퀀스 쌍으로 모델을 학습시키는, 가장 단순하고 널리 쓰이는 적응 방법이라고 설명해요. 목표 출력 토큰의 음의 로그우도를 최소화하는 방식이에요.
TRL의 RLOO 문서에 따르면 RLOO는 REINFORCE 계열의 온라인 강화학습 알고리즘이에요. 프롬프트마다 여러 답을 생성한 뒤, 각 답의 보상을 나머지 답들의 평균 보상(leave-one-out 기준선)과 비교해 학습해요. 같은 문서는 GRPO와의 차이도 설명해요. 이름에 SFT, RLOO, GRPO, DPO, LoRA 같은 약어가 붙어 있다면 작성자가 그런 방법으로 추가 학습했다고 밝힌 것이에요. 다만 어떤 데이터로 얼마나 학습했는지, 결과를 평가했는지는 이름에 담기지 않아요.
이름에 유명 상용 모델명이나 기법 약어를 여러 개 이어 붙인 저장소가 트렌딩에 오르기도 해요. 이런 이름은 작성자의 설명일 뿐 해당 회사의 공식 모델이나 공인 성능을 뜻하지 않아요. 실제 출발점은 모델 카드의 base_model 항목으로 확인하세요.
파생·병합 모델을 고를 때 모델 카드에서 확인할 것
허깅페이스 모델 카드 문서에 따르면 미세조정·어댑터·양자화·병합 모델은 메타데이터의 base_model에 기반 모델을 적을 수 있고, Hub는 관계를 adapter, merge, quantized, finetune으로 추론해 모델 트리로 보여 줘요. 2026년 10월에 확인한 Qwen3-30B-A3B 페이지의 모델 트리에는 양자화 파생 153개, 미세조정 77개, 어댑터 65개, 병합 6개가 연결돼 있었어요. 인기 모델 하나에도 수많은 파생본이 생기므로 이름보다 계보를 먼저 보는 것이 효율적이에요.
- 1
base_model과 모델 트리를 확인해요
어떤 원본에서 출발했는지, 관계가 양자화인지 미세조정인지 병합인지 확인해요. base_model이 비어 있으면 출처를 판단할 근거가 부족하다는 신호예요.
- 2
파일 목록과 형식을 확인해요
Files 탭에서 GGUF인지 safetensors인지, 어떤 양자화 파일과 샤드가 있는지, mmproj 같은 보조 파일이 필요한지 확인해요. GGUF 뷰어로 메타데이터도 열어 봐요.
- 3
라이선스와 사용 조건을 확인해요
파생 모델은 원본 모델의 라이선스 조건을 함께 따져야 해요. 카드에 적힌 license와 원본 저장소의 조건이 일치하는지 봐요.
- 4
학습·평가 공개 여부를 확인해요
학습 데이터셋, 방법, 평가 결과가 공개됐는지 봐요. Uncensored처럼 안전 장치를 제거했다고 밝힌 모델은 업무·서비스 사용 시 별도 위험을 검토해요.
- 5
작은 시험으로 직접 비교해요
내 작업과 비슷한 질문 몇 개로 원본 공식 모델과 파생 모델을 같은 조건에서 비교해요. 다운로드 수나 트렌딩 순위는 관심도일 뿐 품질 평가가 아니에요.
새로 화제가 되는 모델 이름을 접했을 때는 실제로 어떤 맥락에서 이야기되는지 함께 보는 것도 도움이 돼요. 더따리 AI 텔레그램 트렌드에서는 AI 채널에서 자주 언급되는 키워드를, 블로그 트렌드에서는 글로 많이 다뤄지는 주제를 확인할 수 있어요. 언급이 많다는 사실은 관심도를 보여 줄 뿐 모델의 품질이나 안전성을 확인해 주지는 않으니, 이름을 찾은 뒤에는 위 단계로 모델 카드를 직접 검토하세요.

정리하면 이름의 크기 표기는 규모를, A 표기는 토큰당 활성 규모를, GGUF와 Q4_K_M은 저장 형식과 압축 정도를, SFT·RLOO는 작성자가 밝힌 학습 방법을 알려 줘요. 이 네 가지를 구분해 읽으면 긴 이름도 빠르게 풀 수 있어요. 그다음 base_model, 라이선스, 파일 구성, 평가 공개 여부를 모델 카드에서 확인하고, 내 장비에 들어가는 파일을 직접 시험해 보는 순서로 고르면 이름에 휘둘리지 않을 수 있어요.