Codex 학습 데이터 설정 확인법: 재활성화 논란과 끄는 법
Codex 대화가 OpenAI 모델 학습에 쓰이는지 계정 유형별로 정리했어요. 학습 설정이 다시 켜졌다는 논란의 사실관계, 끄는 위치, 꺼도 남는 예외를 확인하세요.
목차7개 섹션
핵심 요약
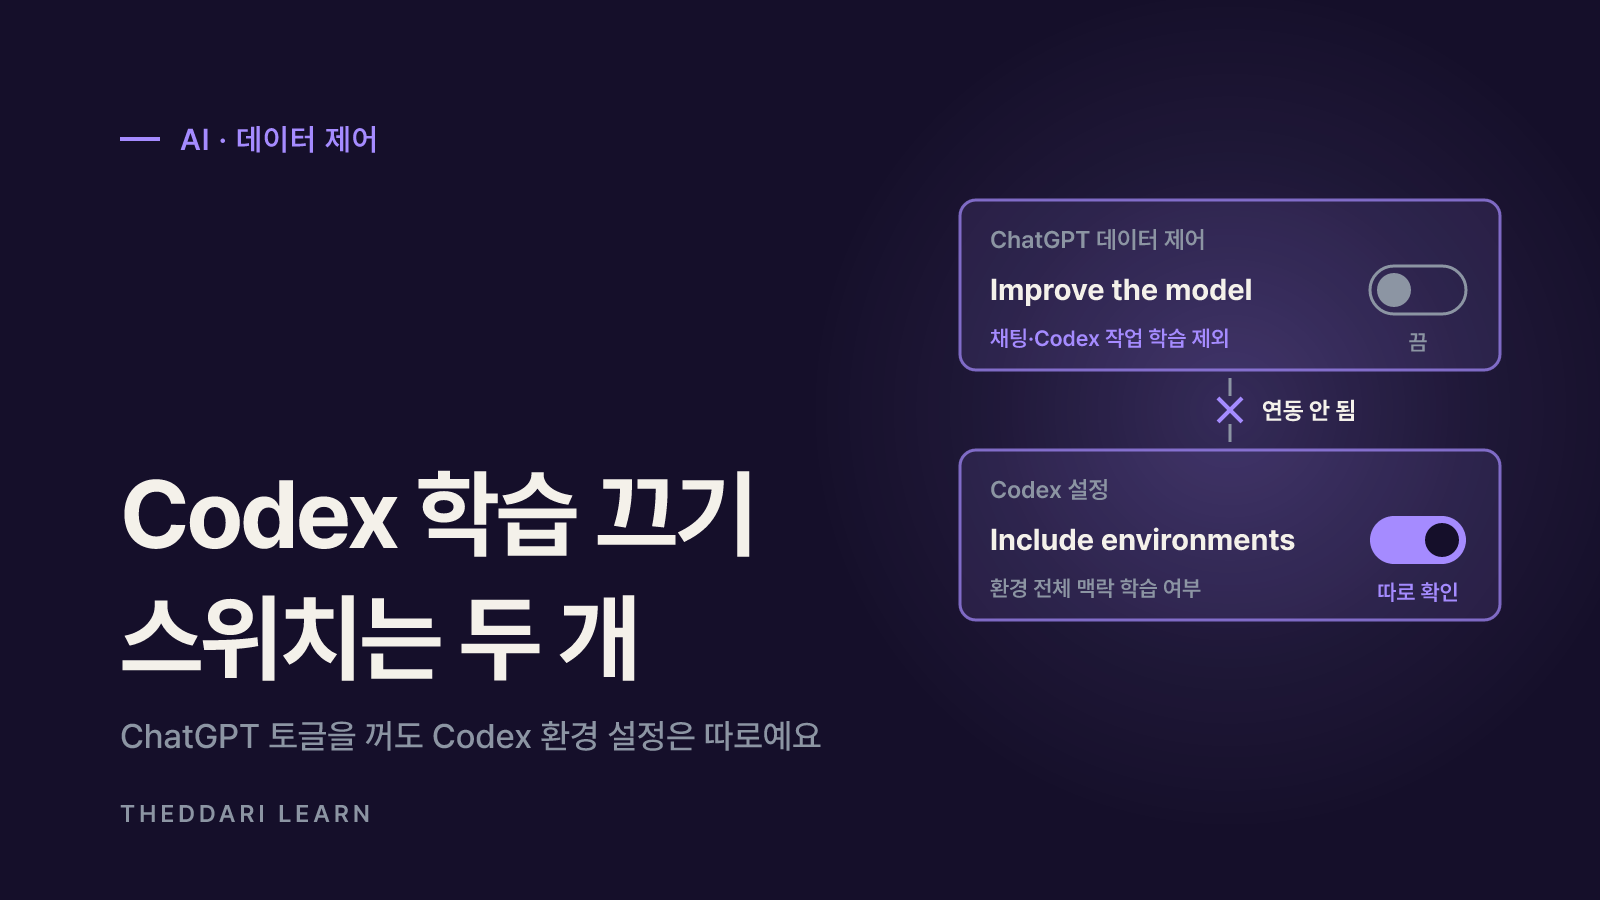
- 개인 ChatGPT 계정(Free·Plus·Pro)으로 로그인한 Codex는 기본적으로 학습 데이터 공유가 켜져 있고, ChatGPT 설정의 'Improve the model for everyone'이 Codex 작업에도 적용돼요.
- 2026년 11월 초 Hacker News에 '끈 설정이 다시 켜졌다'는 제보가 올라왔지만 '그대로 꺼져 있다'는 댓글도 많아요. 원인은 공식 확인되지 않았으니 자기 설정을 직접 확인하는 게 우선이에요.
- Codex에는 환경 전체를 학습에 쓸지 정하는 별도 'Include environments' 설정이 있고, ChatGPT 설정이나 개인정보 포털에서 끈다고 같이 꺼지지 않아요.
- 학습을 꺼도 좋아요·싫어요 피드백을 보내면 해당 대화 전체가 학습에 쓰일 수 있어요(개인 요금제 기준).
- Business·Enterprise·Edu 워크스페이스와 API 키 로그인은 기본적으로 학습에 쓰이지 않지만, API 키는 조직의 데이터 공유 설정을 따라요.
결론부터 말하면, 개인 ChatGPT 계정으로 로그인한 Codex의 대화와 작업은 기본 설정에서 OpenAI 모델 학습에 쓰일 수 있어요. Codex 학습 데이터 사용을 막으려면 ChatGPT 설정 → 데이터 제어에서 'Improve the model for everyone'을 끄고, Codex 설정의 'Include environments'도 따로 확인해야 해요. 이 글은 2026년 11월 4일에 확인한 OpenAI 도움말과 Codex 인증 문서를 기준으로 하며, 국가와 관계없이 OpenAI 계정 설정에 적용되는 내용이에요.
논란은 2026년 11월 초 Hacker News에 올라온 'OpenAI가 Codex 대화의 모델 학습을 조용히 다시 켜는 것 같다'는 게시물에서 시작됐어요. 아래에서 확인된 사실과 커뮤니티 주장을 나누고, 계정 유형별 차이와 점검 순서를 정리할게요.
Codex 학습 데이터 설정, 무엇이 논란인가
게시자는 회사 동료들과 함께 Codex·Claude Code 같은 도구의 데이터 공유를 모두 꺼 두었는데, 하루 전 Codex 쪽 설정이 다시 켜져 있는 것을 발견했다고 썼어요. 본인도 '증명할 수는 없다'고 밝히며 같은 일을 겪은 사람이 있는지 물었어요. 확인 시점에 게시물은 400점 넘는 추천과 100개 넘는 댓글을 받고 있었어요.
확인된 것과 확인되지 않은 것
확인됨
- 내용
- 개인 요금제는 학습 데이터 공유가 기본으로 켜져 있음
- 근거 수준
- OpenAI 공식 도움말
확인됨
- 내용
- ChatGPT 학습 설정이 Codex 작업에도 적용됨
- 근거 수준
- OpenAI 공식 도움말
커뮤니티 주장
- 내용
- 끈 설정이 사용자 모르게 다시 켜졌다
- 근거 수준
- HN 게시자·일부 댓글의 개인 관찰
반대 관찰
- 내용
- 설정이 그대로 꺼져 있다
- 근거 수준
- HN의 여러 댓글
미확인
- 내용
- 재활성화의 원인(버그·정책·사용자 실수)
- 근거 수준
- 확인한 공식 문서에 설명 없음
댓글 중에는 과거에 두 번 옵트아웃 요청이 처리된 기록이 있는데도 다시 켜져 있었다는 사례가 있고, 반대로 '꺼진 상태 그대로'라는 댓글도 여럿이에요. 이 글을 쓰는 시점까지 확인한 OpenAI 공식 문서에는 재활성화를 인정하거나 부정하는 설명이 없어요. 그러니 '모든 계정에서 일어난다'고 단정하기도, '아무 일 없다'고 넘기기도 어려워요. 실제로 할 수 있는 일은 자기 계정의 토글을 직접 확인하고 날짜를 기록하는 것이에요.
AI 업계 정책 변화는 빠르게 바뀌어요. 텔레그램 AI 채널 흐름에서 이런 이슈가 어떻게 번지는지 함께 보면 공식 발표가 나왔는지 놓치지 않는 데 도움이 돼요.

계정 유형별 Codex 학습 사용 여부
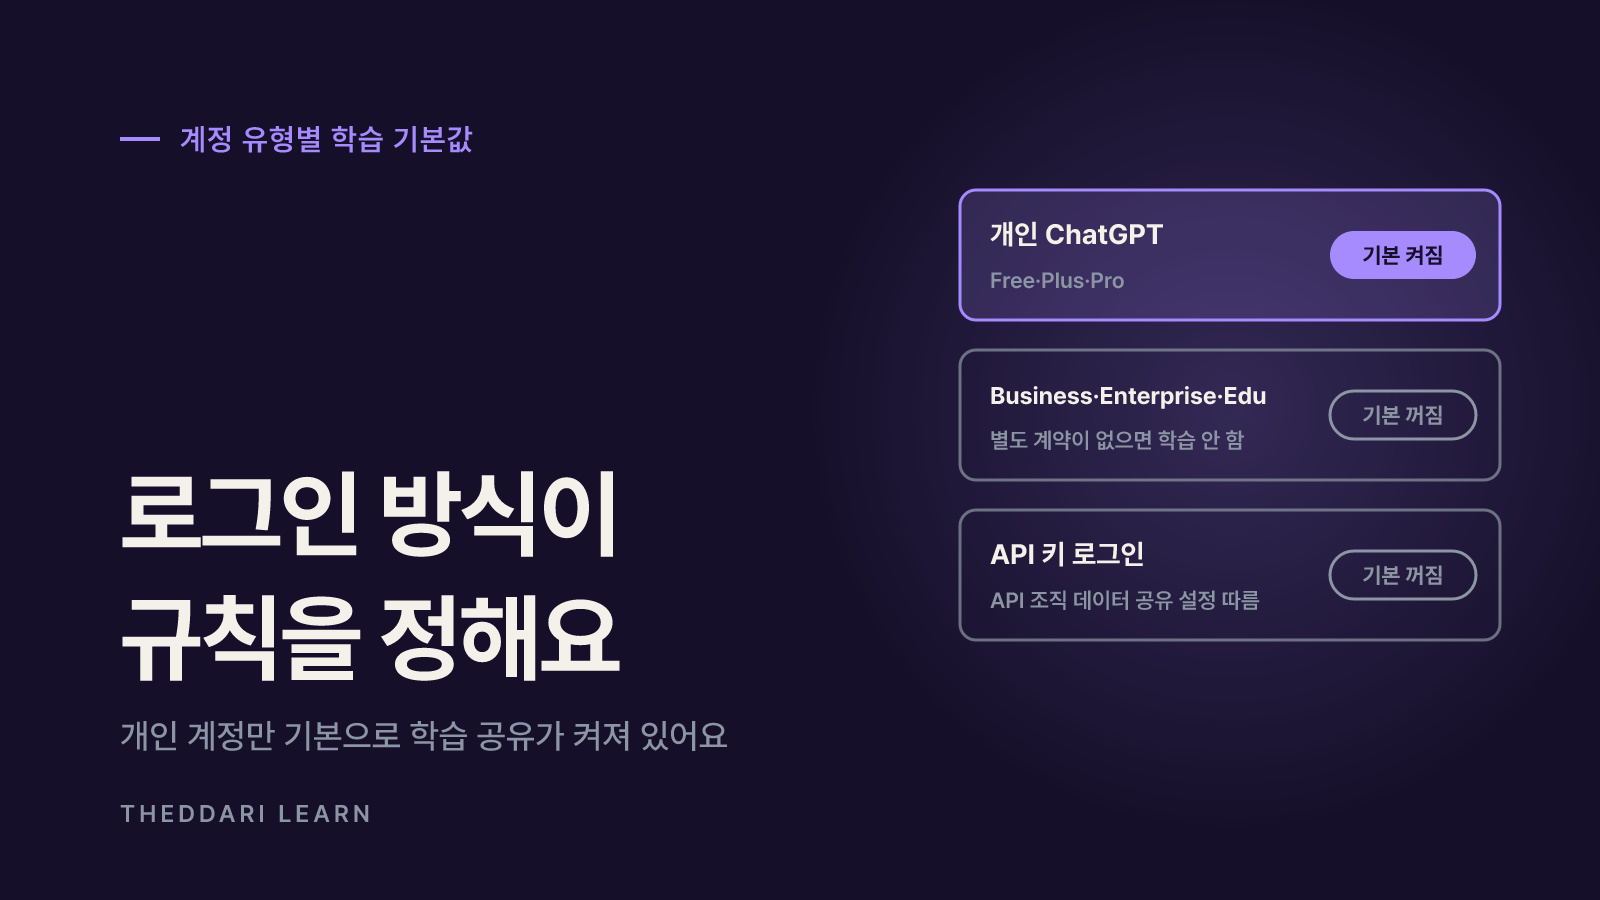
Codex에 어떤 방식으로 로그인했는지가 적용 규칙을 결정해요. Codex 인증 문서에 따르면 ChatGPT로 로그인하면 ChatGPT 워크스페이스의 권한과 보관 설정을, API 키로 로그인하면 API 조직의 보관·데이터 공유 설정을 따라요. Codex 클라우드는 ChatGPT 로그인이 필수예요.
개인 ChatGPT(Free·Plus·Pro)
- 기본 학습 사용
- 켜짐(사용 가능)
- 바꾸는 곳
- ChatGPT 설정 → 데이터 제어, 또는 개인정보 포털
ChatGPT Business·Enterprise·Edu
- 기본 학습 사용
- 사용 안 함
- 바꾸는 곳
- 별도 계약이 없는 한 학습 불가, 관리자 정책 적용
API 키 로그인
- 기본 학습 사용
- 사용 안 함
- 바꾸는 곳
- API 조직 소유자가 데이터 공유를 켤 수 있음
Codex 'Include environments'
- 기본 학습 사용
- 계정마다 확인 필요
- 바꾸는 곳
- Codex 설정에서 별도로 변경
모델 성능 개선 도움말은 개인 요금제에서 콘텐츠가 학습에 쓰일 수 있고, Business·Enterprise·Edu와 API의 입력·출력은 기본적으로 쓰지 않는다고 설명해요. 같은 사람이라도 회사 노트북에서는 회사 워크스페이스로, 집에서는 개인 계정으로 로그인했다면 적용 규칙이 달라져요. 이번 논란의 대상도 주로 개인 계정 쪽 토글이에요.
Computer Use 스크린샷도 같은 규칙
Codex 플랜 도움말은 ChatGPT 학습 데이터 제어가 Codex를 거친 콘텐츠, 즉 Computer Use가 찍은 스크린샷에도 적용된다고 밝혀요. 화면에 비밀번호 관리자나 사내 문서가 보이는 상태에서 Computer Use를 쓴다면 이 설정의 의미가 더 커져요.
Codex 학습 끄는 법: 단계별 점검
- 1
로그인 방식부터 확인
Codex CLI에서
codex login status를 실행하면 현재 인증 방식이 나와요. 데스크톱 앱·IDE 확장은 프로필 메뉴에서 활성 계정과 API 키 상태를 볼 수 있어요. 개인 계정인지 회사 워크스페이스인지 먼저 구분해요. - 2
ChatGPT 데이터 제어 끄기
웹에서 계정 메뉴 → 설정 → 데이터 제어로 들어가 'Improve the model for everyone'을 끄고 완료를 눌러요. 모바일은 사이드바 → 프로필 아이콘 → 데이터 제어 순서예요. 로그인 상태라면 웹·모바일 전체 계정에 적용돼요.
- 3
또는 개인정보 포털 사용
OpenAI 개인정보 포털에서 'Do not train on my content'를 골라도 돼요. 둘 중 하나만 해도 ChatGPT 대화와 Codex 작업에 충분하다고 안내돼 있어요.
- 4
Codex 'Include environments' 따로 확인
Codex 설정에는 환경 전체 맥락을 학습에 쓸지 정하는 'Include environments'가 있어요. ChatGPT 설정이나 포털을 바꿔도 이 값은 바뀌지 않으니 별도로 꺼야 해요.
- 5
확인 날짜 기록
설정 화면을 캡처하거나 확인한 날짜를 메모해 두세요. 이번 논란처럼 '다시 켜졌다'는 의심이 생길 때 비교할 기준이 돼요.
설정을 바꿔도 이미 저장된 대화는 그대로 기록에 남아요. 데이터 제어 도움말은 학습을 꺼도 채팅이 삭제되거나 숨겨지지 않으며, 보관(archive)한 채팅도 학습 여부는 계정 설정을 따른다고 설명해요. 지우고 싶다면 대화 삭제나 계정 삭제를 따로 해야 해요.
학습을 꺼도 남는 예외
- 피드백 버튼: 개인 요금제에서 응답에 좋아요·싫어요를 누르면 학습을 꺼 둔 상태여도 해당 대화 전체가 학습에 쓰일 수 있어요. Codex에서 피드백 요청 창이 뜨면 내용을 읽고 선택하세요.
- Trusted Access 세션: Daybreak Blue 같은 Trusted Access 프로그램 세션에서는 설정이 꺼져 있어도 사이버 오용 방지 안전장치 강화를 위해 콘텐츠가 쓰일 수 있다고 공식 도움말에 적혀 있어요. 그 밖의 활동에는 원래 설정이 적용돼요.
- 음성 모드: ChatGPT 음성 모드에는 학습 공유를 정하는 별도 설정이 있어요.
- OpenAI 지원 대화: 학습 설정이 켜져 있으면 고객 지원과의 대화도 서비스 개선에 쓰일 수 있어요.
- 안전 목적 보관: 임시 채팅은 학습에 쓰이지 않지만 안전 목적으로 최대 30일까지 보관될 수 있어요. 학습 차단과 데이터 미보관은 다른 개념이에요.
정리하면 'Improve the model for everyone'을 끄는 것은 학습 사용을 막는 핵심 스위치이지만, 서버에 데이터가 전혀 남지 않는다는 뜻은 아니에요. Hacker News 댓글에서도 학습 차단과 보관·분석은 별개라는 지적이 나왔어요. 회사 비밀 코드처럼 유출되면 곤란한 자료라면 설정 하나에만 기대지 않는 편이 안전해요.
회사·팀 개발자가 추가로 할 일
- 팀원이 개인 계정과 회사 워크스페이스 중 무엇으로 Codex에 로그인하는지 목록을 만들어요. 관리형 환경에서는
forced_login_method,forced_chatgpt_workspace_id같은 관리 설정으로 로그인 방식을 고정할 수 있어요. - API 키 워크플로라면 API 조직의 데이터 공유 설정을 소유자가 직접 확인해요.
- 개인 계정을 허용한다면 주기적으로 데이터 제어 화면을 점검하는 일정을 정해요.
~/.codex/auth.json에는 액세스 토큰이 평문으로 저장될 수 있으니 저장소에 커밋하거나 채팅에 붙여 넣지 않아요.
AI 코딩 도구의 데이터 정책 논란은 블로그와 커뮤니티에서 먼저 퍼지는 경우가 많아요. 블로그 트렌드에서 같은 주제를 다룬 글이 늘어나는지 보면 공식 해명이나 후속 보도를 찾는 단서가 돼요.
마지막으로 점검 순서를 다시 정리하면 이래요. 로그인 방식 확인 → 데이터 제어 토글 끄기(또는 개인정보 포털) → Codex 'Include environments' 확인 → 피드백 버튼 사용 주의 → 확인 날짜 기록. 이번 재활성화 제보가 버그인지 정책 문제인지는 아직 공식 확인되지 않았으니, 후속 공지가 나오면 이 순서대로 다시 확인해 보세요.