바이두 Unlimited-OCR이란? 오픈 OCR 모델로 문서를 텍스트로 바꾸는 법
바이두 Unlimited-OCR의 구조와 MIT 라이선스, 8GB GPU 실행 조건, PDF를 마크다운으로 바꾸는 단계와 정확도 검증법을 2026년 10월 기준으로 정리했어요.
목차8개 섹션
핵심 요약
- Unlimited-OCR은 바이두가 2026년 6월 22일 공개한 문서 OCR 모델로, DeepSeek-OCR을 기반으로 디코더 어텐션을 R-SWA로 바꿔 긴 문서에서도 메모리 사용량이 늘지 않도록 했어요.
- 총 3B·활성 0.5B 파라미터 MoE 구조이고 모델 카드 기준 MIT 라이선스예요. vLLM 레시피는 BF16 추론에 8GB 이상 VRAM의 GPU 한 장이면 충분하다고 안내해요.
- 논문은 OmniDocBench v1.5 종합 93.23점(DeepSeek-OCR 87.01점)을 보고하지만 자체 보고 수치라서 내 문서로 다시 확인해야 해요.
- PDF는 페이지 이미지로 바꾼 뒤 base 모드로 넣고, 결과의 좌표 태그를 정리해 마크다운으로 써요. 프롬프트의 <image> 접두어와 n-gram 처리기를 빠뜨리면 빈 출력이나 반복이 생겨요.
- 한국어 지원 범위는 모델 카드에 명시돼 있지 않아요. 영수증·재무 문서 같은 실제 샘플로 편집거리와 숫자 일치율을 직접 재는 게 안전해요.
Unlimited-OCR은 바이두가 2026년 6월 22일 공개한 오픈 문서 OCR 모델이에요. 스캔본·PDF·사진 속 글자를 읽어 표와 수식, 읽기 순서까지 살린 텍스트·마크다운으로 바꿔 주며, 수십 쪽짜리 문서를 페이지별로 쪼개지 않고 한 번에 처리하도록 설계됐어요. 이 글은 2026년 10월 기준 허깅페이스 모델 카드와 기술 보고서를 바탕으로 구조, 라이선스, 필요 사양, 실제 실행 단계, 그리고 내 문서로 정확도를 검증하는 방법을 정리해요.
허깅페이스 트렌딩 상위권에 오른 모델이라 관심이 높지만, 벤치마크 점수는 개발사가 직접 보고한 값이에요. 영수증이나 재무제표처럼 숫자 하나가 중요한 문서에 쓰려면 아래 검증 단계를 꼭 거치는 게 좋아요.
Unlimited-OCR이란? 핵심 구조 한눈에 보기
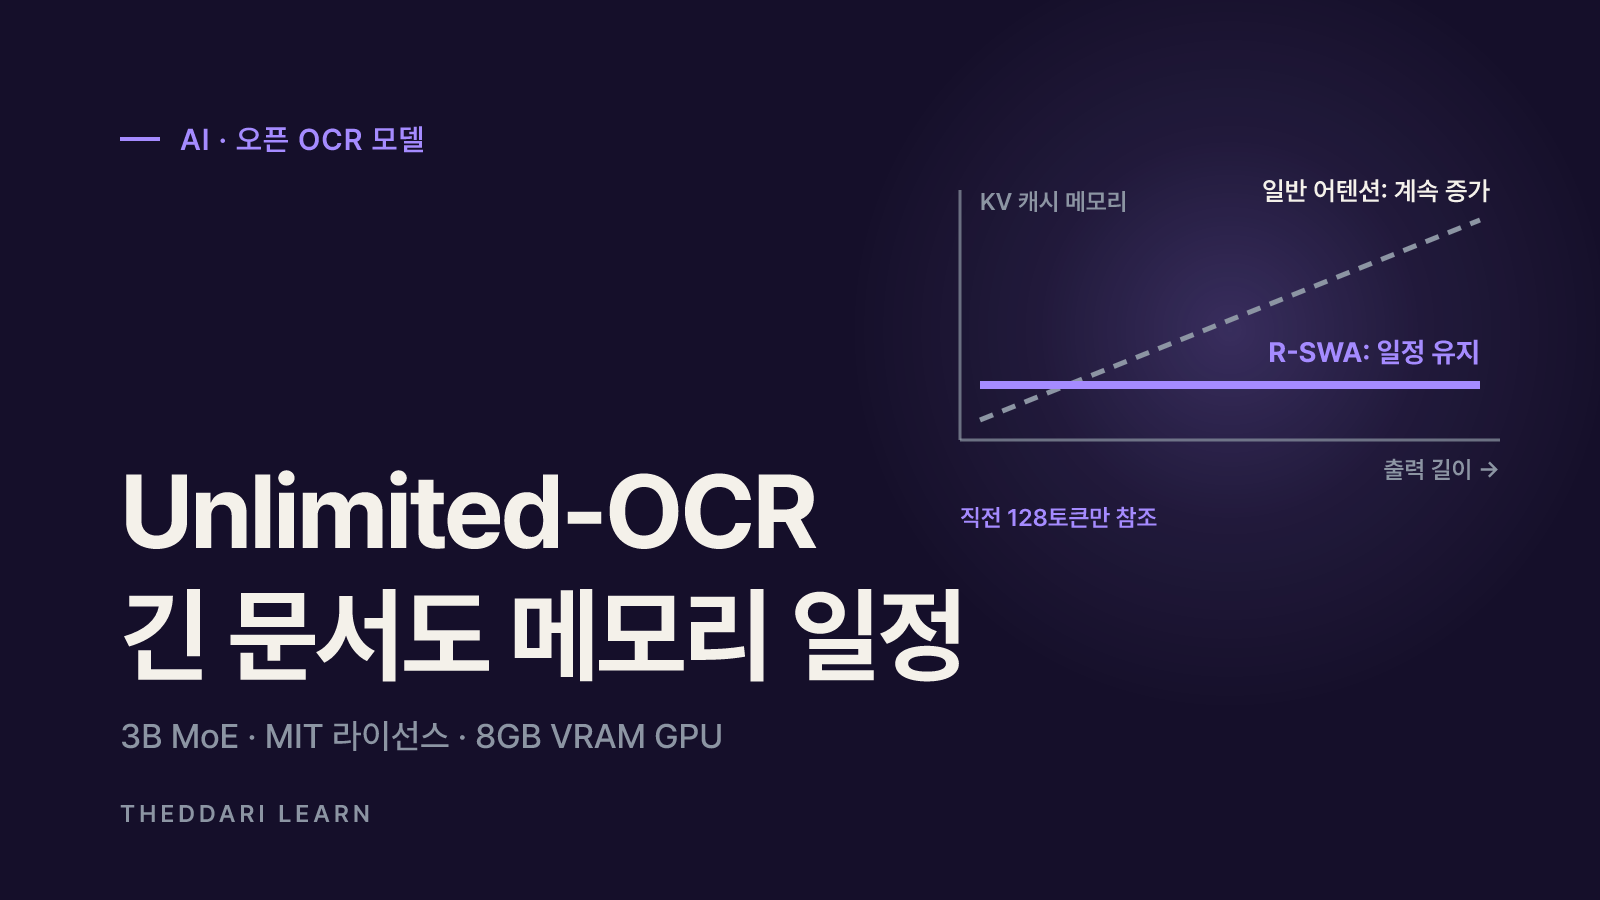
Unlimited-OCR은 DeepSeek-OCR을 출발점으로 삼았어요. 이미지를 압축해 읽는 DeepEncoder는 그대로 두고, 글자를 생성하는 디코더의 모든 어텐션 층을 바이두가 제안한 R-SWA(Reference Sliding Window Attention)로 바꿨어요. 보고서에 따르면 모델은 총 3B, 추론 시 활성 0.5B 파라미터인 MoE 구조예요.
R-SWA가 해결하려는 문제
일반적인 LLM 기반 OCR은 출력이 길어질수록 앞서 만든 글자를 모두 KV 캐시에 쌓아 두기 때문에 메모리 사용량이 늘고 생성 속도가 느려져요. R-SWA는 페이지 이미지 토큰과 프롬프트는 끝까지 전부 참조하되, 이미 출력한 글자는 직전 128개 토큰만 보도록 제한해요. 사람이 책을 베껴 쓸 때 원본 전체와 방금 쓴 몇 글자만 보는 방식과 비슷하다는 설명이에요. 그 결과 디코딩 내내 KV 캐시 크기가 일정하게 유지돼요.
모델 카드에서 확인한 기본 정보
| 항목 | 내용 (2026년 10월 기준) |
|---|---|
| 공개일 | 2026년 6월 22일 (논문 arXiv 2606.23050, 6월 23일 게시) |
| 라이선스 | MIT (허깅페이스·GitHub 표기) |
| 모델 크기 | 총 3B / 활성 0.5B, BF16 safetensors |
| 기반 모델 | DeepSeek-OCR (DeepEncoder 유지) |
| 최대 길이 | 32K 토큰 (32,768) |
| 실행 방식 | Transformers(trust_remote_code), vLLM 전용 이미지, SGLang |
| 입력 모드 | 단일 이미지 gundam(크롭) 또는 base, 다중 페이지·PDF는 base만 |
| 배포처 | 허깅페이스, ModelScope, 바이두 클라우드(2026년 7월 3일 추가) |
GitHub 저장소는 확인 시점에 약 2.7만 스타를 받았고, 허깅페이스의 지난달 다운로드는 120만 회를 넘었어요. 인기는 품질의 근거가 아니지만 커뮤니티 양자화·파인튜닝 버전이 빠르게 늘고 있다는 뜻이기도 해요.
성능 수치는 어떻게 읽어야 하나
기술 보고서 본문은 문서 파싱 벤치마크 OmniDocBench에서 다음 결과를 보고해요. 텍스트 편집거리는 낮을수록, 종합 점수는 높을수록 좋아요.
OmniDocBench v1.5 종합
- Unlimited-OCR
- 93.23
- 비교 대상
- DeepSeek-OCR 87.01, Gemini-2.5 Pro 88.03
v1.5 텍스트 편집거리
- Unlimited-OCR
- 0.038
- 비교 대상
- DeepSeek-OCR 0.073
v1.5 표 TEDS
- Unlimited-OCR
- 90.93
- 비교 대상
- DeepSeek-OCR 84.97
OmniDocBench v1.6 종합
- Unlimited-OCR
- 93.92
- 비교 대상
- Qianfan-OCR 93.90, Logics-Parsing-v2 93.33
v1.6에서는 2~4B급 경쟁 모델과 차이가 0.02~0.6점 수준이라 '압도적'이라고 보기는 어려워요. 또 허깅페이스 평가 결과 칸에 표시된 LlamaIndex의 ParseBench에서는 평균 46.17점, 텍스트 내용 86.81점이 기록돼 있어 벤치마크마다 그림이 달라요. 어떤 문서에서 강하고 약한지는 내 데이터로만 알 수 있어요.
여러 페이지를 한 번에 넣을 때의 정확도
보고서의 사내 테스트에서 페이지 수에 따른 편집거리는 2쪽 0.0362, 10쪽 0.0526, 20쪽 0.0572, 40쪽 이상 0.1069였어요. 40쪽을 넘기면 오류가 약 3배로 늘어난 셈이에요. 연구진은 다중 페이지에서 쓰는 base 모드(1024×1024)가 작은 글씨를 잘 읽지 못한 것을 주원인으로 꼽았어요.
이름과 달리 페이지 수가 무제한은 아니에요. 보고서도 32K 컨텍스트에서는 페이지 이미지를 먼저 넣는 프리필 길이가 계속 늘어나 진짜 무제한 파싱은 불가능하다고 한계를 밝혀요.
Unlimited-OCR로 PDF를 텍스트로 바꾸는 단계
공식 문서가 제시하는 경로는 Transformers, vLLM, SGLang 세 가지예요. 처음 써 본다면 단일 이미지로 동작을 확인한 뒤 PDF로 넓히는 순서가 편해요.
- 1
환경 준비
NVIDIA GPU가 필요해요. 모델 카드의 Transformers 예시는 Python 3.12.3, CUDA 12.9, torch 2.10.0, transformers 4.57.1에서 테스트됐어요. vLLM 레시피는 BF16 추론에 8GB 이상 VRAM의 GPU 한 장이면 충분하다고 안내하고, 아직 정식 pip 휠이 아니라 전용 Docker 이미지로 서빙해요.
- 2
모델 불러오기
Transformers에서는 AutoModel과 AutoTokenizer를 trust_remote_code=True로 불러와요. 모델 저장소의 파이썬 코드가 내 컴퓨터에서 실행된다는 뜻이므로, 검토한 커밋 해시를 revision으로 고정하는 게 안전해요.
- 3
단일 이미지 테스트
영수증 사진 한 장처럼 단일 이미지는 gundam 모드(base_size 1024, image_size 640, 크롭 사용)를 쓰고 프롬프트는 '<image>document parsing.'으로 시작해요. 반복 방지를 위해 n-gram 크기 35, 창 크기 128을 설정해요.
- 4
PDF 변환
PDF는 PyMuPDF로 각 페이지를 300dpi 이미지로 바꾼 뒤 infer_multi에 넣어요. 다중 페이지는 base 모드(image_size 1024)만 지원하고 n-gram 창 크기는 1024로 늘려요.
- 5
출력 정리
원본 출력에는 <|ref|>, <|det|> 같은 위치 태그와 좌표가 섞여 있어요. 레시피 안내대로 ref 안의 텍스트만 남기고 det 좌표를 지우면 깔끔한 마크다운이 돼요. 좌표가 필요하면 별도로 보관해 원문 위치 확인용으로 써요.
자주 나는 오류
- 출력이 비어 있다면 프롬프트 앞의 <image> 접두어가 빠졌거나 skip_special_tokens가 True로 남아 있는 경우가 대부분이에요.
- 긴 문서에서 좌표 태그가 반복되며 멈추지 않으면 n-gram 로짓 처리기를 등록하지 않은 거예요.
- OCR은 이미지 재사용 이점이 없어 vLLM 레시피는 프리픽스 캐싱과 멀티모달 캐시를 끄도록 권해요.
영수증·재무 문서 디지털화에 쓰기 전 확인할 것
OCR 결과를 회계 처리나 투자 리서치에 바로 쓰면 숫자 하나의 오인식이 큰 오류로 번져요. 종단간 OCR은 언어 모델이 글자를 생성하기 때문에 흐린 숫자를 문맥상 그럴듯한 값으로 채울 수 있어요. 도입 전에 다음 항목을 점검해 보세요.
- 언어 범위: 모델 카드에는 multilingual 태그만 있고 지원 언어 목록이나 한국어 정확도는 공개돼 있지 않아요. 한글 영수증·세금계산서 샘플로 먼저 시험하세요.
- 정답 세트 만들기: 실제 업무 문서 20~50장을 골라 사람이 정확한 텍스트를 입력해 두고 기준으로 삼아요.
- 지표 측정: 문자 단위 편집거리와 함께 금액·날짜·계좌번호 같은 핵심 필드의 완전 일치율을 따로 재요. 전체 편집거리가 낮아도 숫자 필드가 틀리면 쓸 수 없어요.
- 표 구조 확인: 재무제표는 셀 병합과 열 순서가 중요해요. 마크다운 표의 행·열 수가 원본과 같은지 확인하세요.
- 검수 흐름: 합계가 맞지 않거나 신뢰도가 낮은 페이지는 사람이 보도록 규칙을 정해요.
상장사 실적 자료를 직접 읽어 정리하는 경우라면 어닝 캘린더에서 발표 일정을 먼저 확인하고, 공시 PDF를 받은 뒤 OCR 결과의 매출·이익 숫자를 원문과 대조하는 식으로 쓰면 돼요. OCR은 입력 작업을 줄여 줄 뿐 숫자의 정확성을 보장하지 않아요.
보안과 개인정보
로컬 GPU에서 돌리면 문서가 외부 서버로 나가지 않는 장점이 있어요. 반대로 허깅페이스 스페이스 데모나 클라우드 API에 올리면 그 서비스의 약관과 보관 정책을 따르게 되니, 주민등록번호·계좌 정보가 담긴 문서는 올리지 않는 게 좋아요. Transformers 문서도 trust_remote_code로 커스텀 모델을 불러올 때는 악성 코드 실행에 주의하고 특정 리비전을 고정하라고 권해요.
기존 OCR 도구와 비교해 고르는 기준
처리 방식
- 전통 OCR·파이프라인형
- 검출·인식을 단계별로 수행
- Unlimited-OCR (종단간)
- 한 모델이 페이지 전체를 마크다운으로 생성
표·수식
- 전통 OCR·파이프라인형
- 별도 모듈 필요한 경우가 많음
- Unlimited-OCR (종단간)
- 표·수식·읽기 순서를 함께 출력
긴 문서
- 전통 OCR·파이프라인형
- 페이지마다 독립 처리
- Unlimited-OCR (종단간)
- 수십 쪽 한 번에 처리 가능(정확도는 하락)
하드웨어
- 전통 OCR·파이프라인형
- CPU로도 가능한 도구가 많음
- Unlimited-OCR (종단간)
- NVIDIA GPU 권장, 8GB 이상 VRAM
오류 유형
- 전통 OCR·파이프라인형
- 글자 깨짐·누락
- Unlimited-OCR (종단간)
- 그럴듯한 오인식 가능성
스캔 품질이 좋고 형식이 단순한 문서를 대량으로 처리한다면 기존 도구로도 충분할 수 있어요. 표가 많은 보고서, 수식이 섞인 논문, 여러 페이지에 걸친 계약서처럼 구조를 살려야 하는 문서라면 Unlimited-OCR을 후보로 두고 같은 샘플로 두 방식을 나란히 비교해 보세요.
새 OCR·문서 AI 모델은 몇 주 단위로 등장해요. AI 텔레그램 트렌드와 블로그 트렌드에서 관련 모델 소식이 얼마나 언급되는지 함께 살펴보면 대안 모델을 놓치지 않는 데 도움이 돼요.
정리: 도입 전 체크리스트
- MIT 라이선스 여부를 원본 저장소에서 확인하고, 파생 모델은 별도 라이선스를 봐요.
- 8GB 이상 VRAM의 NVIDIA GPU와 권장 버전 환경을 준비해요.
- 프롬프트 <image> 접두어, skip_special_tokens=False, n-gram 설정을 지켜요.
- 긴 PDF는 한 번에 넣기보다 20쪽 안팎으로 나눠 정확도 하락을 줄여요.
- 내 문서 정답 세트로 편집거리와 숫자 필드 일치율을 직접 측정한 뒤 업무에 넣어요.