Astra 가중치 공간 프로그래밍이란? Qwen 가중치 직접 수정 실험과 한계
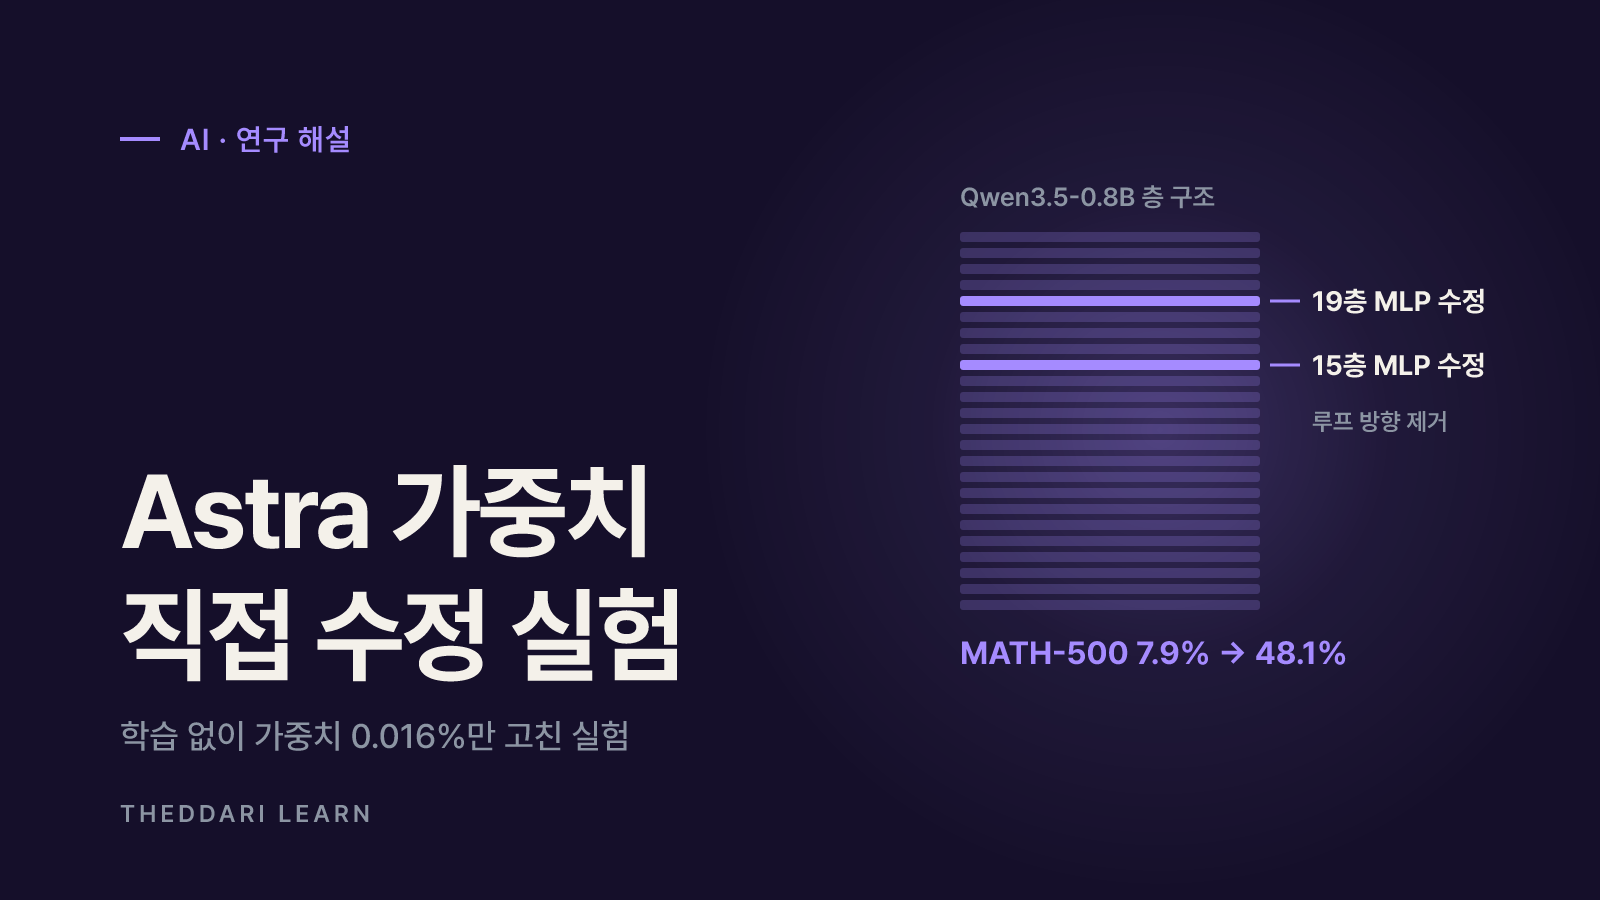
Astra 가중치 공간 프로그래밍 실험을 정리했어요. 학습 없이 Qwen3.5-0.8B 가중치 0.016%를 고쳐 MATH-500이 7.9%에서 48.1%로 오른 과정과 재현성·한계를 설명해요.
목차8개 섹션
핵심 요약
- Astra 가중치 공간 프로그래밍은 범용 LLM이 경사하강법·학습 데이터 없이 다른 신경망의 가중치를 직접 읽고 수정하는 방식이에요(2026년 11월 2일 MIT CSAIL 블로그).
- Astra는 Qwen3.5-0.8B 가중치 131,072개(0.016%)를 고쳐 MATH-500을 7.9%에서 48.1%로, IFEval을 21.0%에서 62.3%로 올렸어요(순전파 50회 예산).
- 개선의 핵심은 수학 능력 추가가 아니라 '생각 루프' 제거였어요. 루프가 거의 없는 Gemma 3 270M에서는 MATH-500이 6.8%에서 최고 7.7%에 그쳤어요.
- 동료 심사 전 블로그 보고이고 소형 모델에 한정돼요. 공개 체크포인트 재평가(51.0%)는 점수를 재현했지만 편집 과정 자체의 재현은 아니에요.
Astra 가중치 공간 프로그래밍(Weight-Space Programming)은 범용 대형 언어 모델(LLM)이 경사하강법 같은 학습 루프 없이 다른 신경망의 가중치를 직접 읽고 고치는 방식이에요. MIT CSAIL 연구진이 2026년 11월 2일 공개한 블로그 글에 따르면, 'GPT-6 Astra'라고 불린 모델이 Qwen3.5-0.8B 가중치의 0.016%(131,072개)를 고쳐 MATH-500 정답률을 7.9%에서 48.1%로 올렸어요. 다만 동료 심사를 거치지 않은 초기 실험이고, 모델에 없던 능력을 새로 넣었다기보다 '생각 루프'라는 장애물을 걷어낸 것에 가까워요. 이 글은 2026년 11월 기준으로 원문과 공개 체크포인트를 확인해 의미와 한계를 정리해요.
Astra 가중치 공간 프로그래밍이란 무엇인가요
보통 신경망 가중치는 Adam 같은 최적화 알고리즘이 데이터와 손실 함수의 기울기를 따라 조금씩 바꿔요. 사람이 수많은 숫자를 보고 직접 고치는 건 사실상 불가능하다고 여겨 왔죠. 연구진은 이 전제를 뒤집어, LLM이 '수학을 더 잘하게 해 줘' 같은 자연어 목표를 받고 가중치 각 부분이 무엇을 계산하는지 추론한 뒤 그에 맞춰 숫자를 바꾸는 접근을 가중치 공간 프로그래밍이라고 불렀어요.
읽기·고치기·처음부터 쓰기 세 갈래
- 읽기: 가중치만 보고 그 신경망이 어떤 게임을 학습했는지, 어떤 도형을 그리는 확산 모델인지, 어떤 언어로 학습한 언어 모델인지 맞히는 실험이에요.
- 고치기: 실패하는 강화학습 정책이나 Qwen3.5-0.8B 같은 실제 언어 모델의 가중치 일부를 바꿔 행동을 고치는 실험이에요.
- 처음부터 쓰기: 모든 가중치가 0인 신경망에 게임 규칙만 보고 숫자를 써 넣어 MinAtar 게임이나 9×9 바둑을 두게 하는 실험이에요.
핵심 조건은 Astra가 학습 루프를 돌리지 않았다는 점이에요. 기울기 계산과 데이터에 가중치를 맞추는 피팅은 금지됐고, 일부 실험에서만 정해진 횟수의 순전파(forward pass)로 결과를 관찰할 수 있었어요. 즉 '훈련 코드를 대신 짜 주는 AI'가 아니라 '가중치를 직접 해석하고 편집하는 AI'를 시험한 거예요.
Astra는 어떤 모델인가요
원문은 Astra를 'GPT-6 Astra'라는 프런티어 LLM으로만 소개하고, 일반 사용자가 어떻게 접근할 수 있는지는 설명하지 않아요. 그래서 이 실험을 지금 누구나 쓸 수 있는 기능으로 받아들이기보다, 최상위 모델의 잠재 능력을 보여 주는 연구 보고로 읽는 편이 맞아요.
파인튜닝·기존 모델 편집과 무엇이 다른가요
모델을 바꾸는 방법은 이전에도 여러 가지가 있었어요. 차이는 누가, 무엇을 근거로 가중치를 바꾸느냐예요.
파인튜닝
- 가중치를 바꾸는 주체
- 옵티마이저(경사하강법)
- 필요한 것
- 학습 데이터·손실 함수·GPU 연산
- 바뀌는 범위
- 전체 또는 어댑터 가중치
ROME 같은 모델 편집
- 가중치를 바꾸는 주체
- 사람이 설계한 전용 알고리즘
- 필요한 것
- 바꿀 사실·인과 추적
- 바뀌는 범위
- 중간 층 피드포워드 일부(랭크 1 수정)
가중치 공간 프로그래밍
- 가중치를 바꾸는 주체
- 범용 LLM의 추론
- 필요한 것
- 자연어 목표·가중치·(선택) 순전파 예산
- 바뀌는 범위
- 실험마다 다름, Qwen은 0.016%
2022년 발표된 ROME 논문은 GPT 계열 모델에서 사실 기억이 중간 층 피드포워드 모듈에 국소적으로 저장된다는 근거를 찾고, 그 가중치를 랭크 1로 수정해 특정 사실을 바꿨어요. 이런 기계적 해석 가능성(mechanistic interpretability) 연구는 사람이 목적에 맞는 도구를 설계했다는 점이 핵심이에요. Astra 실험의 새로운 점은 따로 훈련한 판독 모델이 아니라 범용 LLM이 그 자리에서 추론과 Python 분석으로 가중치를 해석하고 수정했다는 데 있어요.
파인튜닝이 '연습을 많이 시켜 습관을 바꾸는 것'이라면, 가중치 공간 프로그래밍은 '회로도를 읽고 문제가 되는 배선 몇 개를 바꾸는 것'에 가까워요. 다만 비유일 뿐이고, 큰 모델의 회로 전체를 이해했다는 뜻은 아니에요.
Qwen3.5-0.8B 수학 점수는 어떻게 올랐나요
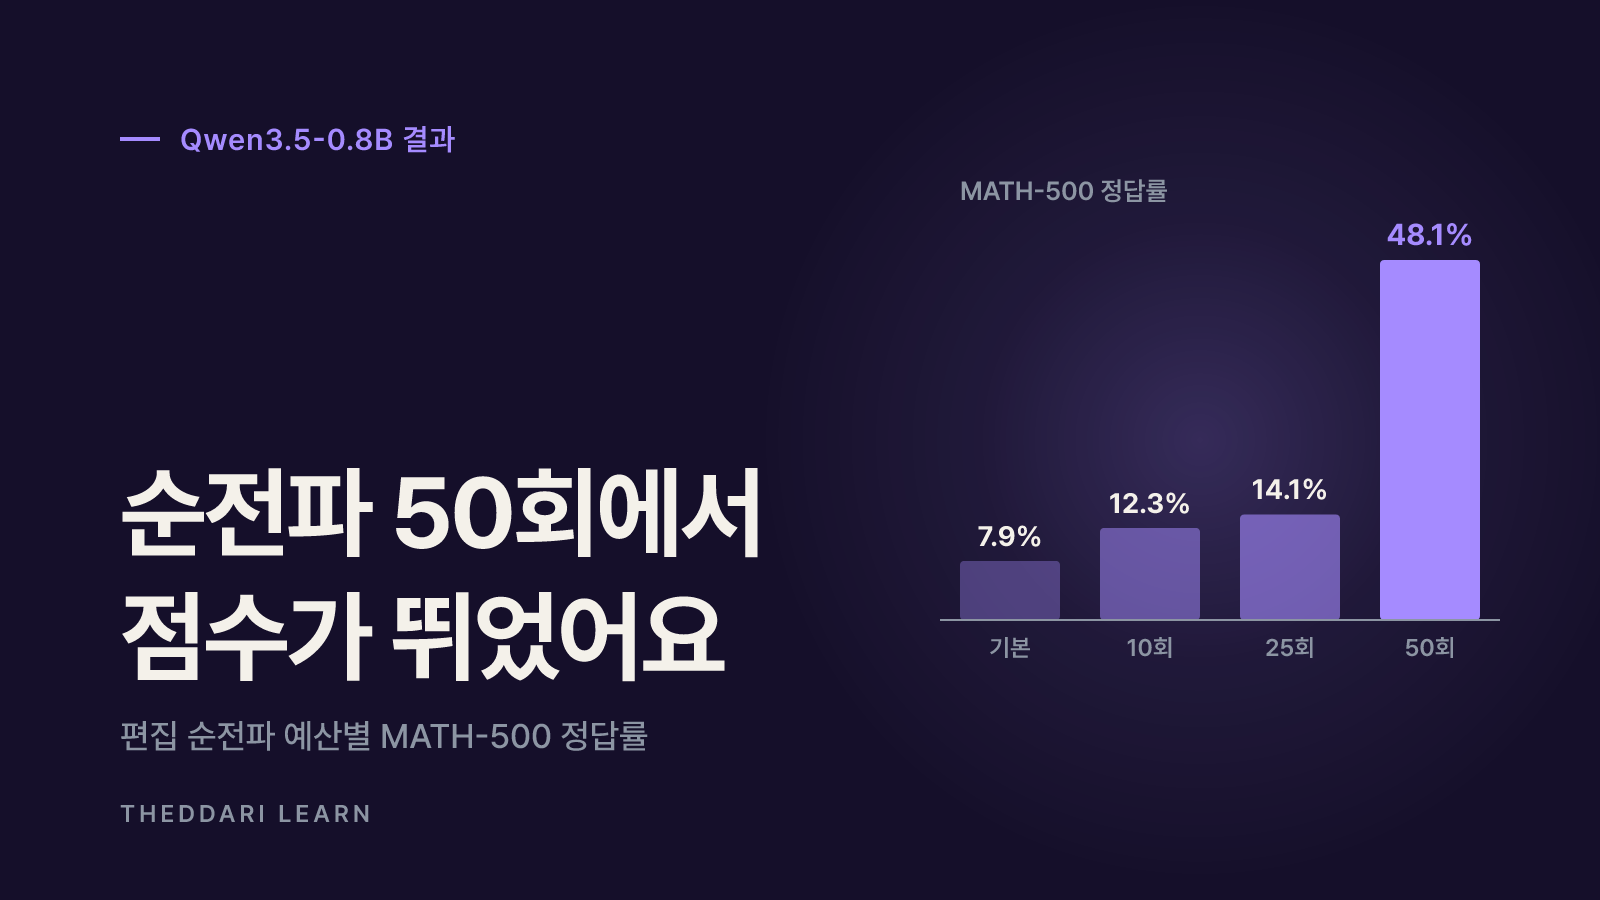
가장 많이 인용되는 8번 실험이에요. Astra는 GPU 없이 가중치가 올라간 Python 세션을 받고, GSM8K·MATH 학습용 연습 문제에 10회·25회·50회의 순전파 예산을 썼어요. 점수를 매기는 테스트 문제는 보지 못했어요.
Astra가 찾은 원인은 작은 추론 모델에서 흔한 생각 루프였어요. 기본 모델은 같은 문장을 반복하다 32,768토큰 한도에 걸리는 경우가 많았는데, Astra는 이를 15층·19층 MLP가 쓰는 한 방향(direction)으로 추적해 각 층 출력 열 64개에서 그 방향을 빼냈어요. 바뀐 가중치는 131,072개, 전체의 0.016%예요.
기본 모델
- MATH-500
- 7.9%
- GSM8K
- 13.8%
- IFEval
- 21.0%
- 토큰 한도 도달
- 93.0%
편집, 순전파 10회
- MATH-500
- 12.3%
- GSM8K
- 25.7%
- IFEval
- 49.0%
- 토큰 한도 도달
- 87.2%
편집, 순전파 25회
- MATH-500
- 14.1%
- GSM8K
- 25.1%
- IFEval
- 39.9%
- 토큰 한도 도달
- 86.4%
편집, 순전파 50회
- MATH-500
- 48.1%
- GSM8K
- 67.1%
- IFEval
- 62.3%
- 토큰 한도 도달
- 33.1%
표에서 눈여겨볼 점은 순전파 25회까지는 루프가 거의 줄지 않다가 50회에서 토큰 한도 도달 비율이 크게 떨어졌다는 거예요. 루프는 수학만의 문제가 아니어서 지시 따르기 점수인 IFEval도 함께 올랐어요. 반대로 순전파 예산이 적을 때 IFEval이 25회보다 10회에서 더 높게 나온 것처럼, 편집 결과가 예산에 따라 고르게 움직이지는 않았어요.
공개 체크포인트로 다시 돌려 본 결과
편집된 모델은 허깅페이스에 Apache 2.0으로 공개됐어요. 모델 카드에 따르면 원본과 달라진 텐서는 15층·19층 down_proj 두 개뿐이고, 재구성한 텐서를 SHA-256 해시로 검증했어요. 허깅페이스 쪽에서 같은 평가 설정으로 MATH-500 500문제×4샘플(2,000회 생성)을 다시 돌린 결과는 51.0%, 토큰 한도 도달 31.6%로 원문 수치와 비슷했어요. 다만 이는 이미 만들어진 체크포인트의 점수를 재현한 것이지, Astra가 같은 편집을 다시 찾아내는 과정을 재현한 것은 아니에요.
8가지 실험이 보여 준 것과 실패한 것
원문은 작은 신경망에서 시작해 실제 언어 모델까지 8개 실험을 보고해요. 성공 사례만 보면 과장되기 쉬워서 실패와 조건을 함께 봐야 해요.
1. 게임 판별
- 규모
- 가중치 17,253개
- 결과
- 4개 게임 모두 맞힘
- 조건·한계
- 도구 없음, 게임 후보 미제공
2. 도형 판별
- 규모
- 가중치 23,824개
- 결과
- 도형은 맞혔지만 채워진 도형을 윤곽선으로 그림
- 조건·한계
- 순전파 금지
3. 언어 판별
- 규모
- 가중치 716만 개
- 결과
- 3개 언어와 복사 헤드 모두 맞힘
- 조건·한계
- 입력·출력 층 제거
4. 자동차 정책 수정
- 규모
- 가중치 171,664개
- 결과
- 3.5% 수정, 1,024회 모두 성공
- 조건·한계
- 한 번의 답변, 도구 없음
5. 게임 신경망 작성
- 규모
- 모든 가중치 0에서 시작
- 결과
- Breakout 517.4점(PPO 5억 스텝 25.3점)
- 조건·한계
- Seaquest·Asterix는 5억 스텝 PPO보다 낮음
6. 9×9 바둑
- 규모
- 가중치 1,480,274개
- 결과
- 순전파 50회에서 같은 크기 PPO를 이김
- 조건·한계
- 트리 탐색·학습 금지
7. 아첨 모델 판별
- 규모
- Gemma 3 270M
- 결과
- 가중치만으로는 4번 모두 실패
- 조건·한계
- 어텐션 패턴을 보면 3쌍 모두 성공
8. 수학 개선
- 규모
- Qwen3.5-0.8B
- 결과
- MATH-500 7.9%→48.1%
- 조건·한계
- 순전파 50회 예산
Gemma 3 270M에서는 효과가 없었어요
연구진은 루프가 거의 없는 Gemma 3 270M(토큰 한도 도달 8.5%)으로도 수학 개선을 시도했지만, MATH-500은 기본 6.8%에서 최고 7.7%에 그쳤어요. Astra가 찾은 오류는 계산 실수·잘못된 대수 전개 같은 평범한 추론 오류였고, 꺼 버릴 단일 부품이 없었어요. 원문은 이를 '가중치 편집이 능력을 가리던 장애물은 없앨 수 있었지만, 모델에 없던 능력을 더하지는 못했다'고 정리해요. Qwen 결과를 '수학 능력을 새로 심었다'로 읽으면 안 되는 이유예요.
한계와 재현성·안전성에서 확인할 점
기준점이 낮게 잡혔을 가능성
Qwen 공식 모델 카드는 사고 모드에서 0.8B 모델이 다른 Qwen3.5 모델보다 생각 루프에 빠지기 쉽다고 경고하고, 샘플링 파라미터 조정과 스트리밍 중 이상 생성 감지·중단을 권해요. 같은 카드가 보고한 사고 모드 IFEval은 44.0인데, 원문 실험의 기본 모델 IFEval은 21.0%예요. 평가 프롬프트·샘플 수·토큰 한도가 다르면 숫자가 크게 달라질 수 있으니, 7.9%에서 48.1%로의 상승은 이 실험 설정 안에서의 비교로만 읽는 게 안전해요. 루프를 줄이는 샘플링 조정만으로 기본 점수가 얼마나 오르는지는 원문이 따로 보여 주지 않아요.
규모와 일반화
- 실제 언어 모델 실험은 0.8B·270M급 소형 모델에 한정돼요. 수백억 파라미터 모델에서도 같은 방식이 통하는지는 보고되지 않았어요.
- 연구진도 컨텍스트 길이와 하네스(작업 환경)의 비효율 때문에 능력이 아직 제한적이라고 밝히고, 표준 벤치마크와 하네스를 만드는 중이라고 했어요.
- 동료 심사 논문이 아닌 블로그 보고예요. 전체 로그는 GitHub에 공개됐지만, 제3자가 다른 모델·다른 과제로 비슷한 성공률을 낼지는 아직 검증 전이에요.
안전성 쟁점
연구진은 가중치만 보고 백도어 같은 숨은 문제를 찾는 '평가 없는 감사', 데이터 없이 능력을 더하거나 지우는 편집, 모델이 자기 가중치를 고치는 재귀적 자기개선 가능성을 언급해요. 반대로 보면 같은 능력은 안전 장치를 약하게 만드는 편집이나 검증되지 않은 체크포인트 배포에도 쓰일 수 있어요. 소수 가중치만 바뀐 모델은 겉으로 원본과 구분하기 어려우니, 공개 체크포인트를 쓸 때는 출처·해시·평가 로그를 꼭 확인해야 해요.
이런 AI 연구 소식을 읽을 때 확인 순서
- 1
1차 출처와 날짜 확인
2026년 11월 2일 MIT CSAIL 블로그가 원문이에요. 요약 기사나 SNS에 나온 숫자가 원문 표와 같은지 비교해요.
- 2
기본 모델의 평가 조건 보기
샘플링 설정·토큰 한도·샘플 수를 확인하고, 공식 모델 카드 수치와 다르면 그 이유를 따져 봐요.
- 3
무엇이 바뀌었는지 확인
바뀐 가중치 수(131,072개)와 위치(15층·19층), 공개된 diff와 해시가 있는지 확인해요.
- 4
실패 사례 함께 읽기
Gemma 3 270M처럼 효과가 없던 경우, 가중치만으로 판별에 실패한 아첨 모델 실험을 같이 봐요.
- 5
후속 검증 추적
연구진이 예고한 벤치마크·하네스 공개, 제3자 재현, 더 큰 모델 결과가 나오는지 지켜봐요.
AI 연구 소식은 커뮤니티와 블로그에서 먼저 퍼지고 숫자가 부풀려지기도 해요. 더따리의 텔레그램 AI 트렌드와 블로그 트렌드에서 이 주제가 어떻게 이야기되는지 함께 확인해 보세요.

정리하면, Astra 실험은 범용 LLM이 작은 신경망의 가중치를 읽고 소형 언어 모델의 특정 결함을 학습 없이 고칠 수 있다는 초기 증거예요. 하지만 큰 성과는 루프 제거라는 한 가지 결함에서 나왔고, 대형 모델 적용·편집 과정의 독립 재현·안전성 검증은 아직 남은 과제예요.