AI 모델 비교 사이트·벤치마크 순위표 읽는 법: 점수 차이 해석
AI 모델 비교 사이트와 벤치마크 순위표에서 지능 지수·속도·가격을 읽는 법, 문항 수에 따른 오차 범위와 측정 설정·오염 문제를 정리해 점수 차이를 어디까지 믿을지 판단해요.
목차6개 섹션
핵심 요약
- AI 모델 비교 사이트의 종합 점수는 여러 벤치마크를 정해진 가중치로 섞은 값이라 가중치와 구성 평가를 먼저 봐야 해요.
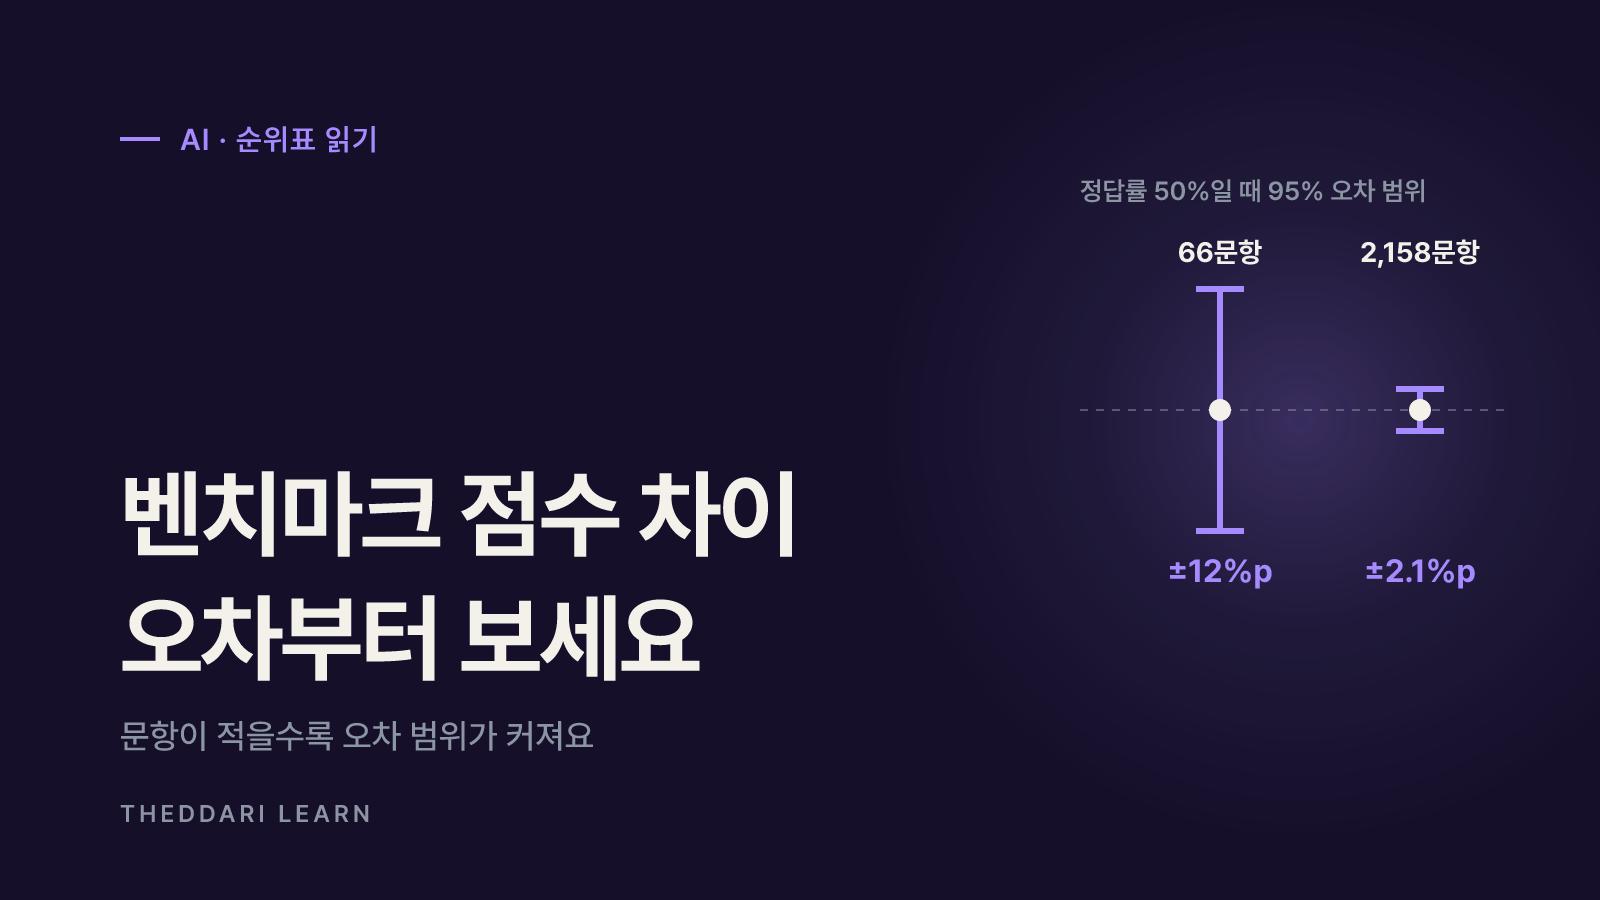
- 문항이 적은 벤치마크는 오차가 커요. 66문항짜리 시험에서 정답률 50% 근처라면 95% 오차 범위가 대략 ±12%p라서 몇 점 차이는 구분되지 않을 수 있어요.
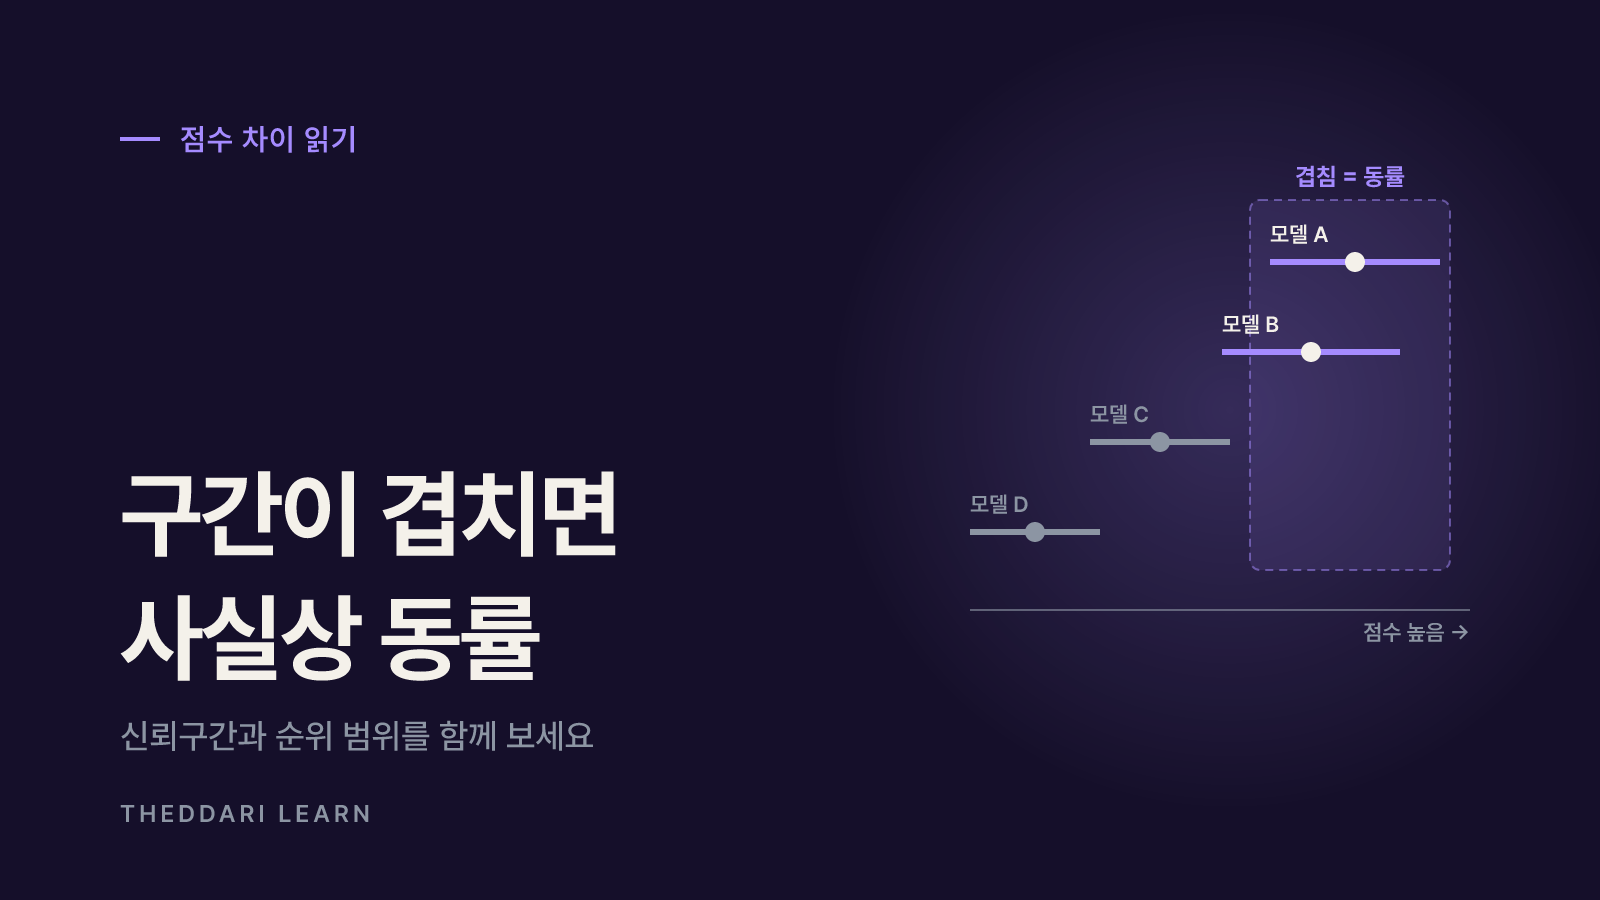
- Arena 같은 투표형 순위표는 신뢰구간과 순위 범위(rank spread)를 함께 공개하며, 범위가 겹치면 사실상 동률로 읽어요.
- 온도·출력 토큰 한도·하네스 같은 측정 설정, 답변 길이 같은 스타일 편향, 벤치마크 오염과 선택적 공개가 순위를 움직일 수 있어요.
- 순위는 후보를 줄이는 데 쓰고, 최종 선택은 내 작업으로 직접 시험해 결정하는 편이 안전해요.
AI 모델 비교 사이트와 벤치마크 순위표의 작은 점수 차이는 그대로 믿기보다 오차 범위 안의 차이인지부터 확인해야 해요. 문항이 적은 시험에서는 몇 점 차이가 우연히 생길 수 있고, 측정 설정이나 답변 스타일, 공개 방식에 따라 순위가 바뀌기도 해요. 이 글은 2026년 10월 기준 Artificial Analysis와 Arena(옛 LMArena)가 공개한 방법론 문서를 바탕으로 비교표의 축을 읽는 법과 점수 차이를 해석하는 기준을 정리해요. 특정 모델을 추천하지 않고, 어떤 표를 만나도 쓸 수 있는 읽기 순서에 집중해요.
AI 모델 비교 사이트는 무엇을 재나요
대표적인 AI 모델 비교 사이트는 보통 세 가지 축을 함께 보여 줘요. 지능(품질) 점수, 속도, 가격이에요. 같은 모델이라도 어느 축을 보느냐에 따라 '좋은 모델'의 의미가 달라지므로, 차트를 보기 전에 각 숫자가 무엇을 측정하는지 먼저 확인해야 해요.
종합 지능 지수는 여러 시험의 가중 평균이에요
Artificial Analysis 방법론 페이지에 따르면 2026년 10월 기준 Intelligence Index v4.3.2는 10개 평가로 구성되고, 에이전트 30%, 코딩 20%, 과학 추론 20%, 일반 30% 비중으로 가중 평균해요. 예를 들어 코딩 영역에는 Terminal-Bench 4.0(66문항, 3회 반복)과 SciCode가 각각 10%씩 들어가고, 과학 추론에는 HLE(Humanity's Last Exam, 2,158문항)와 CritPt가 10%씩 들어가요. 같은 페이지는 이 지수가 주로 영어 텍스트 평가이며 이미지·음성·다국어 능력은 따로 측정한다고 밝혀요.
그래서 종합 지수가 높다는 것은 '이 가중치 조합에서 평균적으로 잘했다'는 뜻이에요. 한국어 문서 요약이나 특정 언어의 코드 작업처럼 내 용도가 지수 구성과 다르면 종합 점수보다 해당 세부 평가나 별도 지수(다국어 지수 등)를 보는 편이 더 관련성이 높아요. 지수 버전이 바뀌면 구성 평가와 가중치도 바뀌므로, 몇 달 전 캡처한 차트와 지금 차트를 같은 기준으로 비교하면 안 돼요.
속도와 가격은 제공자와 사용 방식에 따라 달라요
같은 사이트의 용어 정의를 보면 출력 속도는 첫 토큰 이후 초당 받는 토큰 수, 첫 토큰 시간(TTFT)은 요청부터 첫 토큰까지의 시간이에요. 추론형 모델은 생각하는 토큰이 먼저 나오기 때문에 '첫 답변 토큰 시간'을 따로 봐야 체감 대기 시간에 가까워요. 혼합 가격(blended price)은 캐시 적중·입력·출력 토큰을 7:2:1 비율로 가정해 계산한 값이라서, 출력이 많은 작업이라면 실제 비용이 표시값과 크게 다를 수 있어요. 또 과제당 비용(Cost per Task)은 토큰 단가가 같아도 답변과 추론 토큰을 많이 쓰는 모델일수록 높게 나와요.
종합 지능 지수
- 무엇을 뜻하나
- 여러 벤치마크의 가중 평균
- 읽을 때 주의할 점
- 가중치·버전·평가 언어가 내 용도와 맞는지
세부 벤치마크
- 무엇을 뜻하나
- 특정 능력의 정답률이나 Elo
- 읽을 때 주의할 점
- 문항 수·반복 횟수·채점 방식
출력 속도·TTFT
- 무엇을 뜻하나
- 제공자 API의 실측 응답 성능
- 읽을 때 주의할 점
- 추론형은 첫 답변 토큰 시간 별도 확인
혼합 가격
- 무엇을 뜻하나
- 7:2:1 토큰 비율 가정의 단가
- 읽을 때 주의할 점
- 내 입력·출력 비율로 다시 계산
과제당 비용
- 무엇을 뜻하나
- 지수 과제 하나를 푸는 평균 비용
- 읽을 때 주의할 점
- 긴 추론일수록 단가보다 비용이 커짐
점수 차이는 얼마나 믿을 수 있나요: 문항 수와 오차 범위
벤치마크는 일종의 실험이에요. Miller(2024)의 논문은 평가 문항을 더 큰 문제 집단에서 뽑은 표본으로 보고, 두 모델의 차이를 측정할 때 통계적 오차를 함께 보고해야 한다고 권고해요. 핵심은 문항 수가 적을수록 같은 모델을 다시 시험해도 점수가 크게 흔들린다는 점이에요.
감을 잡기 위해 정답률 50% 근처에서 단순 이항 근사로 95% 오차 범위를 계산해 볼게요. 66문항 시험이라면 1.96 × √(0.5×0.5÷66) ≈ 0.12, 즉 대략 ±12%p예요. 2,158문항 시험이라면 같은 계산으로 대략 ±2.1%p예요. 반복 실행은 같은 문항에서 생기는 모델 응답의 들쭉날쭉함을 줄여 주지만, 문항 자체가 66개뿐이라는 한계는 줄여 주지 않아요. 이 숫자는 이해를 돕기 위한 어림셈이며, 실제 신뢰구간은 정답률과 문항 간 상관, 채점 방식에 따라 달라져요.
종합 지수로 옮기면 영향은 줄어들어요. 가중치 10%인 평가에서 ±12%p의 흔들림은 지수 기준으로 단순 계산 시 약 ±1.2점이에요. 여러 평가의 오차가 일부 상쇄되기도 하지만, 2026년 10월 확인 기준 방법론 페이지에서 지수 전체의 신뢰구간은 찾지 못했어요. 그러니 종합 지수의 1~2점 차이는 '비슷한 수준'으로 읽는 편이 안전해요.
투표형 순위표는 순위 범위를 봐요
Arena처럼 사용자가 두 답변 중 더 나은 쪽에 투표하는 순위표는 Bradley-Terry 모델로 점수를 계산하고, 점수 옆에 신뢰구간을 함께 보여 줘요. Arena의 순위 방법 설명에 따르면 각 모델에는 원순위(raw rank)와 순위 범위(rank spread)가 붙어요. 최선 순위는 '내 구간 상단보다 하단이 더 높은 모델 수 + 1', 최악 순위는 '내 구간 하단보다 상단이 더 높은 모델 수 + 1'이에요. 두 모델의 순위 범위가 겹치면 동률로 해석하고, 표시된 원순위는 현재 데이터 기준 최선 추정이라고 설명해요.
새로 올라온 모델은 투표 수가 적어 신뢰구간이 넓어요. Arena는 예전에는 낙관적 순위만 보여 줘 불확실성이 큰 신규 모델이 높게 보이는 문제가 있었다고 밝히고, 지금은 낙관·비관 순위를 같은 비중으로 보여 준다고 설명해요. 출시 직후 '1위 등극' 소식을 볼 때는 투표 수와 순위 범위를 먼저 확인하세요.
AI 벤치마크 순위를 흔드는 요인 네 가지
오차 범위 밖의 차이라도 그것이 곧 '모델 자체의 실력 차이'라고 단정할 수는 없어요. 같은 모델도 측정 방법에 따라 다른 점수를 받기 때문이에요.
- 측정 설정: Artificial Analysis는 비추론 모델은 온도 0, 추론 모델은 온도 0.6(모델사 권장값이 있으면 그 값)을 쓰고, 추론 모델에는 모델사가 공개한 최대 출력 토큰을 허용한다고 밝혀요. 모델사 자체 발표는 다른 프롬프트·도구·시도 횟수를 쓸 수 있어 같은 벤치마크 이름이라도 숫자가 다를 수 있어요.
- 채점 방식: 정답 일치, 단위 테스트 통과, LLM 심판의 쌍대 비교(Elo) 등 방식이 섞여 있어요. Elo 기반 평가는 기준 모델을 정해 점수를 고정하고 정규화하므로, 기준이 바뀌면 숫자가 이동할 수 있어요.
- 스타일 편향: Arena의 스타일 보정 분석은 답변 길이와 마크다운 헤더·굵은 글씨·목록 수를 통제하자 순위가 눈에 띄게 바뀌었고, 길이가 가장 큰 스타일 요인이었다고 보고해요. 다만 이 분석도 관찰 연구라 숨은 요인이 남아 있다고 스스로 한계를 적었어요.
- 오염과 선택적 공개: 공개 문항이 학습 데이터에 섞이면 점수가 부풀 수 있어요. The Leaderboard Illusion 논문은 일부 제공자가 공개 전 여러 비공개 변형을 시험하고 좋은 결과만 남길 수 있었다고 지적하며, Llama 4 출시 전 메타가 시험한 비공개 변형 27개를 사례로 들었어요. 같은 논문은 구글과 오픈AI가 Arena 전체 데이터의 약 19.2%와 20.4%를 받은 반면 오픈 웨이트 모델 83개는 합계 약 29.7%에 그쳤다고 추정했어요.
이런 문제를 줄이려고 비교 사이트들은 비공개 문항 세트를 섞기도 해요. Artificial Analysis 방법론 표에서 비공개로 표시된 평가의 가중치를 더하면 AA-Briefcase 15%, AutomationBench-AA 5%, AA-Omniscience 15%, CritPt 10%로 합계 45%예요. 비공개 문항은 암기 위험을 낮추지만, 외부에서 문제를 검토하기 어렵다는 반대 비용이 있어요. 어느 쪽이든 '한 사이트의 한 숫자'에 결론을 맡기지 않는 것이 핵심이에요.
AI 모델 비교표를 읽는 5단계 체크리스트
- 1
지표의 정의와 버전을 적어요
종합 지수인지 세부 벤치마크인지, 지수 버전과 측정 날짜가 언제인지 기록해요. 버전이 다른 차트끼리는 직접 비교하지 않아요.
- 2
오차 정보를 찾아요
신뢰구간, 오차 막대, 순위 범위가 있는지 확인하고 두 모델의 구간이 겹치면 동률로 읽어요. 오차 정보가 없으면 문항 수를 보고 위의 어림셈으로 범위를 가늠해요.
- 3
측정 조건을 맞춰요
모델사 발표 수치와 독립 평가 수치를 섞지 말고, 추론 강도(effort)·도구 사용 여부·반복 횟수가 같은 조건끼리 비교해요.
- 4
내 비용 구조로 다시 계산해요
혼합 가격 대신 내 입력·출력 토큰 비율과 캐시 사용률로 비용을 계산하고, 과제당 비용과 응답 시간을 함께 봐요.
- 5
내 작업으로 직접 시험해요
실제 처리할 문서·코드·질문으로 작은 시험 세트를 만들어 후보 두세 개를 같은 프롬프트로 돌려요. 결과를 사람이 채점하고 실패 유형까지 기록하면 순위표보다 훨씬 구체적인 판단 근거가 생겨요.
새 모델이 나오면 순위표보다 먼저 커뮤니티 반응과 사용 후기가 퍼지는 경우가 많아요. 더따리의 AI 텔레그램 트렌드와 블로그 트렌드에서 어떤 모델과 벤치마크가 화제가 되는지 흐름을 확인할 수 있어요. 다만 화제성은 성능의 증거가 아니므로, 언급된 수치는 위 체크리스트로 원문 방법론과 대조해 보세요.

정리하면, 순위표는 '어떤 모델이 대체로 앞서 있는가'를 보여 주는 지도이지 '내 작업에서 무엇이 더 나은가'를 확정하는 판정문이 아니에요. 큰 차이는 참고할 만한 신호이고, 오차 범위 안의 작은 차이는 동률로 두며, 최종 판단은 내 데이터로 확인하는 순서를 지키면 과장된 '1위' 뉴스에 흔들릴 일이 줄어들어요.