퀄컴 Cloud AI 100 Ultra란? 150W·128GB 추론 카드 사양과 GPU 비교
퀄컴 Cloud AI 100 Ultra의 150W·128GB·548GB/s 사양을 공개 자료로 정리하고, 엔비디아 L40S와 메모리·대역폭·전력을 비교해 대형 모델 추론에서의 의미와 한계를 설명해요.
목차6개 섹션
핵심 요약
- 퀄컴 Cloud AI 100 Ultra는 학습이 아닌 추론 전용 PCIe 카드로, 공개 사양은 150W TDP, 128GB LPDDR4x, 548GB/s, INT8 870 TOPS, AI 코어 64개예요.
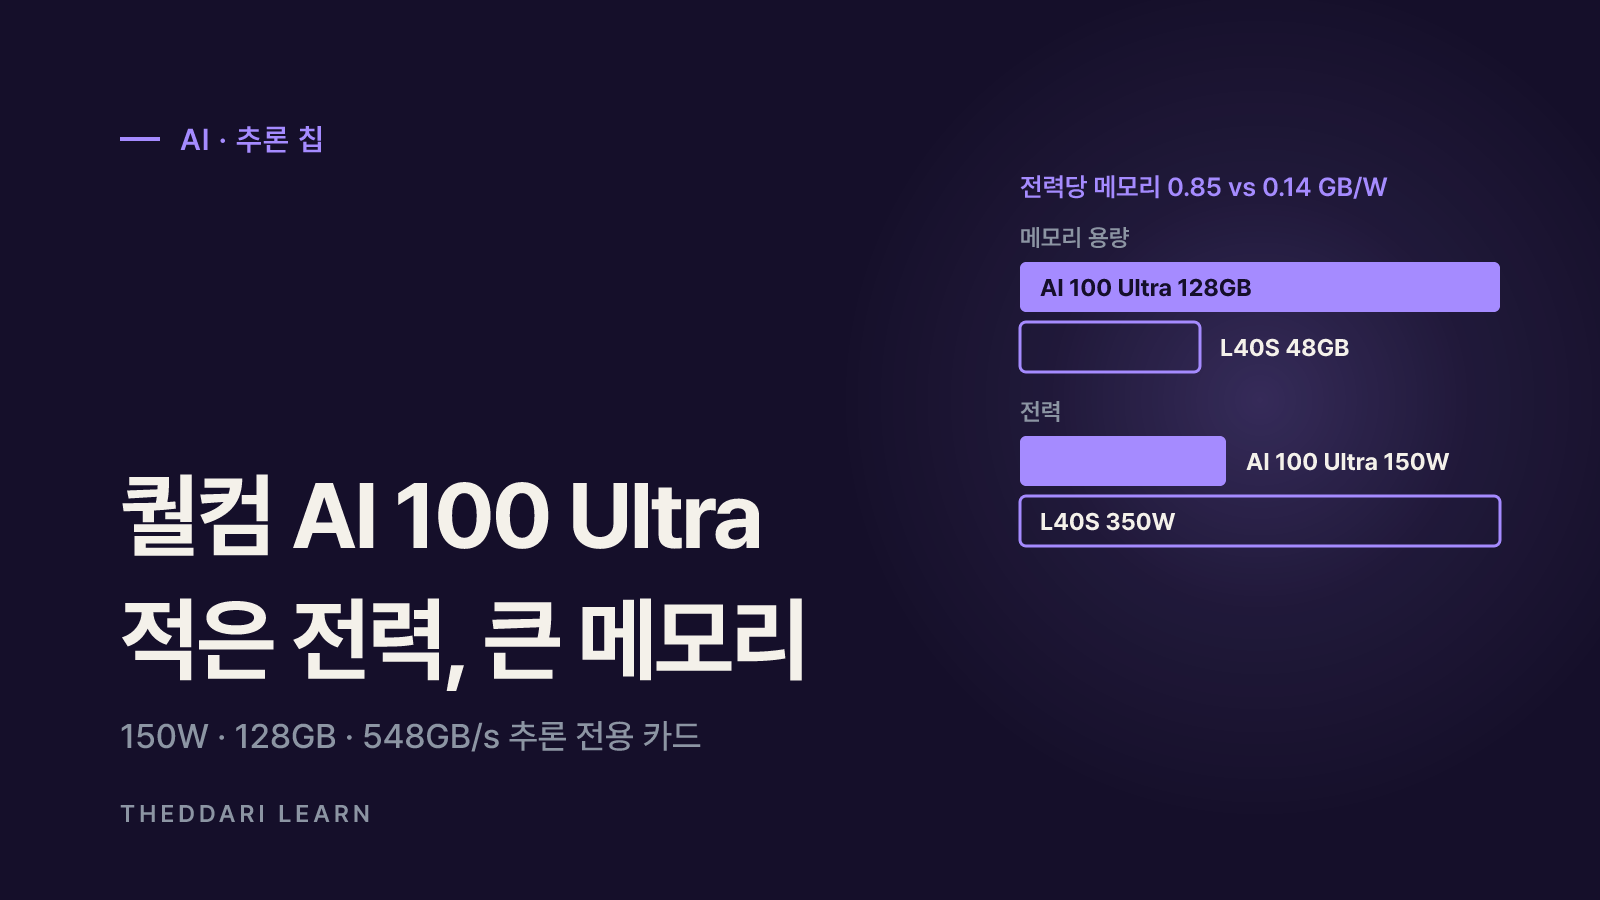
- 핵심은 전력당 메모리 용량이에요. 128GB÷150W는 약 0.85GB/W로, 엔비디아 L40S(48GB÷350W, 약 0.14GB/W)의 약 6배예요.
- 대신 메모리 대역폭은 548GB/s로 L40S의 864GB/s보다 낮아, 큰 모델을 한 사용자에게 빠르게 생성하는 데는 불리할 수 있어요.
- CUDA가 아닌 퀄컴 자체 소프트웨어로 모델을 컴파일해야 하므로 지원 모델·양자화 형식을 먼저 확인해야 해요.
- 가격과 독립 벤치마크는 공개 자료로 확인되지 않았어요. 사양표의 최대치가 아니라 실제 모델로 측정한 처리량으로 판단해야 해요.
퀄컴 Cloud AI 100 Ultra는 150W 전력으로 128GB 메모리를 쓰는 추론 전용 PCIe 가속기 카드예요. 그래픽 처리나 모델 학습까지 하는 범용 GPU가 아니라, 이미 학습된 대형 언어 모델(LLM)을 적은 전력으로 서비스하는 데 초점을 맞췄어요. 2026년 11월 기준 공개 자료로 확인한 사양은 TDP 150W, LPDDR4x 128GB, 메모리 대역폭 548GB/s, INT8 최대 870 TOPS, AI 코어 64개, PCIe Gen4 x16이에요. 이 글은 이 숫자들이 대형 모델 추론에서 무엇을 뜻하는지, 엔비디아 GPU와 비교하면 어디가 강하고 어디가 약한지, 도입이나 투자 판단 전에 무엇을 더 확인해야 하는지를 정리해요.
퀄컴 Cloud AI 100 Ultra 사양 한눈에 보기
퀄컴 제품 페이지는 자바스크립트로만 내용을 보여 줘서, 이 글에서는 퀄컴 파트너인 어드밴텍이 2026년 3월 10일 발표에 실은 사양을 기준으로 삼았어요. 해커뉴스에서 화제가 된 '150W, 128GB, 548GB/s'라는 제목의 세 숫자도 이 사양과 같아요.
폼팩터
- 공개 사양
- PCIe FH3/4L(풀하이트·3/4 길이)
- 의미
- 일반 서버 PCIe 슬롯에 꽂는 카드
TDP
- 공개 사양
- 150W
- 의미
- 카드 단독 열설계 전력
메모리
- 공개 사양
- 128GB LPDDR4x
- 의미
- 모델 가중치·KV 캐시를 올리는 공간
메모리 대역폭
- 공개 사양
- 548GB/s
- 의미
- 초당 읽을 수 있는 데이터 양
INT8 연산
- 공개 사양
- 최대 870 TOPS
- 의미
- 8비트 정수 연산의 이론 최대치
AI 코어
- 공개 사양
- 64개
- 의미
- 카드 한 장 기준
호스트 연결
- 공개 사양
- PCIe Gen4 x16
- 의미
- CPU·서버와 데이터를 주고받는 통로
표의 연산 성능은 제조사가 밝힌 이론 최대치예요. 실제 서비스 처리량은 모델 구조, 양자화 방식, 배치 크기, 컴파일러 최적화에 따라 크게 달라져요. 이 카드의 공개 가격과 제3자 독립 벤치마크는 이번 조사에서 확인하지 못했어요.
왜 '추론 전용'이 중요한가요
AI 연산은 크게 모델을 만드는 학습과 만들어진 모델로 답을 내는 추론으로 나뉘어요. 학습은 막대한 연산을 몰아서 쓰지만, 추론은 서비스가 켜져 있는 동안 24시간 이어지고 응답 지연과 전기료가 바로 비용이 돼요. 추론 전용 칩은 학습에 필요한 기능을 덜어 내고 전력 대비 효율과 메모리 용량에 집중하는 설계를 택해요. 퀄컴 Cloud AI 100 Ultra도 이런 방향의 제품이에요.
GPU와 비교하면 무엇이 다른가요
같은 PCIe 카드 형태의 추론용 GPU인 엔비디아 L40S 공식 사양과 나란히 놓으면 차이가 분명해져요. L40S는 48GB GDDR6, 864GB/s 대역폭, 최대 소비전력 350W, 2슬롯 카드이며 PCIe Gen4 x16을 써요. L40S의 INT8 성능은 희소성 미적용 733 TOPS, 희소성 적용 시 1,466 TOPS로 표기돼요.
메모리 용량
- 퀄컴 Cloud AI 100 Ultra
- 128GB LPDDR4x
- 엔비디아 L40S
- 48GB GDDR6
메모리 대역폭
- 퀄컴 Cloud AI 100 Ultra
- 548GB/s
- 엔비디아 L40S
- 864GB/s
전력
- 퀄컴 Cloud AI 100 Ultra
- 150W(TDP)
- 엔비디아 L40S
- 350W(최대 소비전력)
전력당 메모리(계산)
- 퀄컴 Cloud AI 100 Ultra
- 약 0.85GB/W
- 엔비디아 L40S
- 약 0.14GB/W
INT8 최대치
- 퀄컴 Cloud AI 100 Ultra
- 870 TOPS
- 엔비디아 L40S
- 733 TOPS(희소성 적용 시 1,466)
슬롯
- 퀄컴 Cloud AI 100 Ultra
- 1슬롯
- 엔비디아 L40S
- 2슬롯
소프트웨어
- 퀄컴 Cloud AI 100 Ultra
- 퀄컴 Cloud AI SDK·AI Inference Suite
- 엔비디아 L40S
- CUDA 생태계
전력당 메모리는 공개 사양을 나눠 직접 계산한 값이에요(128÷150, 48÷350). 두 회사의 전력 표기 기준(TDP와 최대 소비전력)이 완전히 같지 않고 INT8 수치도 측정 조건이 다르므로, 표는 설계 방향을 보여 주는 참고로 읽어야 해요.
강점: 전력당 메모리 용량
LLM 추론에서는 모델 가중치 전체가 메모리에 올라가야 해요. 메모리가 부족하면 모델을 여러 카드로 쪼개야 하고, 카드 사이 통신이 늘어 비용과 지연이 커져요. 128GB를 150W 한 장에 담은 것은 큰 모델이나 여러 모델을 적은 카드 수와 낮은 전력으로 상주시키려는 수요를 겨냥한 거예요. 어드밴텍은 이 카드로 Llama 4 같은 최대 109B 파라미터 모델을 한 장에서 돌리도록 최적화했고, 카드당 최대 20명의 동시 사용자를 지원한다고 밝혔어요. 같은 발표에서 SKY-641E3 서버는 4U 섀시 하나에 1슬롯 가속기를 최대 12장 꽂을 수 있다고 했어요. 단순 계산하면 12×128GB는 1,536GB, 카드 전력 합은 12×150W로 1,800W예요.
약점: 대역폭과 생성 속도
텍스트를 한 토큰씩 생성하는 단계에서는 매 토큰마다 가중치를 메모리에서 읽어야 해서, 대역폭이 속도의 상한을 정하는 경우가 많아요. 거친 상한 계산으로 70GB 크기의 모델(예: 700억 파라미터를 8비트로 저장)을 548GB/s로 읽으면 한 요청당 초당 약 7.8토큰(548÷70)이 이론 상한이에요. 실제 값은 배치 처리, 캐시, 모델 분할 방식에 따라 달라지지만, 대역폭이 128GB 용량에 비해 낮다는 점은 분명해요. 그래서 이 카드는 한 사용자에게 최대 속도를 내기보다 여러 요청을 묶어 처리하거나, 여러 모델을 상주시키는 용도에 더 맞는다고 보는 편이 합리적이에요.
도입·평가 전 확인할 점
- 1
모델 지원 여부부터 확인해요
CUDA용으로 짠 코드가 그대로 돌아가지 않아요. 퀄컴 소프트웨어로 모델을 미리 컴파일하는 방식이므로, 쓰려는 모델 구조와 양자화 형식이 지원 목록에 있는지 먼저 확인하세요.
- 2
실측 처리량으로 비교해요
TOPS 같은 최대치 대신 같은 모델, 같은 문맥 길이, 같은 동시 사용자 수에서 첫 토큰 지연과 초당 토큰 수를 측정해요. 벤더 자료만 있다면 측정 조건을 기록해 두세요.
- 3
전력·공간·총비용을 함께 봐요
카드 가격은 공개되지 않았어요. 견적을 받을 때 서버 한 대에 들어가는 카드 수, 랙 전력 한도, 냉각 조건, 소프트웨어 지원 비용을 합친 총소유비용(TCO)으로 비교해요.
- 4
후속 로드맵을 확인해요
퀄컴은 데이터센터 추론 제품군을 계속 발표하고 있어요. 장기 도입이라면 이 카드의 공급·지원 기간과 후속 제품의 소프트웨어 호환성을 공식 채널에서 확인하세요.
AI 칩 관련 뉴스는 빠르게 쏟아지고 과장된 해석도 많아요. 더따리 AI 텔레그램 트렌드에서 업계 반응을 모아 보되, 숫자는 항상 제조사 원문과 대조하는 습관이 좋아요.

퀄컴 데이터센터 사업과 주가에서 볼 것
제품 페이지가 화제가 되고 종목 관심이 늘었다고 해서 곧바로 실적에 반영되는 것은 아니에요. 퀄컴 데이터센터 사업은 엔비디아·AMD 같은 GPU 강자와 다수의 추론 칩 스타트업이 경쟁하는 시장에 뒤늦게 들어간 편이고, 소프트웨어 생태계 격차도 넘어야 해요. 반면 추론 수요가 커질수록 전력 효율과 메모리 용량을 중시하는 고객이 늘 수 있다는 점은 기회예요.
- 실적 발표에서 데이터센터 관련 매출이나 수주를 별도로 언급하는지 확인해요.
- 대형 고객 계약이 발표되면 규모, 기간, 인도 시점이 구체적으로 공개됐는지 봐요.
- 서버 제조사 파트너가 실제 출하 제품을 내놓는지, 시제품 발표에 그치는지 구분해요.
- 스마트폰 칩 등 주력 사업의 흐름이 전체 실적에 미치는 영향이 훨씬 크다는 점을 함께 고려해요.
더따리 어닝 캘린더로 퀄컴 실적 발표일을 확인하고, 어닝콜에서 데이터센터 관련 질문과 답변을 직접 들어 보는 것이 사양표보다 정확한 판단 자료가 돼요.
정리하면 퀄컴 Cloud AI 100 Ultra는 '빠른 GPU'라기보다 '전력당 메모리가 큰 추론 카드'예요. 큰 모델을 적은 전력으로 상주시키는 데는 매력이 있지만, 대역폭과 소프트웨어 호환성은 실제 모델로 검증해야 할 과제예요. 가격과 독립 벤치마크가 공개되기 전까지는 사양표의 숫자를 성능 우위의 증거로 단정하지 않는 것이 안전해요.