Mistral Voxtral 3란? 받아쓰기·음성 모델 특징과 쓰기 전 확인할 점
Mistral이 2026년 10월 20일 발표한 Voxtral 3의 받아쓰기·음성 합성 모델 구성과 가격, 한국어 지원, 오픈 가중치 여부, 음성 이해 작업에 쓰기 전 확인할 점을 정리했어요.
목차7개 섹션
핵심 요약
- Voxtral 3는 2026년 10월 20일 발표된 Mistral의 음성 모델 묶음으로, 받아쓰기(STT) 3종·음성 합성(TTS) 1종·음성 에이전트 SDK로 구성돼요.
- 파일 받아쓰기 모델은 50개 언어, 실시간 모델은 공식 문서 기준 45개 언어·방언을 지원하며 한국어는 벤치마크 언어 목록에 포함돼 있어요.
- API 가격은 Mini Transcribe 3 분당 0.0035달러, Small Transcribe 3 분당 0.004달러, Speech 3 100만 자당 13달러예요.
- 2026년 10월 21일 확인 기준 허깅페이스 Voxtral 컬렉션에는 Voxtral 3 가중치가 없고, 자체 설치는 영업팀 문의 방식이에요.
- 녹음 요약·질의응답·번역 같은 '음성 이해'는 출시 시점에 Voxtral 2 기반 voxtral-small-latest를 쓰라고 문서가 안내해요.
Voxtral 3는 Mistral AI가 2026년 10월 20일 발표한 음성 AI 모델 묶음이에요. 녹음 파일과 실시간 음성을 글자로 바꾸는 받아쓰기(STT) 모델 3종, 글을 목소리로 읽어 주는 음성 합성(TTS) 모델, 그리고 이 둘을 언어 모델과 엮는 음성 에이전트 SDK로 이루어져 있어요(Mistral 발표). 이 글은 2026년 10월 21일 기준 공식 발표문·문서·허깅페이스 페이지를 직접 확인해 정리했어요.
먼저 결론부터 말하면, Voxtral 3는 받아쓰기와 음성 합성에 초점을 맞춘 API 중심 출시예요. 이름에 '공개'라는 인상이 있지만 확인 시점에는 내려받을 수 있는 가중치가 없고, 녹음을 요약하거나 질문에 답하는 '음성 이해' 기능은 공식 문서가 아직 이전 세대 Voxtral 2 모델을 쓰라고 안내해요. 아래에서 구성, 이전 버전과의 차이, 가격, 그리고 실제로 쓰기 전 확인할 점을 차례로 볼게요.
Voxtral 3 구성: 받아쓰기 3종과 음성 합성·에이전트 SDK
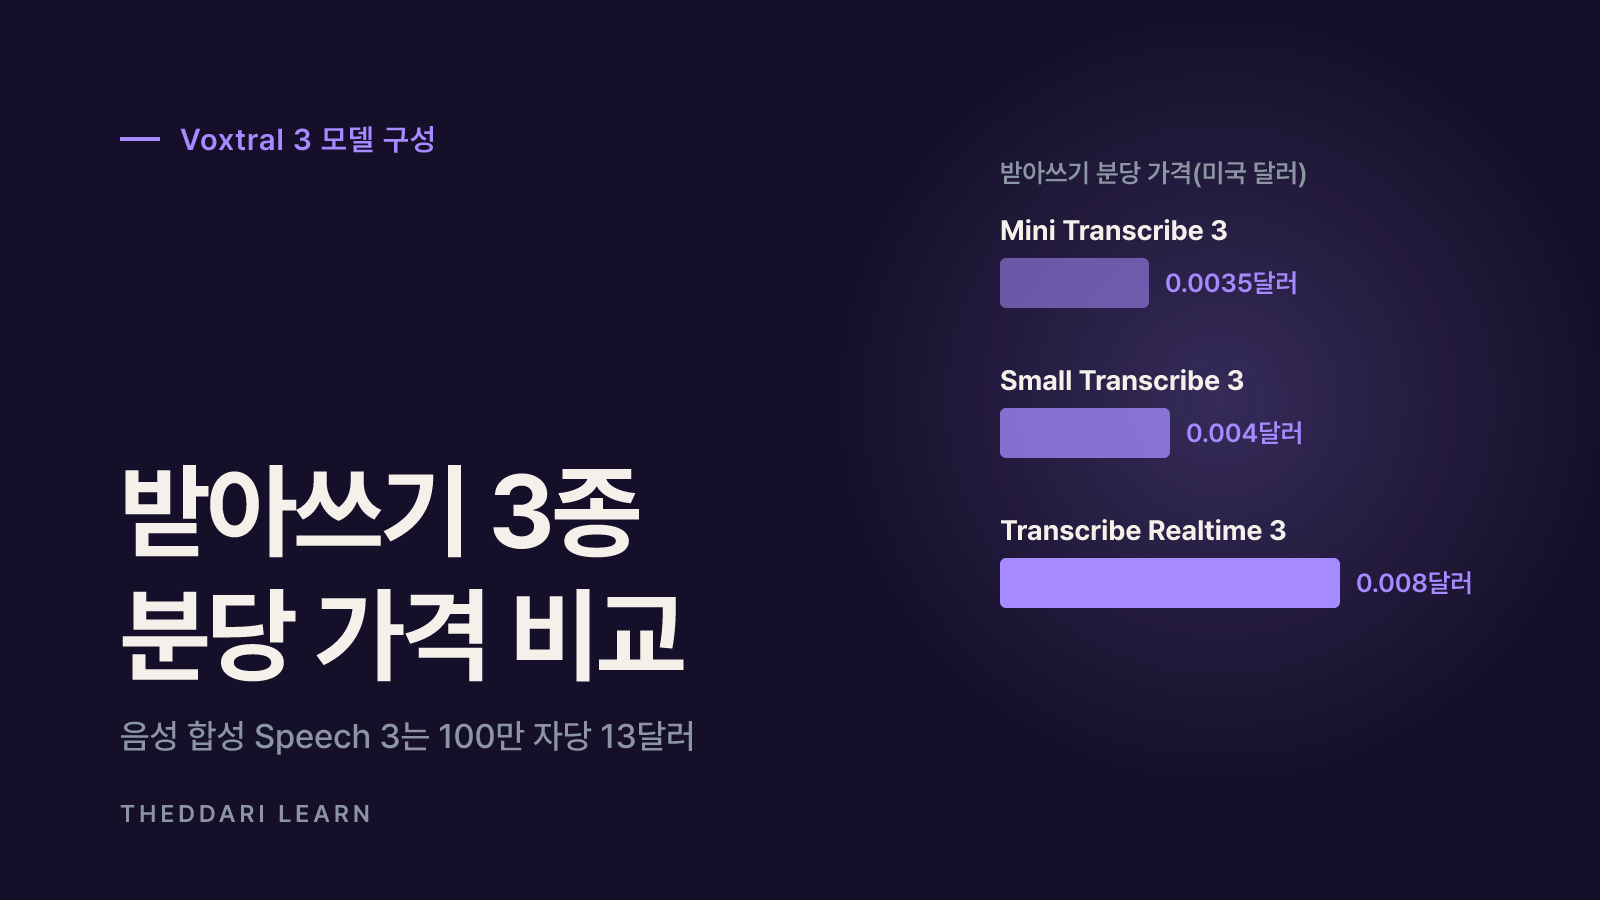
Mistral 문서는 Voxtral 3 모델을 용도별로 나눠요(Speech to Text 개요). 실시간 모델은 하나, 파일용 모델은 두 개이고 음성 합성 모델이 따로 있어요.
Voxtral Mini Transcribe 3
- 용도
- 녹음 파일 받아쓰기(기본 추천), 4B 파라미터
- 지원 언어(문서 기준)
- 50개 언어
- API 가격
- 분당 0.0035달러
Voxtral Small Transcribe 3
- 용도
- 더 높은 정확도가 필요한 파일 받아쓰기
- 지원 언어(문서 기준)
- 50개 언어
- API 가격
- 분당 0.004달러
Voxtral Mini Transcribe Realtime 3
- 용도
- 말하는 동안 실시간 받아쓰기·턴 감지
- 지원 언어(문서 기준)
- 45개 언어·방언
- API 가격
- 분당 0.008달러
Voxtral Speech 3 (Mini TTS 3)
- 용도
- 음성 합성, 배치·실시간 같은 API
- 지원 언어(문서 기준)
- 35개 이상 언어, 50개 이상 방언
- API 가격
- 100만 자당 13달러
가격은 발표문 표 기준이며 미국 달러예요. 음성 에이전트 API는 추론에 Mistral Small 4를 쓰면 분당 0.04달러, 다른 추론 모델을 쓰면 분당 0.08달러로 따로 책정돼 있어요. API는 유럽·미국·글로벌 엔드포인트로 제공된다고 밝혔어요.
받아쓰기 모델의 핵심 기능
- 화자 분리(diarization): 누가 언제 말했는지 구분해요. 기준 화자 음성 클립을 최대 8개(각 3~15초)까지 넣어 이름을 붙일 수 있어요.
- 컨텍스트 바이어싱(context biasing): 회사명·전문용어 같은 키워드를 미리 알려 주면 그 단어를 더 잘 받아 적도록 유도해요. 별도 파인튜닝 없이 쓸 수 있다는 점이 장점이에요.
- 턴 감지(end-of-turn): 실시간 모델이 사용자가 말을 끝냈는지 소리와 의미를 함께 보고 판단해요. 음성 에이전트가 끼어들지 않고 바로 대답하는 데 필요해요.
- 지연 시간 조절: 실시간 모델은 스트리밍 지연을 80~1200ms 또는 2400ms로 설정할 수 있어요. 짧게 할수록 빠르지만 정확도는 떨어지는 구조예요.
음성 합성과 음성 에이전트 SDK
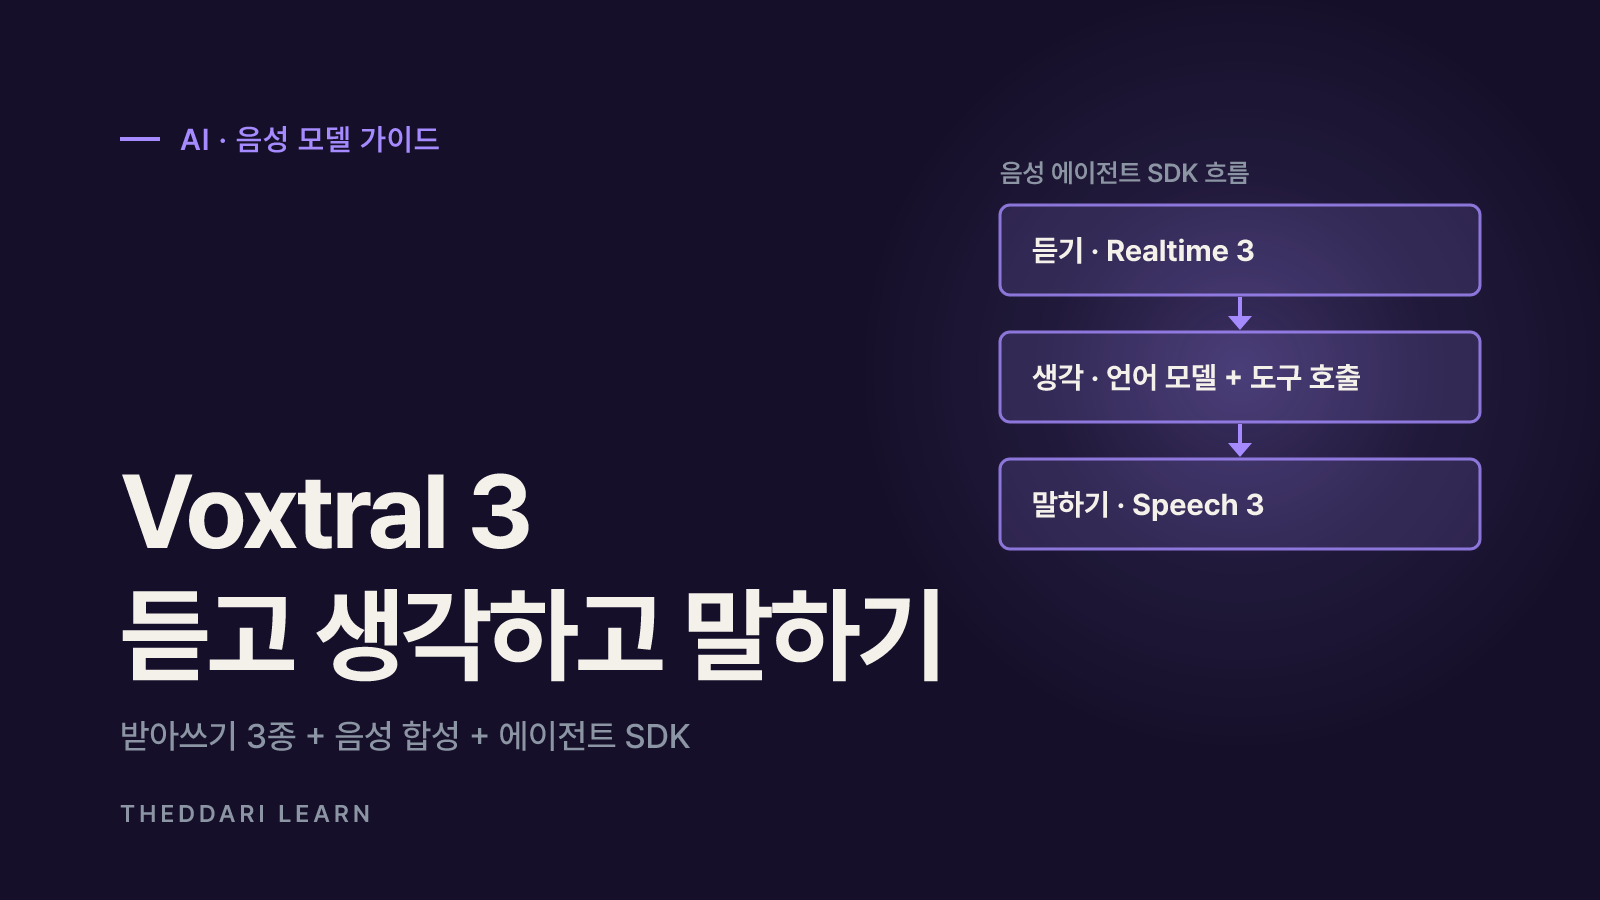
Voxtral Speech 3는 문맥에 따라 감정·속도·강조를 바꾸는 목소리를 내세워요. 발음 힌트(phoneme hints)로 낯선 고유명사 발음을 지정할 수 있고, 'Pro Voice'라는 기능은 약 30분 분량 음성으로 특정 화자의 말투를 재현한다고 설명해요. 음성 에이전트 SDK는 LiveKit 기반으로 '듣기(실시간 받아쓰기) → 생각(언어 모델·도구 호출) → 말하기(음성 합성)'를 하나의 스트리밍 흐름으로 묶고, 각 턴을 1초 미만에 처리한다고 발표했어요. 단계마다 모델이 분리돼 있어 언어 모델이나 목소리만 바꿔 끼울 수 있어요.
이전 Voxtral과 무엇이 달라졌나
Voxtral이라는 이름은 처음이 아니에요. 2025년 7월 첫 Voxtral(Mini 3B·Small 24B)은 오디오를 듣고 대화하는 '오디오 챗' 모델로 Apache 2.0 라이선스로 공개됐고, 2026년 2월에는 13개 언어 실시간 받아쓰기 모델 Voxtral-Mini-4B-Realtime-2602가 역시 Apache 2.0으로 나왔어요(허깅페이스 Voxtral 컬렉션). 2026년 3월의 Voxtral-4B-TTS-2603은 참조 음성 데이터 때문에 비상업 라이선스(CC BY-NC 4.0)를 따라요.
주된 용도
- 이전 공개 Voxtral 모델
- 오디오 챗(음성 이해), 실시간 받아쓰기, TTS
- Voxtral 3 (2026-10 발표)
- 파일·실시간 받아쓰기, TTS, 음성 에이전트
받아쓰기 언어 수
- 이전 공개 Voxtral 모델
- 실시간 모델 13개 언어
- Voxtral 3 (2026-10 발표)
- 파일 50개, 실시간 45개 언어·방언
가중치 공개
- 이전 공개 Voxtral 모델
- 허깅페이스 공개(모델별 라이선스 다름)
- Voxtral 3 (2026-10 발표)
- 확인 시점 공개 가중치 없음, 자체 설치는 문의
타임스탬프
- 이전 공개 Voxtral 모델
- 모델별 상이
- Voxtral 3 (2026-10 발표)
- 파일은 구간 단위만, 단어 단위 미지원
상태
- 이전 공개 Voxtral 모델
- 정식 공개 체크포인트
- Voxtral 3 (2026-10 발표)
- 모델 페이지에 Public Preview 표시
'음성 이해'는 Voxtral 3 모델이 아니에요. 공식 문서는 녹음 요약·번역처럼 오디오를 듣고 답하는 작업에 '출시 시점에는 voxtral-small-latest(Voxtral 2)를 쓰라'고 안내해요. 받아쓰기만 필요한지, 내용 분석까지 필요한지에 따라 고를 모델이 달라져요.
가격·제공 방식과 라이선스, 어떻게 확인할까
Voxtral 3는 Mistral API와 Studio 플레이그라운드에서 바로 쓸 수 있어요. 발표문은 'EU 호스팅 API 또는 자체 인프라 배포'를 강조하지만, 실제 안내는 '온프레미스나 프라이빗 클라우드에서 전체 스택을 돌리려면 팀에 문의하라'예요. 2026년 10월 21일 Mistral 허깅페이스 조직과 Voxtral 컬렉션을 확인했을 때 Voxtral 3 이름의 체크포인트는 없었어요. 즉 지금은 누구나 내려받아 쓰는 오픈 가중치 모델이 아니라 상용 API 모델로 이해하는 게 정확해요.
- 모델 페이지의 상태 표시(Public Preview)와 Legal 링크를 확인해요. 프리뷰 단계 모델은 이름·동작·가격이 바뀔 수 있어요.
- 같은 정보가 문서마다 다를 수 있어요. 예를 들어 실시간 모델 지원 언어는 발표문 본문에 35개 이상, 모델 카드에 40개 이상, 언어 문서에 45개 언어·방언으로 적혀 있어요. 맥락 길이도 모델 페이지는 32k, 한도 문서는 오디오와 용어 힌트를 합쳐 65,536토큰으로 표기해요. 계약·설계 전에는 최신 문서를 기준으로 다시 확인해요.
- 오디오 보관 여부·처리 지역은 데이터 처리 부속서(DPA)와 지역 엔드포인트 설정을 함께 봐야 해요. 한국 개인정보가 담긴 녹음이라면 국외 이전 고지·동의 요건도 따로 검토해야 해요.
- 나중에 가중치가 공개되더라도 이전 TTS 모델처럼 비상업 라이선스일 수 있으니 모델 카드의 License 항목을 꼭 읽어요.
AI 모델 출시 소식은 빠르게 바뀌니 더따리 AI 텔레그램 트렌드에서 반응을 보고, 블로그 트렌드에서 실제 사용 후기가 쌓이는지 함께 확인하면 발표문만 볼 때보다 판단이 쉬워져요.

받아쓰기·음성 이해에 쓰기 전 확인할 점
- 1
용도부터 나누기
녹음 파일을 글로 옮기면 Mini Transcribe 3로 시작하고, 오류가 용어 힌트로도 안 고쳐지면 Small Transcribe 3로 올려요. 말하는 동안 글자가 필요하면 Realtime 3, 요약·질의응답이 필요하면 Voxtral 2 기반 오디오 챗을 써요.
- 2
내 오디오로 오류율 재기
발표된 수치는 Mistral이 고른 벤치마크의 평균이에요. 실제 회의·통화 녹음 10~20개를 사람이 받아 적은 정답과 비교해 한국어 문자 오류율(CER)을 직접 계산해 보세요. 잡음·사투리·겹쳐 말하기가 많은 환경일수록 차이가 커져요.
- 3
언어 코드 고정 여부 정하기
파일 받아쓰기는 language에 ko 같은 ISO 639-1 두 글자 코드를 넣을 수 있고, 그 밖의 값은 422 오류가 나요. 한국어·영어가 섞인 대화라면 자동 감지와 고정 두 방식을 모두 시험해 봐요.
- 4
기능 조합 제약 확인
실시간 세션에서는 화자 분리와 턴 감지를 동시에 켤 수 없어요. 둘 다 켜면 오류가 나므로 세션을 나눠야 해요. 단어 단위 타임스탬프도 지원하지 않아요.
- 5
비용을 월 단위로 환산
예를 들어 하루 2시간 회의를 Mini Transcribe 3로 받아쓰면 120분 × 0.0035달러 = 0.42달러예요. 실시간 모델은 분당 단가가 두 배 이상이라 상시 녹음에는 파일 방식이 더 저렴할 수 있어요.
위험과 한계: 벤치마크·음성 복제·개인정보
Mistral 차트에서 Voxtral Small Transcribe 3는 FLEURS 45개 언어 평균 단어 오류율이 언어 지정 시 4.1%로, 같은 조건의 Whisper large-v3(16.0%)보다 낮게 나왔어요. 회의 화자 분리 벤치마크(cpWER)는 18.4%, 용어 힌트를 넣은 키워드 재현율은 94.6%였어요. 다만 모두 제조사 발표이고, 비교 대상 선정·설정도 Mistral이 정했어요. 독립 평가가 나오기 전까지는 '방향성 참고'로만 보는 게 좋아요.
- 음성 복제 악용: 30분 음성으로 말투를 재현하는 Pro Voice는 사칭·보이스피싱에 쓰일 수 있어요. 목소리 주인의 명시적 동의와 사용 범위를 문서로 남겨요.
- 민감한 녹음: 의료·금융 상담처럼 민감한 내용은 API로 보내기 전에 보관 정책과 처리 지역을 확인해요. 완전한 사내 처리가 필요하면 현재로선 별도 계약이 필요해요.
- 에이전트 자동 실행: 음성 에이전트가 예약·결제 같은 도구를 호출할 때 받아쓰기 오류가 그대로 잘못된 행동으로 이어질 수 있어요. 숫자·이름은 다시 읽어 확인하는 단계를 넣어요.
- 프리뷰 변경 가능성: Public Preview 모델은 가격·이름이 바뀌거나 이전 버전이 지원 종료될 수 있어요. 모델 ID를 코드에 박지 말고 설정값으로 관리해요.
정리하면, Voxtral 3는 다국어 받아쓰기와 화자 분리, 용어 힌트, 실시간 턴 감지를 낮은 분당 단가로 묶은 API 제품이에요. 한국어 받아쓰기를 검토한다면 내 녹음으로 오류율을 재고, 음성 이해가 필요한지 따로 판단하며, 오픈 가중치가 필요한 환경이라면 이전 세대 공개 모델이나 다른 오픈 모델과 비교해 고르는 순서를 추천해요.