목차8개 섹션
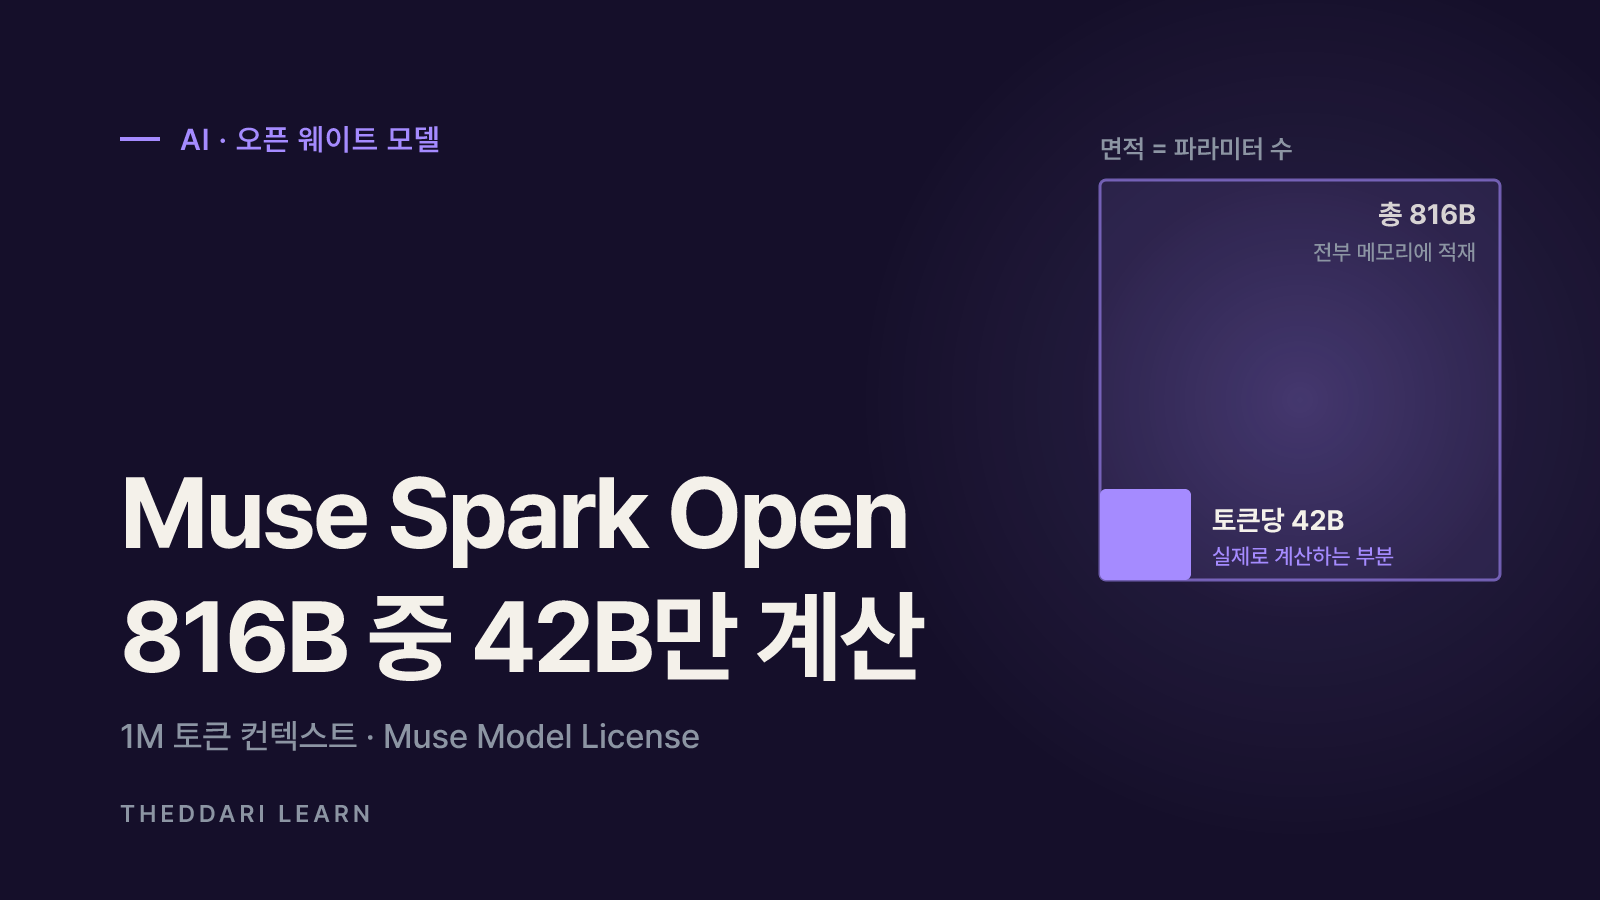
Muse Spark Open은 메타가 2026년 10월 15일 메타 리서치 블로그에서 가중치를 공개한 코딩·에이전트용 멀티모달 AI 모델이에요. 총 816B(8,160억) 파라미터 중 토큰마다 42B만 활성화하는 MoE 구조이고, 100만 토큰 컨텍스트를 지원해요. 핵심은 '오픈'의 범위예요. 누구나 가중치를 무료로 받아 수정·재배포할 수 있지만, 전용 라이선스의 표시 의무와 사용 정책, 대형 MaaS 사업자 계약 조건이 붙어 있어요. 이 글은 2026년 10월 기준 메타 공식 발표와 Hugging Face 모델 카드를 근거로 공개 내용과 확인할 점을 정리해요.
Muse Spark Open은 어떤 모델인가요?
메타는 이 모델을 '지금까지 미국에서 나온 가장 강력한 오픈 웨이트 모델'이라고 소개했어요. 이 표현은 메타 자체의 주장이며, 비교 대상과 측정 방식은 메타가 공개한 평가 방법론 문서에 따라요. 모델 카드상 개발 주체는 메타 슈퍼인텔리전스 랩(Meta Superintelligence Labs)이에요.
| 항목 | 공개된 내용 |
|---|---|
| 공개일 | 2026년 10월 15일 |
| 파라미터 | 총 816B / 토큰당 활성 42B |
| 구조 | Mixture-of-Experts 트랜스포머 + Perception Encoder(1.8B) |
| 전문가 수 | 256개 중 토큰당 8개 활성 |
| 컨텍스트 | 추론 시 최대 100만 토큰 |
| 입력 / 출력 | 텍스트·이미지·영상·오디오 / 텍스트 |
| 언어 | 100개 이상 언어 데이터로 학습 |
| 가중치 형식 | BF16(약 1.6TB), NVFP4(약 530GB) |
| 라이선스 | Muse Model License |
모델 카드가 꼽는 용도는 장기 다단계 추론, 도구를 연속 호출하는 에이전트 작업, 코딩 에이전트, 스크린샷·차트·문서·영상 해석, 합성 데이터 생성, 다른 모델 답변을 채점하는 LLM-as-a-judge예요. 추론 강도(reasoning effort)는 low·medium·high·xhigh 네 단계이고 기본값은 xhigh예요. 복잡한 코딩·에이전트 작업에는 high 이상, 짧고 빠른 답에는 low·medium을 권장해요.
42B 활성이란 무슨 뜻인가요?
MoE 모델은 여러 '전문가' 하위 네트워크 중 일부만 골라 계산해요. 그래서 토큰 하나를 만들 때 실제 연산량은 42B급 모델에 가깝지만, 메모리에는 816B 전체를 올려 둬야 해요. 계산은 가볍고 메모리는 무거운 구조라, 대용량 통합 메모리를 가진 Mac Studio나 여러 장의 데이터센터 GPU가 언급되는 이유가 여기에 있어요.
Muse Spark Open의 '오픈'은 어디까지인가요?
공개된 것은 가중치·코드·설정 파일·문서예요. 학습 데이터는 공개되지 않았고, 모델 카드에는 공개 웹 크롤링, 제3자 구매, 메타 제품·서비스에서 나온 데이터, 합성 데이터가 섞여 있다는 설명만 있어요. 그래서 이 모델은 '오픈소스'보다 '오픈 웨이트'라고 부르는 것이 정확해요.
Muse Model License 핵심 조건
Hugging Face에 게시된 Muse Model License는 사용·복제·수정(미세조정 포함)·증류·병합·배포·판매를 무료로 허용해요. 대신 다음 조건이 붙어요.
- 저작권 고지·라이선스·사용 정책을 모든 사본과 파생 모델에 포함해야 해요.
- 모델이나 파생 모델을 쓰는 제품·서비스의 UI, 문서, 웹사이트 또는 설정 메뉴에 'Built with Muse Spark Open'을 눈에 띄게 표시해야 해요. 여기서 파생 모델에는 이 모델의 출력으로 학습·증류한 모델도 포함돼요.
- 제3자에게 API 등으로 AI 모델을 서비스(MaaS)하고, 본인과 계열사 합산 총매출이 연속 12개월 동안 2천만 달러를 넘으면 메타에 통지하고 별도 서면 계약을 맺어야 해요.
- 내부 사용, 연구, MaaS가 아닌 상업 활동, 자사 제품 기능을 구동하는 용도에는 3번 조건이 적용되지 않아요.
- 메타는 출력물에 대한 소유권을 주장하지 않아요. 모델은 보증 없이 '있는 그대로' 제공돼요.
사용 정책(Exhibit A)은 18세 미만 이용을 상정하지 않으며, 무면허 금융·법률·의료 전문 업무 수행, 악성코드 생성, 안전장치 우회 등을 금지해요. 예를 들어 이 모델로 투자 자문 서비스를 만들려면 해당 관할의 자격 요건부터 따져야 해요.
Hugging Face 다운로드는 승인제(gated)예요. 법적 성명, 생년월일, 법인 식별자를 포함한 조직명을 입력하고 라이선스에 동의해야 하며, 제출 후에는 수정할 수 없다고 안내돼요.
어디서 쓸 수 있고, 직접 돌리려면 무엇이 필요한가요?
메타 개발자 블로그에 따르면 출시일부터 Baseten, Fireworks AI, Groq(제한 프리뷰), Modal, Nebius, OpenRouter, Together AI에서 API로 쓸 수 있어요. 하드웨어 없이 성능부터 평가하려면 이쪽이 가장 빨라요. 가격과 지역 제공 여부는 각 사업자 페이지에서 따로 확인해야 해요.
Amazon SageMaker AI, Google Cloud Model Garden, Microsoft Foundry Models에서 자체 인스턴스로 배포할 수 있어요. 데이터를 외부 API로 보내기 어려운 조직이 검토할 만한 경로예요.
추론 엔진은 SGLang, vLLM, TensorRT-LLM, Hugging Face Transformers, Apple MLX, llama.cpp, Unsloth를 지원해요. 미세조정은 PyTorch TorchTitan, Hugging Face TRL, NVIDIA NeMo AutoModel, Fireworks·Together AI 관리형 API로 할 수 있어요.
필요한 메모리 규모
BF16 원본
- 공개된 요구 사양
- GPU 메모리 약 2TB
- 출처
- 모델 카드
NVFP4(메타 제공)
- 공개된 요구 사양
- GPU 메모리 700GB 이상, Blackwell Ultra 4장 또는 H200 8장
- 출처
- 모델 카드·개발자 블로그
Mac Studio(MLX)
- 공개된 요구 사양
- M5 Ultra 512GB 2대 또는 256GB 4대(총 1TB)
- 출처
- 개발자 블로그
GGUF 약 2비트(Unsloth)
- 공개된 요구 사양
- 시스템 RAM+VRAM 합계 약 300GB
- 출처
- 개발자 블로그
메타는 Mac Studio 두 대를 Thunderbolt 5로 직결하고 MLX 텐서 병렬로 레이어를 나눠, 두 대가 1TB 통합 메모리를 가진 한 대처럼 동작한다고 설명했어요. 양자화 버전은 모델 카드에서도 '일부 상황에서 품질 차이가 있을 수 있다'고 적었으므로, 저비트 GGUF 결과를 원본 성능과 같다고 보면 안 돼요.
벤치마크와 안전성 수치, 어떻게 읽어야 할까요?
모델 카드의 표는 메타가 xhigh 추론 강도로 직접 측정한 결과예요. 에이전트 지표인 JobBench(61.8)와 MCP-Atlas(89.2)에서는 비교 모델 중 가장 높았지만, 종합 지표인 Artificial Analysis Intelligence Index는 39로 GLM 5.3(45), Kimi K3(44)보다 낮았고, Terminal-Bench 2.1도 76.4로 Kimi K3(85.0)에 뒤졌어요. 모든 항목에서 앞선 것이 아니므로 내 용도에 맞는 지표를 골라 보는 것이 중요해요.
- 안전성: 오픈 웨이트용 추가 안전 후학습을 했고, 메타 내부 사이버 탈옥 벤치마크에서 99.2%를 거부했다고 밝혔어요.
- 한계: 이 결과는 공개된 체크포인트 그대로의 조건이에요. 모델 카드는 미세조정 등 수정이 안전성을 떨어뜨릴 수 있고, 수정 모델에 같은 결과를 가정하면 안 된다고 적었어요.
- 검증: 메타는 전체 평가 보고서를 '곧 공개'한다고 했고, 공개 당시 날짜는 밝히지 않았어요. 제3자 재현 결과가 나오기 전까지는 자체 측정치로 봐야 해요.
메타 오픈 모델 전략에서 이번 공개의 의미
TNW 보도에 따르면 메타는 같은 주 월요일에 최상위 폐쇄형 모델 Muse Wonder를 발표했고, Muse Spark Open은 그보다 성능이 낮다고 밝혔어요. 알렉산더 왕 최고 AI 책임자는 '안전과 성능 때문에 가장 강력한 모델은 대체로 오픈소스로 공개하지 않겠다'고 말했어요. 같은 보도는 8월 Apache 2.0으로 공개된 30B 모델 Muse Glimmer에 이어 Muse 계열의 두 번째 공개라고 전했어요. 정리하면 메타는 최상위 모델은 닫고, 한 단계 아래 모델의 가중치를 여는 이원 전략을 택한 셈이에요.
이런 AI 모델 공개 소식은 하루에도 여러 건 나와요. 텔레그램 채널에서 퍼지는 AI 업계 반응은 더따리 AI 텔레그램 트렌드에서, 블로그·커뮤니티 글 흐름은 블로그 트렌드 대시보드에서 모아 볼 수 있어요.

Muse Spark Open을 쓰기 전 확인 체크리스트
- 1
용도와 라이선스 대조
내 서비스가 모델 자체를 API로 파는 MaaS인지, 자사 기능을 구동하는 용도인지 먼저 구분해요. 매출 기준 2천만 달러는 계열사 합산·연속 12개월 기준이에요.
- 2
표시 의무 반영
제품 UI나 문서에 'Built with Muse Spark Open' 문구를 넣을 위치를 정해요. 파생 모델을 배포할 때도 라이선스와 사용 정책을 함께 포함해야 해요.
- 3
호스팅 API로 먼저 평가
하드웨어를 사기 전에 OpenRouter·Together AI 같은 호스팅 API에서 실제 업무 데이터(한국어 포함)로 품질과 비용을 확인해요.
- 4
추가 가드레일 설계
모델 카드는 시스템 수준 가드레일과, 되돌릴 수 없는 행동 앞에 사람 확인 단계를 두라고 권장해요. 에이전트에게 결제·삭제 권한을 줄 때는 특히 중요해요.
- 5
개인정보·관할 확인
사용 정책은 법적 권리 없이 개인 민감정보를 처리·추론하는 것을 금지해요. 한국에서 서비스한다면 개인정보 보호법 등 국내 규정도 별도로 검토해요.
요약하면 Muse Spark Open은 가중치를 내려받아 고칠 수 있는 대형 에이전트 모델이지만, 라이선스 조건과 수백 GB 단위의 메모리 요구가 함께 따라와요. 공식 모델 카드와 라이선스 원문을 직접 읽고, 호스팅 API로 작게 시험한 뒤 도입 범위를 정하는 순서가 안전해요.