LIBERO-PeRM이란? 사람마다 다르게 일하는 개인화 로봇 조작 벤치마크 정리
LIBERO-PeRM은 로봇이 과제를 끝냈는지와 사용자 선호를 지켰는지를 따로 재는 개인화 로봇 조작 벤치마크예요. 312개 과제 구성, 측정 지표, 주요 실험 결과와 한계를 정리했어요.
목차9개 섹션
핵심 요약
- LIBERO-PeRM은 로봇이 과제를 성공했는지(SR)와 사용자 선호를 지켰는지(SA)를 분리해 재는 개인화 로봇 조작 벤치마크예요.
- 5개 과제 묶음, 312개 과제, 37개 단일 선호와 18개 선호 쌍, 4만 800개 시연 데이터로 구성돼 있어요(2026년 10월 공개 기준).
- 선호는 동작(motion), 기술(skill), 사용자 프로필(user profile) 세 단계로 나뉘며, 모두 과제 목표는 바꾸지 않고 '어떻게 하느냐'만 바꿔요.
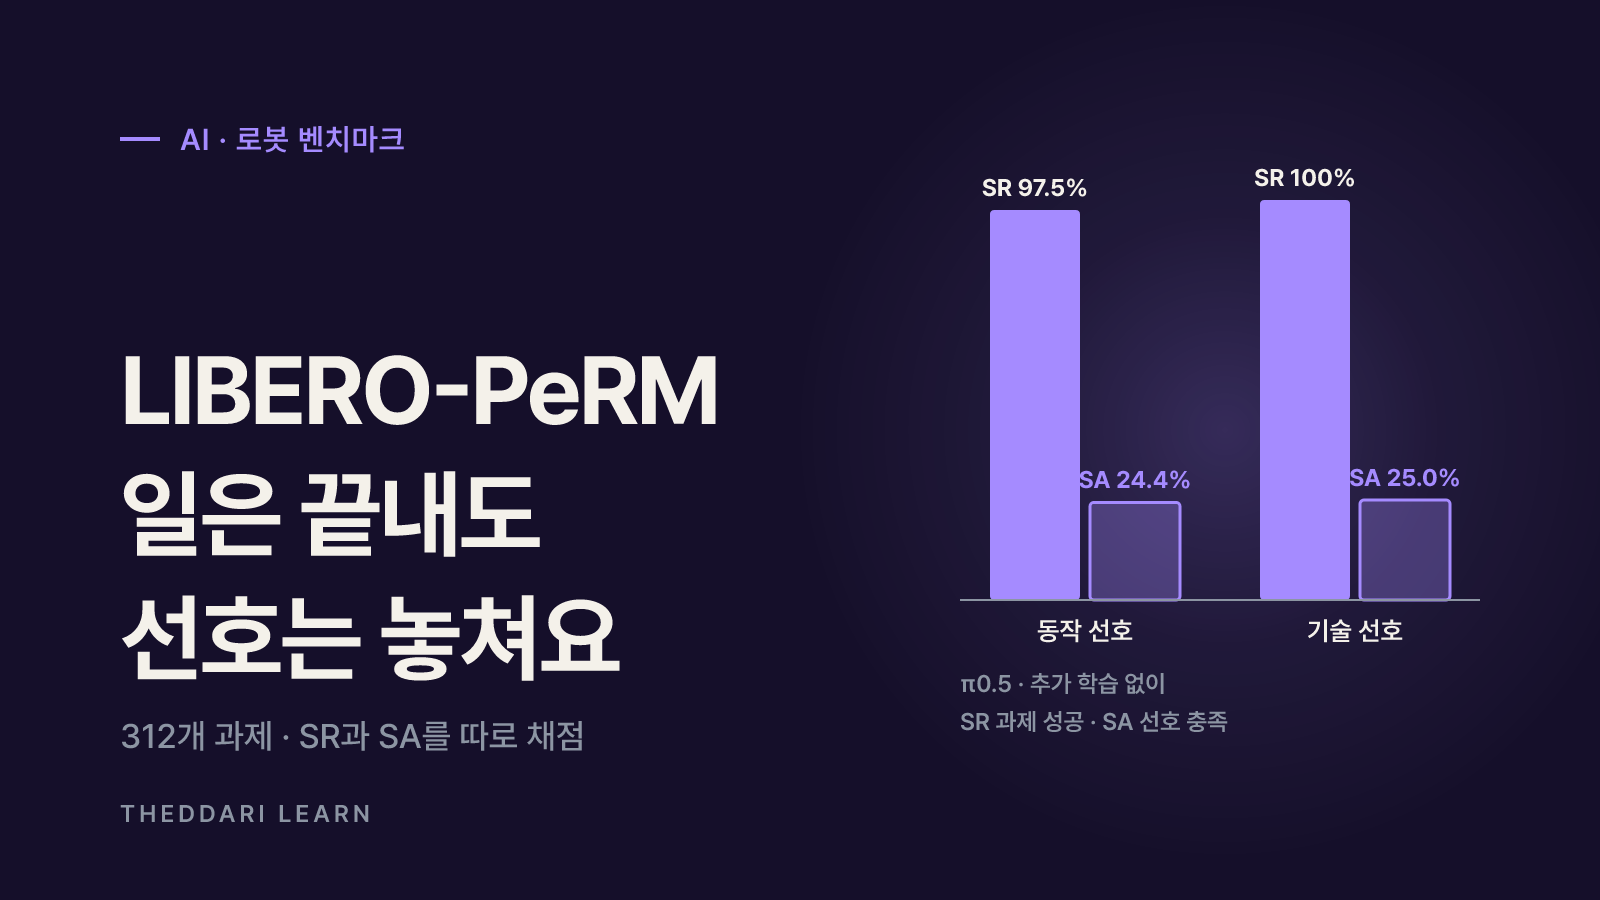
- 추가 학습 없이 시험한 π0.5는 동작 선호 과제를 97.5% 성공했지만 선호 충족은 24.4%에 그쳤어요. 일은 끝내도 방식은 무시한 셈이에요.
- 미세조정하면 선호를 배울 수 있지만, 처음 보는 배치·과제로의 일반화와 선호 충돌 처리는 여전히 어려운 과제로 남아 있어요.
LIBERO-PeRM은 로봇이 '일을 끝냈는지'와 '사용자가 원하는 방식으로 했는지'를 따로 채점하는 개인화 로봇 조작 벤치마크예요. 2026년 10월 15일 arXiv에 공개된 논문과 프로젝트 페이지를 2026년 10월 기준으로 확인해 보면, 결론은 분명해요. 지금의 범용 로봇 AI(VLA 모델)는 과제는 잘 끝내지만, 사람마다 다른 선호는 추가 학습 없이 거의 따르지 못해요. 이 글은 벤치마크가 무엇을 측정하는지, 원조 LIBERO와 무엇이 다른지, 결과 수치를 어떻게 읽어야 하는지를 일반 독자 눈높이로 정리해요.
LIBERO-PeRM이란? 개인화 로봇 조작을 재는 벤치마크
가정용 로봇을 떠올려 보세요. 같은 '머그컵을 선반에 올려 줘'라는 부탁이라도 누군가는 천천히 조심스럽게, 누군가는 칼 근처를 피해서, 누군가는 손잡이를 잡아서 옮기길 원해요. 논문은 이런 개인화 로봇 조작(Personalized Robotic Manipulation, PeRM)이 범용 로봇이 집 안으로 들어오는 데 필수라고 보지만, 지금까지는 과제 완수와 선호 충족을 분리해 비교할 통제된 벤치마크가 없었다고 지적해요.
LIBERO-PeRM은 이 빈자리를 채우려는 평가 도구예요. 미국 UC 리버사이드, 예일대, 조지아공대, 미시간대, 토론토대 소속 연구자 10명이 만들었고, 프로젝트 페이지에는 NeurIPS 2026 평가·데이터셋 트랙 논문으로 표기돼 있어요. 코드·데이터셋·시연 영상도 함께 공개됐어요.
| 항목 | 내용(2026년 10월 공개 자료 기준) |
|---|---|
| 과제 수 | 312개, 5개 과제 묶음(suite) |
| 선호 단계 | 동작·기술·사용자 프로필 3단계 |
| 선호 개수 | 단일 선호 37개, 선호 쌍 18개 |
| 시연 데이터 | 약 4만 800개(선호 있음·없음 짝) |
| 평가 대상 | 공개 VLA 정책 6개 + π0.5 기반 미세조정 |
| 환경 | LIBERO 시뮬레이션 |
선호는 '목표'가 아니라 '방식'이에요
이 벤치마크에서 선호는 별도의 목표가 아니에요. 과제 목표는 그대로 두고 수행 방식을 기울이는 조건 신호로 정의돼요. 또 말로 표현할 수 있고, 시뮬레이션에서 자동 채점이 가능하며, 여러 과제에 재사용할 수 있는 선호만 다뤄요. 로봇이 받는 입력은 '과제: …. 선호: ….' 형태로 이어 붙인 문장 하나와 카메라 두 대(외부 시점·손목 시점)의 영상이에요.
세 가지 선호 단계: 동작·기술·사용자 프로필
LIBERO-PeRM은 선호가 실행의 어느 부분을 제약하느냐에 따라 세 단계로 나눠요. 단계마다 채점 방식도 달라요.
경로 자체를 바꿔요. 이동 시간, 가속도, 옆으로 옮길 때의 높이, 운반 경로의 직선성, 특정 물체와의 거리 등을 궤적에서 계산해 채점해요.
핵심 순간의 자세를 바꿔요. 잡을 때 그리퍼 위치·접근 각도, 놓을 때 내려놓는 방식처럼 웨이포인트에서 채점해요.
어떤 대상을 고르는지를 바꿔요. 먼저 집는 물체나 놓을 위치가 프로필이 암시하는 선택과 맞는지 실행된 하위 과제로 채점해요.
세 단계 모두 점수는 0, 1/4, 3/4, 1 네 등급으로 바뀌어 같은 척도에서 비교돼요. 사용자 프로필 선호는 과제 대상 자체가 달라지므로 가장 어려워요. 예를 들어 같은 물체의 빨간 버전을 장면에 추가하고, 과제 문장을 추상화해 두 행동을 모두 포괄하게 만드는 식이에요.
LIBERO와 LIBERO-PeRM은 무엇이 다를까
원조 LIBERO는 2023년에 공개된 평생 학습(lifelong learning) 로봇 조작 벤치마크예요. 4개 과제 묶음, 총 130개 과제에 사람이 원격 조작한 시연 데이터를 제공하고, 로봇이 새 과제를 배우면서 이전 지식을 얼마나 옮겨 쓰는지를 봐요. LIBERO-PeRM은 이 환경을 바탕으로 질문을 바꿨어요.
핵심 질문
- LIBERO(2023)
- 새 과제를 배우며 지식을 이어 쓰는가
- LIBERO-PeRM(2026)
- 같은 과제를 사람마다 다른 방식으로 하는가
과제 규모
- LIBERO(2023)
- 4개 묶음, 130개 과제
- LIBERO-PeRM(2026)
- 5개 묶음, 312개 과제
시연 데이터
- LIBERO(2023)
- 사람 원격 조작 시연
- LIBERO-PeRM(2026)
- 절차적 파이프라인 생성 + 사람 검수, 선호 있음·없음 짝
주요 지표
- LIBERO(2023)
- 과제 성공 중심
- LIBERO-PeRM(2026)
- 과제 성공(SR)과 선호 충족(SA) 분리
데이터는 어떻게 만들었나
- 1
배치 최소 수정
시각-언어 모델(VLM)이 선호를 실행할 수 있게 장면을 최소한으로 고쳐요. 동작·기술 선호는 배치와 과제 문장을 그대로 두고 피할 물체 같은 대상만 정해요.
- 2
선호 조건 시연 생성
VLM이 선호 없는 계획과 선호 있는 계획을 각각 쓰고, 사람 시연 1개와 경로 계획기로 만든 기술 라이브러리가 이를 궤적으로 바꿔요. 프로젝트 페이지는 72% 넘는 기술이 과제별 미세 보정 없이 쓰였다고 밝혀요.
- 3
충족도 지표 생성
선호마다 명시적 채점식을 붙여, 사람이 일일이 보지 않아도 자동 평가가 가능하게 해요.
5개 과제 묶음과 SR·SA 지표 읽는 법
- LIBERO-SinglePref(100개): 단일 선호를 배우고 실행하는 기본 묶음이에요.
- LIBERO-PrefScale(100개): 시연 수·과제·배치를 늘릴 때 선호 학습이 어떻게 확장되는지 봐요.
- LIBERO-PrefConflict(48개): 동시에 지킬 수 없는 두 선호, 또는 과제와 충돌하는 선호를 다뤄요.
- LIBERO-PrefCompose(64개): 선호 없음, 선호 A, 선호 B, A+B 네 조건을 배치마다 맞춰 조합 능력을 봐요.
- LIBERO-ComprePref: 새 과제 없이 다른 묶음의 프롬프트를 바꿔 써요. 선호를 명시하지 않고 암시만 하는 문장도 포함돼요.
SR(과제 성공률)은 목표에 도달한 에피소드 비율이에요. SA(선호 충족도)는 성공한 에피소드에만 선호 점수를 곱해 평균 내요. 그래서 SA는 SR을 넘을 수 없고, SR은 높은데 SA가 낮으면 '일은 했지만 원하는 방식은 무시했다'는 뜻이에요.
주요 실험 결과: 일은 끝내도 선호는 무시해요
연구진은 OpenVLA-OFT, π0-fast, π0.5, GR00T-N1.6, SmolVLA, UniVLA 6개 VLA 정책을 추가 학습 없이(zero-shot) 평가했어요. 아래 수치는 모두 프로젝트 페이지에 실린 시뮬레이션 결과예요.
π0.5 선호 없는 과제
- 결과
- SR 97.6%
- 의미
- 장면 수정이 과제를 어렵게 만들지는 않았어요
π0.5 동작 선호
- 결과
- SR 97.5% / SA 24.4%
- 의미
- 과제는 거의 다 끝내지만 선호는 4번 중 1번꼴
π0.5 기술 선호
- 결과
- SR 100% / SA 25.0%
- 의미
- 같은 패턴이에요
π0.5 사용자 프로필
- 결과
- SR 19.1%
- 의미
- 대상이 바뀌자 과제 성공부터 무너져요
LoRA 미세조정(전체 선호)
- 결과
- SR 85.0 / SA 82.5
- 의미
- 시연으로 배우면 선호를 학습할 수 있어요
처음 보는 배치(LoRA)
- 결과
- SR 37.5 / SA 28.4
- 의미
- 배운 선호의 일반화는 아직 약해요
학습 순서와 데이터 구성의 트레이드오프
LIBERO를 먼저 배우고 선호를 나중에 배우는 순차 학습은 선호 없는 과제 성공률을 52.3%까지 떨어뜨렸어요. 둘을 섞어 한 번에 학습하면 91.0%를 유지했고, 표현을 바꾼 프롬프트(ComprePref)에서도 SR/SA 72.8/70.1로 선호만 학습한 경우(44.0/42.6)보다 나았어요. 다만 섞어 학습하면 동작 선호의 성공률이 90.0%에서 66.9%로 떨어져, 항상 나은 방식은 아니에요. 같은 2,250개 시연 예산이라면 배치당 시연을 늘리는 것보다 다양한 배치에 나눠 쓰는 편이 더 도움이 됐다고 해요.
조합·분해·충돌은 여전히 어려워요
- 선호 A와 B를 따로 배운 뒤 A+B를 함께 요구하면 SR·SA가 25.0%에 그쳤어요.
- A+B와 A를 배운 뒤 B만 꺼내 쓰게 하면 SR 37.5%, SA 0.0%였어요. 일은 했지만 원하는 선호는 하나도 못 지켰어요.
- 두 선호가 충돌하면 SR/SA가 73.0/63.4에서 66.0/47.8로 떨어졌고, 어느 한쪽이 확실히 우선되지도 않았어요.
- 선호가 과제와 충돌할 때는 과제를 따른 경우 33.3%, 선호를 따른 경우 29.2%, 둘 다 못한 경우가 37.5%였어요.
한계와 읽을 때 주의할 점
이 결과를 '로봇은 개인화를 못 한다'로 일반화하면 곤란해요. 첫째, 모든 실험은 시뮬레이션이에요. 실제 가정의 조명·물체·센서 오차는 반영되지 않아요. 둘째, 다루는 선호는 말로 표현할 수 있고 자동 채점이 가능한 것으로 제한돼요. '보기 좋게 정리해 줘'처럼 주관적인 선호는 범위 밖이에요. 셋째, 미세조정 실험은 π0.5 한 모델에서 출발했어요. 다른 모델에서도 같은 트레이드오프가 나올지는 추가 검증이 필요해요. 넷째, 2026년 10월 기준 논문은 v1이라 이후 개정판에서 수치가 바뀔 수 있으니 인용할 때는 버전을 함께 적는 게 좋아요.
로봇·AI 연구 소식은 빠르게 쏟아지고, 논문 한 편이 시장 이야기로 과장돼 퍼지기도 해요. 관련 화제가 어떤 맥락에서 언급되는지는 더따리의 AI 텔레그램 채널 모음과 블로그 트렌드에서 함께 살펴볼 수 있어요.

정리: 개인화 로봇 연구를 볼 때 확인할 것
- 과제 성공률과 선호 충족도를 따로 보고했는지 확인해요. 성공률만 높다고 '내 방식대로 일한다'는 뜻은 아니에요.
- 추가 학습 없는 결과인지, 미세조정 후 결과인지 구분해요.
- 처음 보는 배치·과제에서의 일반화 수치가 함께 있는지 봐요.
- 시뮬레이션인지 실제 로봇인지, 논문 버전과 공개 날짜를 확인해요.