텐센트 Hy4-flash란? 특징과 API·로컬 실행 전 확인할 점
텐센트 Hy4-flash는 총 220B·활성 12B MoE 멀티모달 모델이에요. 1M 컨텍스트, OpenRouter 가격, GGUF 크기, 라이선스 상업 조건을 정리했어요.
목차8개 섹션
핵심 요약
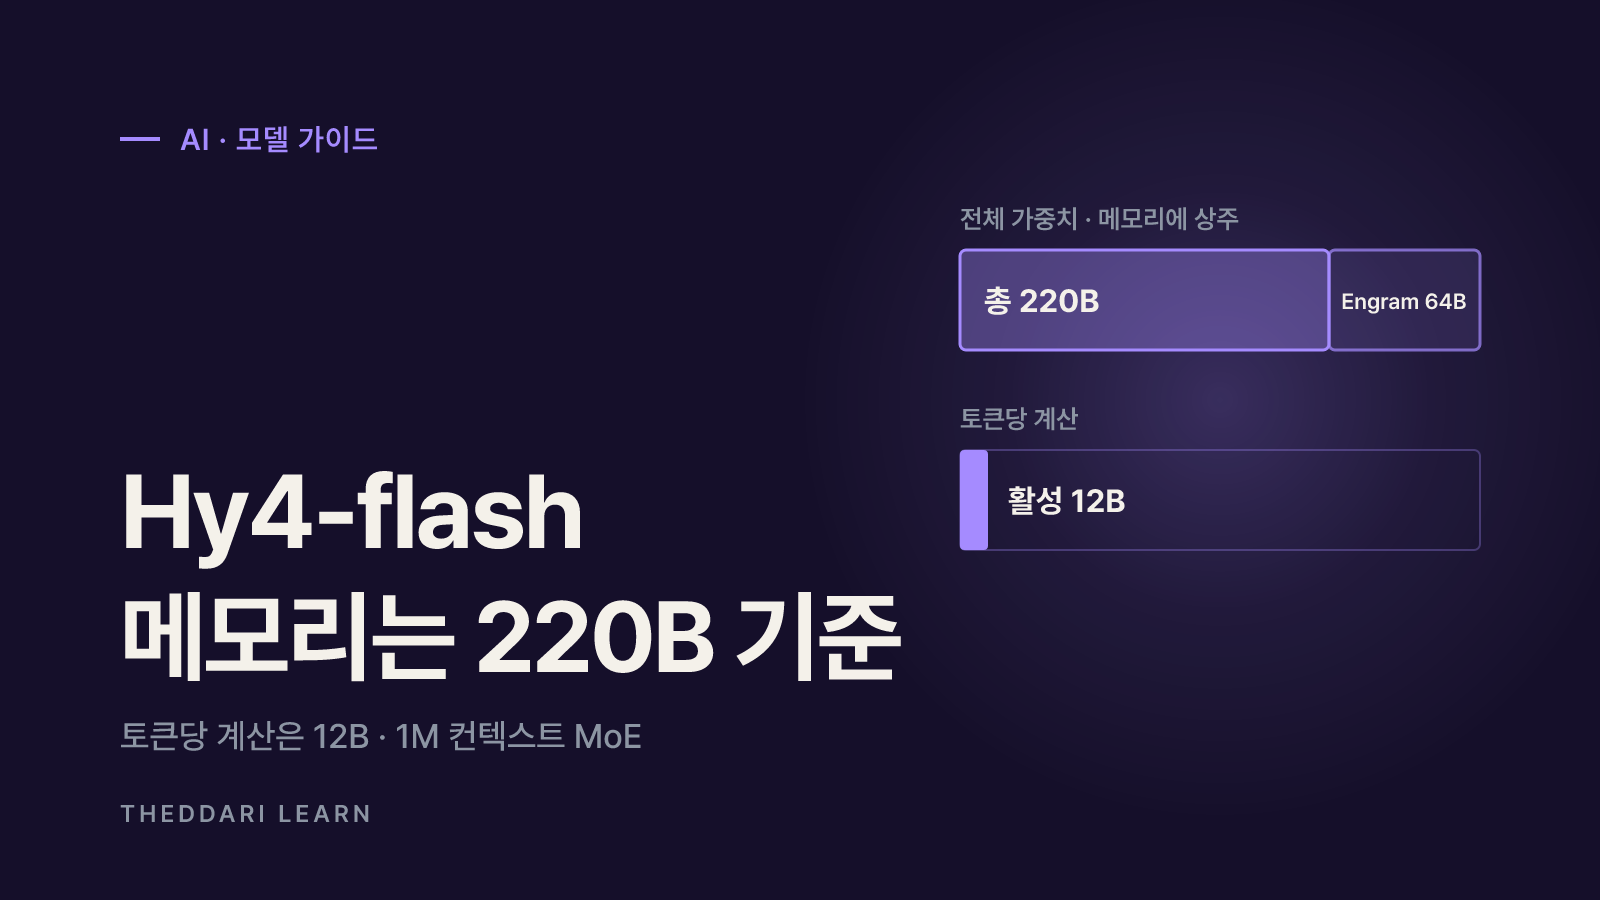
- Hy4-flash는 텐센트가 공개한 오픈 웨이트 MoE 모델로, 총 220B 파라미터 중 토큰당 약 12B만 활성화되고 텍스트·이미지 입력과 최대 1M 토큰 컨텍스트를 지원해요.
- 공식 성능·비용 비교의 핵심 수치(WorkIndex 42.1, 블라인드 평가 2.79/4)는 텐센트 내부 벤치마크와 내부 사용자 평가라서 독립 평가로 교차 확인이 필요해요.
- API는 OpenRouter에서 Tencent Cloud 제공자 기준 입력 100만 토큰당 0.035달러, 출력 0.1405달러로 표시돼요(2026년 11월 20일 확인).
- 로컬 실행은 가장 작은 GGUF도 약 126GiB라서 128GB급 통합 메모리 장비나 멀티 GPU 서버가 필요하고, llama.cpp 지원은 아직 병합 전 PR 브랜치예요.
- 라이선스는 Apache 2.0 기반이지만 연매출 5천만 달러 초과 또는 월 사용자 1억 명 초과 서비스가 API형(MaaS)으로 제공하면 별도 계약이 필요해요.
Hy4-flash는 텐센트 Hy(옛 Hunyuan) 팀이 공개한 오픈 웨이트 멀티모달 MoE 모델이에요. 총 220B 파라미터 중 토큰당 약 12B만 계산에 쓰는 구조로, 텍스트와 이미지를 입력받아 텍스트를 만들고 최대 1M 토큰 컨텍스트를 지원한다고 공식 모델 카드에 적혀 있어요. 2026년 11월 20일 기준 허깅페이스에서 좋아요 479개를 받으며 빠르게 주목받고 있어요.
결론부터 말하면, 가볍게 써 보려면 API가 현실적이고 로컬 실행은 128GB급 메모리 장비부터 시작하는 대형 모델이에요. 상업 서비스에 넣을 계획이라면 Apache 2.0과 비슷해 보이는 라이선스에 붙은 추가 조건을 먼저 확인해야 해요. 이 글은 2026년 11월 20일에 확인한 모델 카드·라이선스·OpenRouter·GGUF·vLLM 문서를 근거로 정리했어요.
Hy4-flash란? 구조와 핵심 사양
Hy4-flash는 텐센트가 "지금까지 가장 비용 효율적인 Hy 모델"이라고 소개한 모델이에요. 이름의 flash는 상위 모델 Hy4보다 싸고 빠르게 돌리는 데 초점을 맞췄다는 뜻이에요. 같은 시점에 지시 튜닝 모델(Hy4 flash), FP8 양자화 모델(Hy4 flash-FP8), 사전학습 베이스 모델(Hy4 flash-base)이 함께 공개됐어요. 베이스 모델은 대화용이 아니므로 챗봇·에이전트 용도라면 Hy4 flash나 FP8 버전을 골라야 해요.
총 파라미터
- 공식 값
- 220B(Engram 64B 포함)
- 읽는 법
- 파일 크기·메모리 요구량을 결정해요
토큰당 활성 파라미터
- 공식 값
- 텍스트 11.3B + 비전 0.43B
- 읽는 법
- 연산량·속도에 가까운 값이에요
백본
- 공식 값
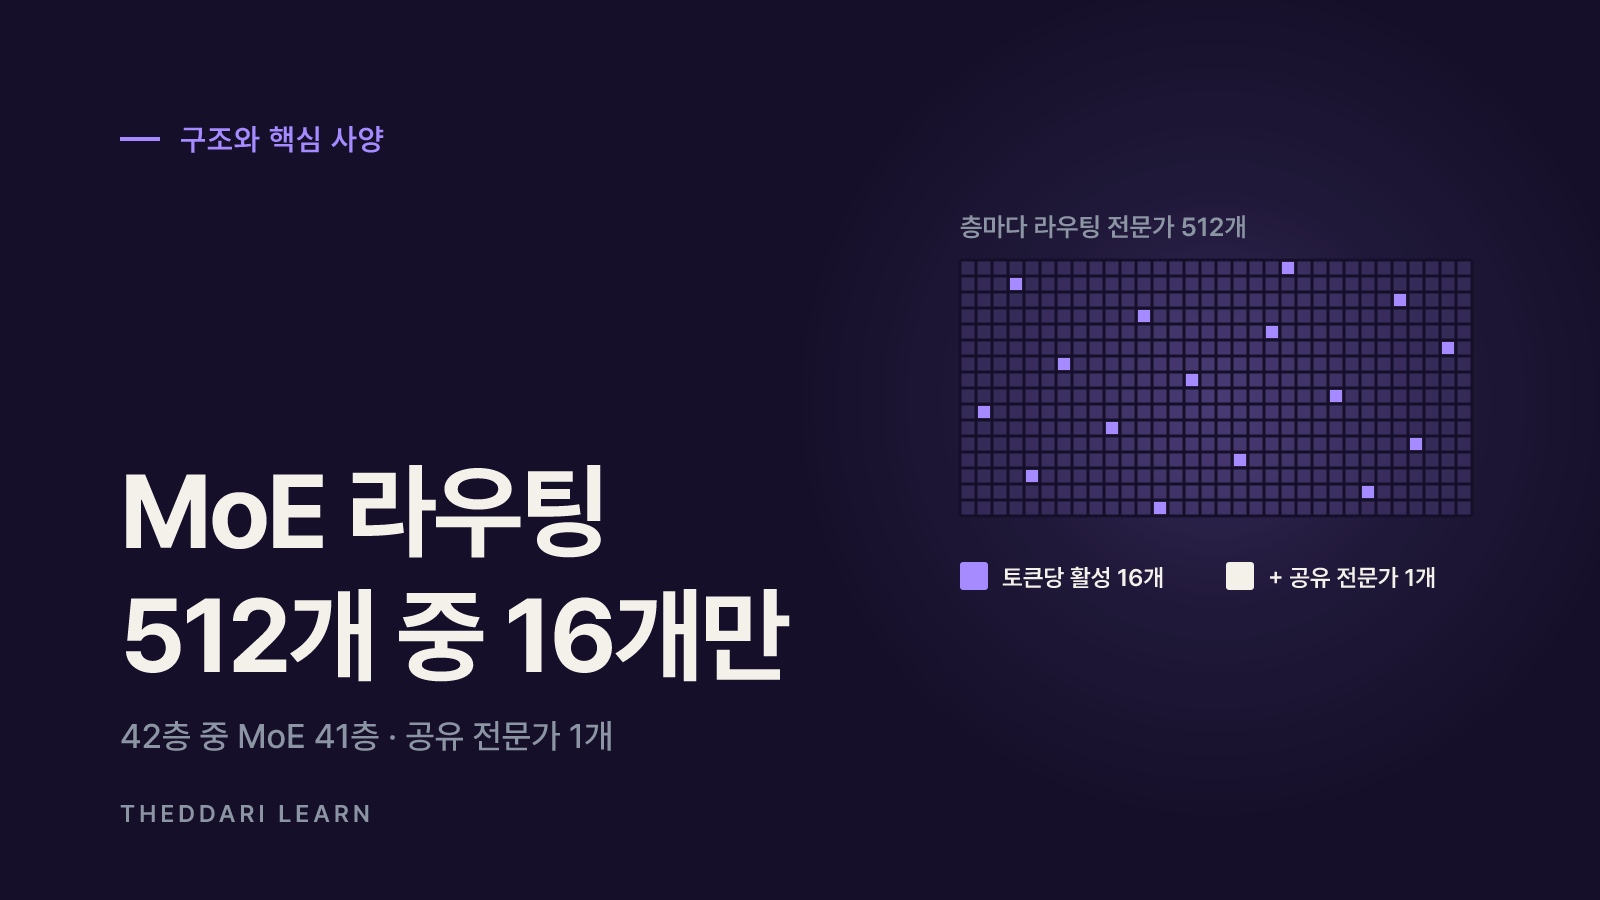
- 42층(밀집 1층 + MoE 41층)
- 읽는 법
- 층마다 512개 전문가 중 16개 + 공유 1개 활성
컨텍스트
- 공식 값
- 1M(1,048,576 토큰)
- 읽는 법
- 서빙 설정에서 실제 길이를 따로 지정해요
입출력
- 공식 값
- 텍스트·이미지 입력 → 텍스트 출력
- 읽는 법
- 영상 입력은 vLLM 레시피 기본값에서 꺼져 있어요
추론 모드
- 공식 값
- reasoning_effort: high(기본) / no_think
- 읽는 법
- 생각 모드를 끄면 바로 답해요
비용을 줄인 세 가지 장치
- 하이브리드 어텐션: 희소 어텐션과 슬라이딩 윈도 어텐션을 1:3 비율로 섞었어요. 그 결과 KV 캐시가 Hy3의 24분의 1, Hy4의 6분의 1로 줄었다고 해요.
- LatentMoE: 전문가 네트워크가 더 낮은 차원의 잠재 공간에서 계산해요.
- N-gram 임베딩(Engram): 2-gram·3-gram 표현을 해시 조회로 꺼내 쓰는 63.5B 규모 테이블이에요. 파라미터 수는 크게 늘리지만 vLLM 기본 설정에서는 GPU가 아니라 호스트 RAM으로 내려 둬요.
여기에 0.85B 크기의 초안 모델 DFly2가 붙어 있어 추측 디코딩(speculative decoding)을 해요. 텐센트는 메가커널·4비트 양자화·DFly2를 함께 쓰면 디코딩 속도가 초당 150토큰을 넘는다고 밝혔지만, 이는 자체 서빙 환경 기준이라 개인 장비 속도와는 달라요.
공식 성능·비용 수치, 어떻게 읽을까
모델 카드의 대표 수치는 대부분 텐센트 내부 평가예요. 숫자 자체보다 어떤 조건에서 나온 값인지 먼저 확인해야 해요.
WorkIndex 42.1(Hy4 preview 39.7, Hy4 51.4)
- 근거 범위
- 텐센트 내부 벤치마크 8개 세트
- 확인할 점
- 슬라이드·문서·스프레드시트 등 WorkBuddy 업무 중심이에요
작업당 비용 Hy4 preview의 1/13, Hy4의 1/20
- 근거 범위
- 같은 WorkIndex 작업
- 확인할 점
- DeepSeek-V4.1-Flash-1017 대비 1/8은 Max 등급·피크 시간 요금 기준이에요
블라인드 평가 2.79/4(Claude Haiku 5.5는 2.81/4)
- 근거 범위
- 내부 사용자 85명, 259개 작업
- 확인할 점
- 작업 중앙값 6.7분, 작업당 0.26위안이에요
MMLU 88.7 등 베이스 점수
- 근거 범위
- 사전학습 베이스 모델 few-shot
- 확인할 점
- 지시 튜닝 모델 성능과 다르고 형식 오류로 점수가 왜곡될 수 있다고 직접 밝혔어요
정리하면 Hy4-flash는 "최고 성능"보다 "비슷한 품질을 더 싸게"를 내세운 모델이에요. 텐센트도 딥 서치, 문서 처리, 슬라이드 작성, 간단한 프론트엔드 데모, 컴퓨터 사용 같은 일상 업무에 권장하고, 장기 소프트웨어 엔지니어링처럼 복잡한 작업에는 상위 모델 Hy4를 권해요. 블라인드 평가 참가자가 텐센트 내부 사용자이고 작업도 자사 제품 업무라는 점을 감안해, 독립 리더보드나 자기 업무 샘플로 다시 비교해 보는 것이 좋아요.
AI 모델 출시 소식은 하루에도 여러 건 나와요. 더따리 AI 텔레그램 트렌드에서 Hy4-flash처럼 커뮤니티에서 언급이 늘어나는 모델을 함께 살펴보면 화제성과 실제 평가를 구분하는 데 도움이 돼요.
API로 쓰는 두 가지 방법
1) OpenRouter 같은 호스팅 API
가장 빠른 방법이에요. OpenRouter 모델 페이지에는 2026년 11월 20일 기준 Tencent Cloud 제공자 가격이 입력 100만 토큰당 0.035달러, 출력 100만 토큰당 0.1405달러로 표시돼요(추가 요금 항목이 하나 더 있어 전체 가격표 확인이 필요해요). 모델 ID는 tencent/hy4-flash이고 OpenAI 호환 Chat Completions 형식으로 호출하며 tools·reasoning·response_format 같은 옵션을 받아요.
- 제공자가 Tencent Cloud 하나뿐이면 장애·지연 시 대체 경로가 없어요.
- OpenRouter는 이 모델이 현재 EU 지역 내 라우팅으로는 제공되지 않는다고 밝혔어요. 데이터 처리 위치 규정이 있는 조직은 사전에 확인하세요.
- 입력 데이터가 어느 제공자·국가에서 처리되는지, 로그 보관 정책이 어떤지 제공자 약관을 따로 읽어야 해요.
2) 직접 서버를 띄우는 자체 API
공식 문서는 운영 서빙에 vLLM이나 SGLang을 권장해요. 서버를 띄우면 http://127.0.0.1:8000/v1 같은 OpenAI 호환 엔드포인트로 호출할 수 있어요. 권장 샘플링 값은 temperature 0.9, top_p 1.0이고, 바로 답하게 하려면 reasoning_effort를 no_think로 넘겨요. vLLM 레시피 기준으로는 아직 정식 pip 패키지가 이 모델을 등록하지 않아 전용 Docker 이미지 vllm/vllm-openai:hy4-flash를 써야 해요. Transformers도 아직 본 브랜치에 병합되기 전이라 모델 카드가 지정한 PR 커밋으로 설치해야 해요.
로컬 실행에 필요한 사양
활성 파라미터가 12B라고 해서 12B 모델처럼 가볍게 돌아가지는 않아요. MoE는 계산할 때 일부 전문가만 쓰지만 모든 전문가 가중치가 메모리에 올라가 있어야 하기 때문이에요. 그래서 메모리 요구량은 총 파라미터 220B를 기준으로 생각해야 해요.
vLLM BF16
- 필요 용량(공식 표기)
- 다운로드 440.5GB, VRAM 힌트 529GB
- 조건
- H100·H200·B200 등 8장 텐서 병렬
vLLM FP8
- 필요 용량(공식 표기)
- 다운로드 287.1GB, VRAM 힌트 345GB
- 조건
- Hopper·Blackwell 데이터센터 GPU
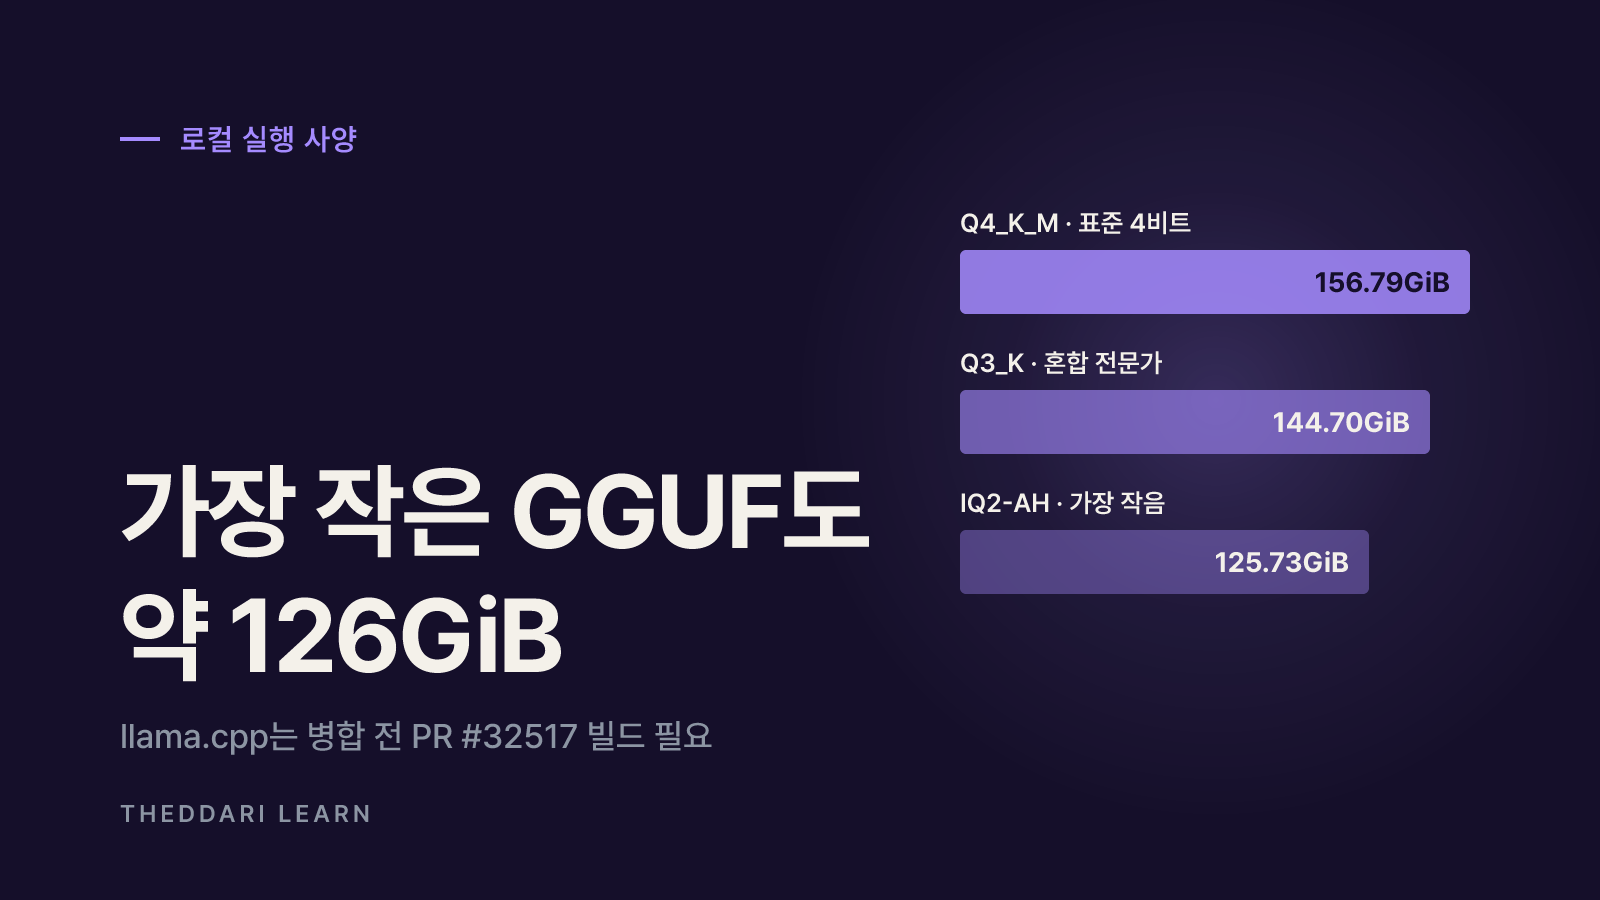
GGUF Q4_K_M
- 필요 용량(공식 표기)
- 156.79GiB
- 조건
- 표준 4비트, 메모리가 넉넉하면 기본 선택
GGUF Q3_K
- 필요 용량(공식 표기)
- 144.70GiB
- 조건
- Q3/Q4 혼합 전문가
GGUF IQ2-AH
- 필요 용량(공식 표기)
- 125.73GiB
- 조건
- 5개 GGUF 중 가장 작음
vLLM 레시피의 VRAM 힌트는 다운로드 크기에 1.2를 곱한 보수적 추정치이고, Engram 테이블을 CPU 메모리로 내리면 실제 GPU 사용량은 낮아져요. 대신 호스트 RAM을 따로 넉넉히 준비해야 해요. AMD Instinct GPU는 아직 지원 이미지가 없고, 데이터 병렬·파이프라인 병렬·LoRA 서빙도 지원하지 않는다고 적혀 있어요. 레시피 기본값은 컨텍스트 8,192토큰, 동시 요청 4개로 시작하므로 1M 컨텍스트를 실제로 쓰려면 메모리를 훨씬 더 확보해야 해요.
GGUF로 개인 장비에서 돌릴 때
텐센트 AngelSlim 팀의 Hy4-flash-GGUF 저장소는 Mac M5 Max 128GB에서 Q4_K_M이 4K 컨텍스트 기준 초당 약 48토큰을 생성했다고 공개했어요. 다만 이 수치는 텐센트 업무 시나리오 측정이고, 파일 크기가 128GB를 넘는 만큼 저장소의 Mac 전용 README 설정을 그대로 따라야 해요. 또 llama.cpp 지원은 병합 전 PR #32517 브랜치를 직접 받아 빌드해야 하고, 모델 카드는 이 GGUF를 "엔드투엔드 테스트 목적"으로 제공한다고 적었어요. Ollama·LM Studio 원클릭 실행 링크가 보이더라도 공식 llama.cpp 릴리스가 지원하기 전까지는 실패할 수 있어요.
라이선스: 상업적으로 써도 될까
Hy4-flash의 라이선스는 Tencent Hy License 1.0이에요. Apache 2.0을 바탕으로 했지만 Apache 2.0 자체는 아니며, 10조에 대형 MaaS 사업자용 추가 상업 조건이 붙어 있어요. 2026년 11월 20일 확인한 원문 기준으로 사용 허락은 전 세계(worldwide) 범위로 적혀 있어요.
- 1
MaaS에 해당하는지 확인
MaaS는 제3자에게 API 등으로 모델 추론·파인튜닝에 원격 접근하게 해 입력·파라미터·학습 데이터를 직접 넣게 하는 사업이에요. 특정 기능·워크플로에만 모델을 쓰는 최종 사용자 제품, 외부 모델 서비스로 요청만 중계하는 경우는 빠져요.
- 2
매출·사용자 기준 확인
MaaS 사업자가 연속 12개월 전 세계 총매출 5천만 달러를 넘거나, 월 활성 사용자 1억 명을 넘는 제품·서비스에 쓰면 사용 전에 텐센트와 별도 서면 계약이 필요해요. 매출 기준은 이 모델과 무관한 매출도 포함해요.
- 3
내부 사용 예외 확인
모델과 파생물, 그 출력물을 제3자에게 제공하지 않는 순수 내부 용도라면 위 별도 계약 조건이 적용되지 않아요.
- 4
파생 모델 재배포 조건 확인
파인튜닝·양자화·증류·병합한 가중치도 파생물이에요. 재배포할 때 라이선스 사본과 변경 표시를 포함해야 하고, 10조를 제거하거나 제한하는 별도 조건을 붙일 수 없어요.
즉, 대부분의 스타트업이나 사내 도구는 바로 쓸 수 있는 구조지만, 대기업 계열사가 범용 모델 API를 외부에 파는 경우는 계약 대상이 될 수 있어요. 문의 창구는 라이선스에 적힌 [email protected]이에요.
쓰기 전 점검 순서
- 용도 정하기: 문서·슬라이드·검색 같은 일상 업무인지, 장기 코딩 에이전트처럼 복잡한 작업인지 구분해요. 후자라면 텐센트도 Hy4를 권해요.
- API로 먼저 시험: OpenRouter에서 자기 업무 샘플 20~30개를 돌려 품질·지연·토큰 사용량을 기록해요. 생각 모드(high)와 no_think 모드를 모두 비교해요.
- 독립 평가 확인: 공식 수치가 내부 평가라는 점을 감안해 외부 리더보드와 커뮤니티 평가를 함께 봐요.
- 데이터 경로 점검: 호스팅 API라면 제공자 국가·로그 정책, 자체 서빙이라면 GPU·호스트 RAM·지원 프레임워크 버전을 확인해요.
- 라이선스 판정: 외부에 범용 API를 제공하는지, 매출·사용자 규모가 기준을 넘는지 문서로 남겨요.
- 버전 고정: llama.cpp PR, Transformers PR, 전용 Docker 이미지처럼 아직 정식 릴리스 전인 구성요소가 많으므로 사용한 커밋·이미지 태그를 기록해요.

Hy4-flash는 총 220B·활성 12B 구조와 1M 컨텍스트, 저렴한 API 가격으로 "충분히 좋은 품질을 싸게"라는 방향을 분명히 한 모델이에요. 다만 공식 성능 근거가 내부 평가에 치우쳐 있고, 로컬 실행 도구는 아직 병합 전 단계이며, 대형 MaaS 사업자에게는 추가 계약 조건이 있어요. API로 작게 시험하고, 독립 평가와 라이선스를 확인한 뒤 확대하는 순서가 가장 안전해요.
자주 묻는 질문
Hy4-flash를 회사 서비스에 무료로 넣어도 되나요?
맥북이나 게이밍 PC에서 Hy4-flash를 돌릴 수 있나요?
Hy4-flash와 Hy4는 무엇이 다른가요?
한국어도 잘하나요?
출처·참고 자료
- 1tencent/Hy4-flash 모델 카드 (Hugging Face)(새 탭에서 열림)huggingface.co
- 2Tencent Hy License 1.0 원문 (Hugging Face)(새 탭에서 열림)huggingface.co
- 3OpenRouter: Tencent Hy4 flash 모델 페이지(새 탭에서 열림)openrouter.ai
- 4AngelSlim/Hy4-flash-GGUF 모델 카드(새 탭에서 열림)huggingface.co
- 5vLLM Recipes: tencent/Hy4-flash(새 탭에서 열림)recipes.vllm.ai
관련 글
 AI
Haru-4B란? 허깅페이스 트렌딩 1위 음성 대화 모델과 로컬 실행 전 확인할 점
허깅페이스 트렌딩 1위에 오른 Haru-4B는 텍스트 소형 LLM이 아니라 전화 통화처럼 듣고 말하기를 동시에 하는 음성 대화 기반 모델이에요. 구조, 로컬 실행 사양, 양자화 버전, 연구용 한계를 공식 자료로 정리했어요.
 AI
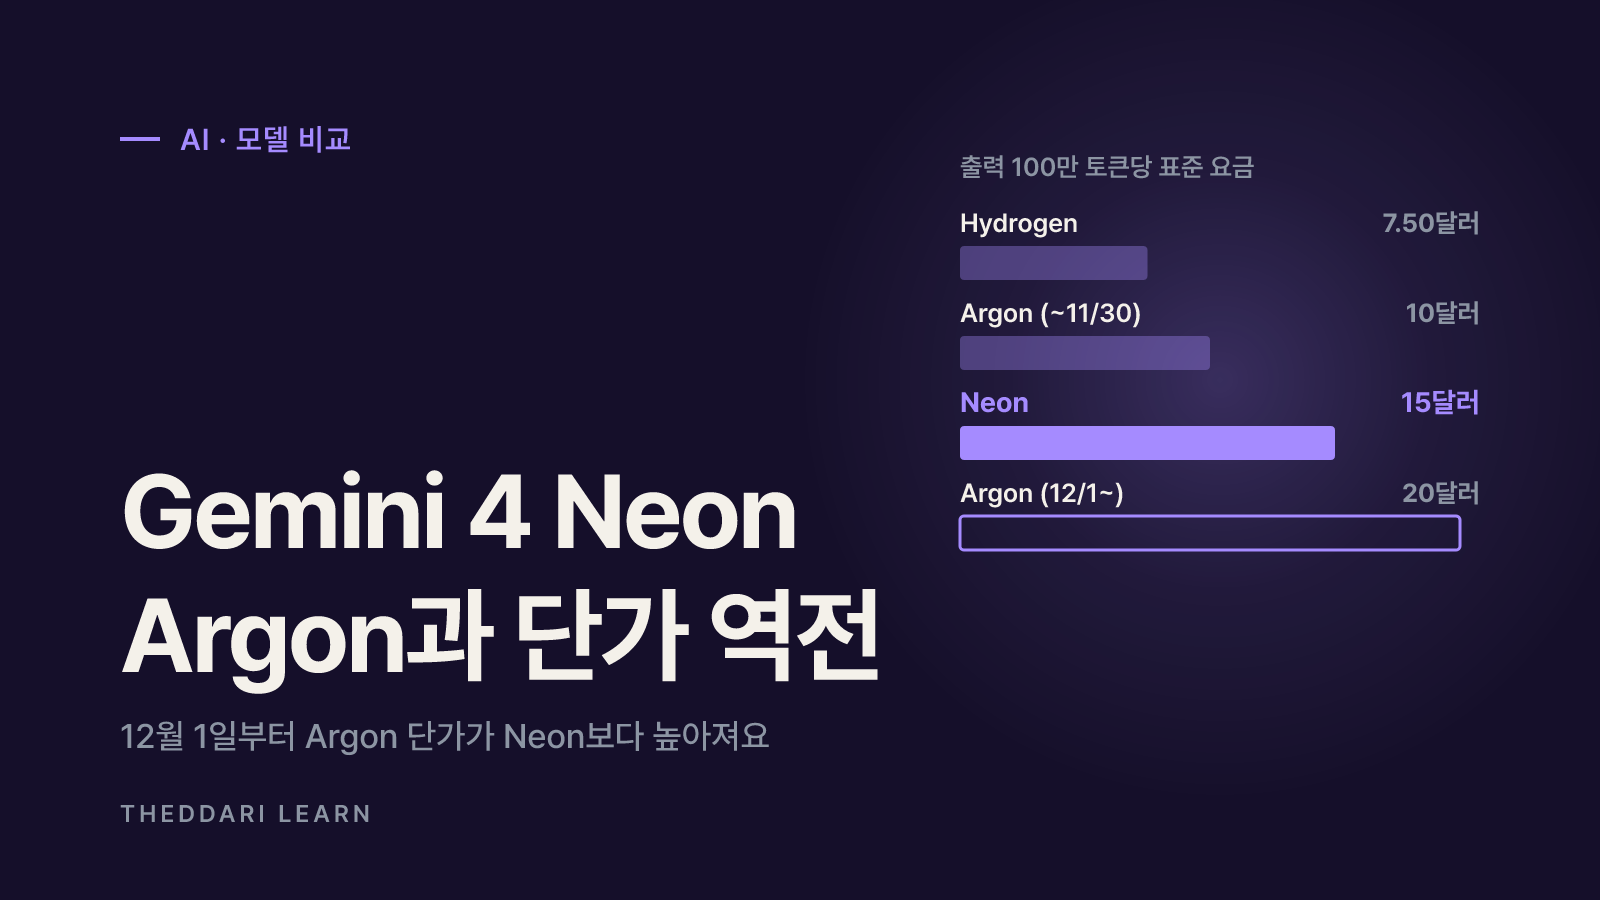
제미나이 네온(Gemini 4 Neon)이란? Hydrogen·Argon 차이와 요금
Gemini 4 Neon은 Carbon과 Hydrogen 사이에서 깊이와 속도를 절충한 구글의 새 모델이에요. 입력 100만 토큰당 3달러·출력 15달러이고 무료 티어가 없어요. Hydrogen·Argon과 요금·성능·이용 범위를 비교하고 쓰기 전 확인할 점을 정리했어요.
 AI
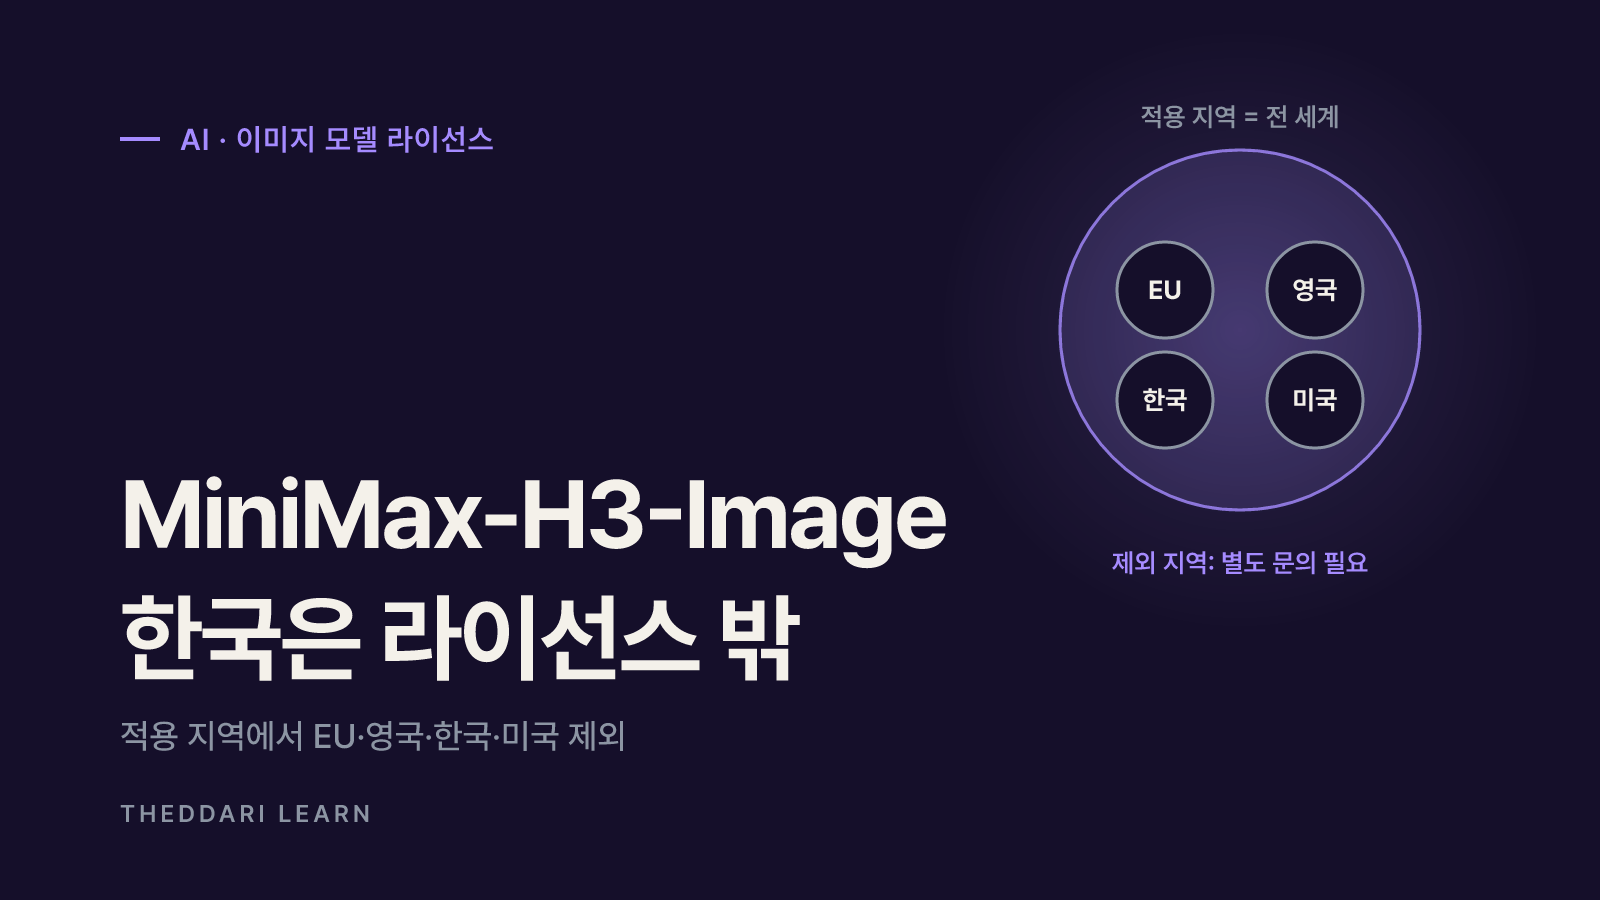
MiniMax-H3-Image란? 특징·ComfyUI 사양·한국 라이선스 제한
허깅페이스 트렌딩 1위 MiniMax-H3-Image를 모델 카드·ComfyUI 공식 문서·라이선스 원문으로 확인했어요. 사양, 원본과 Comfy-Org 배포판의 차이, 설치 순서, 한국·미국·EU·영국이 빠진 적용 지역 조건까지 정리해요.