FP4 양자화란? KV 캐시 4비트로 줄이면 LLM 추론 비용·품질 변화
FP4 양자화로 KV 캐시를 4비트로 줄이면 메모리는 FP8 대비 약 절반이 되지만 품질은 형식·보정·이상치 처리에 따라 달라져요. NVFP4·MXFP4·INT4 차이와 확인할 점을 정리했어요.
목차8개 섹션
핵심 요약
- FP4 양자화는 숫자 하나를 4비트로 저장하는 방식이에요. NVFP4는 16개 값마다 FP8 스케일을 붙여 실제로는 값당 약 4.5비트를 써요.
- KV 캐시를 NVFP4로 저장하면 엔비디아 발표 기준 FP8 KV 캐시보다 메모리가 약 50% 줄어 같은 GPU에 약 2배의 문맥을 담을 수 있어요.
- 품질 손실은 엔비디아 벤치마크에서 1% 미만이었지만, 단순 4비트 변환은 정확도가 크게 떨어질 수 있다는 2026년 11월 논문도 있어요.
- 비용 절감은 긴 문맥·동시 요청이 많은 서빙에서 크고, 블랙웰 같은 FP4 지원 GPU와 추론 엔진 지원이 전제예요.
- 양자화 모델을 고를 때는 형식 이름, 보정 방식, 긴 문맥 평가 결과, 내 작업으로 직접 비교한 결과를 확인해야 해요.
FP4 양자화는 LLM이 다루는 숫자를 16비트나 8비트 대신 4비트로 저장해 메모리와 대역폭을 줄이는 기술이에요. 특히 대화가 길어질수록 커지는 KV 캐시를 4비트로 줄이면, 엔비디아가 공개한 자료 기준 FP8 KV 캐시보다 메모리가 약 50% 줄고 같은 GPU에 약 2배의 문맥을 담을 수 있어요. 대신 품질은 어떤 4비트 형식을 쓰는지, 이상치(outlier)를 어떻게 다루는지에 따라 크게 달라져요. 이 글은 2026년 11월 기준 공개된 논문·공식 문서를 바탕으로 원리, 비용 효과, 품질 위험, 확인할 점을 순서대로 정리해요.
계기는 2026년 11월 6일 arXiv에 올라온 두 논문이에요. BitDecoding-FP4는 KV 캐시를 FP4로 저장한 채 디코딩하는 방법을, CodeQuant2는 긴 추론 과정을 거치는 추론 모델(LRM)을 저정밀로 양자화하는 방법을 다뤄요. 두 논문의 수치는 각자의 실험 조건에서 나온 값이라 그대로 일반화하면 안 된다는 점을 먼저 기억해 두세요.
KV 캐시란? 왜 GPU 메모리를 많이 쓸까
LLM은 토큰을 하나씩 만들어요. 새 토큰을 만들 때마다 앞선 모든 토큰의 키(Key)·값(Value) 벡터를 참고하는데, 이걸 매번 다시 계산하면 낭비가 커요. 그래서 한 번 계산한 키·값을 GPU 메모리에 저장해 두고 다시 꺼내 쓰는데, 이 저장소가 KV 캐시예요. 엔비디아 기술 블로그는 KV 캐시가 계산을 아끼는 대신 메모리 용량과 대역폭이라는 비용을 치른다고 설명해요.
문제는 KV 캐시가 문맥 길이와 동시 요청 수에 비례해 커진다는 점이에요. 메모리 풀이 가득 차면 오래된 문맥을 내보내고(eviction), 나중에 그 부분이 다시 필요하면 다시 계산해야 해요. 그래서 KV 캐시를 작게 만들면 더 긴 문맥, 더 많은 동시 사용자, 더 높은 캐시 적중률을 얻을 수 있어요.
KV 캐시 크기 계산 예시
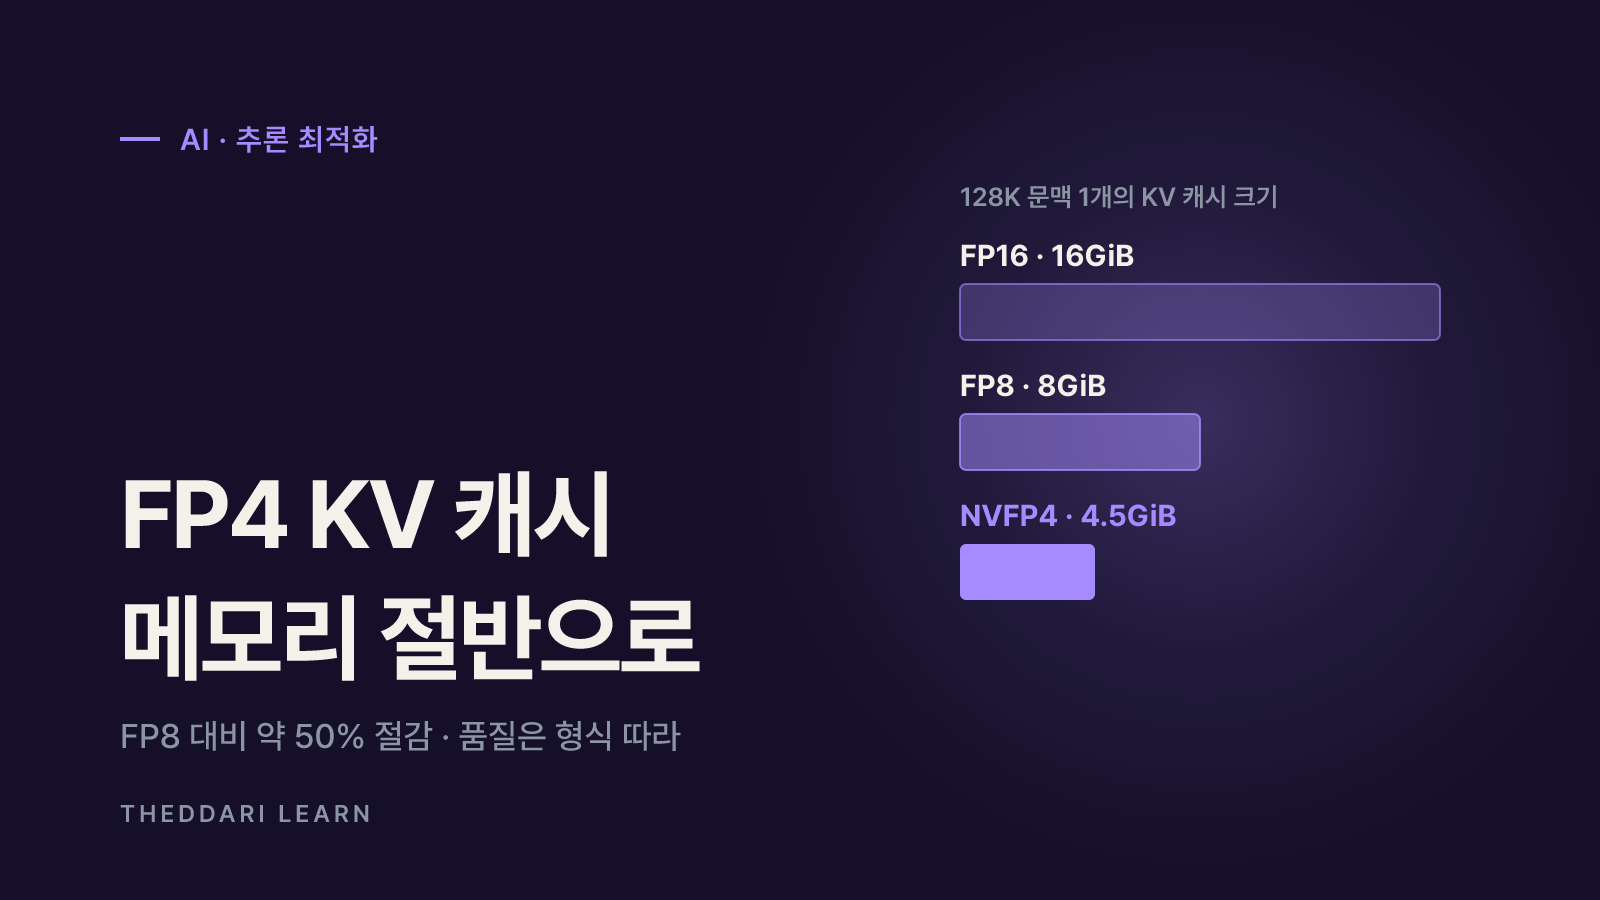
토큰 하나의 KV 캐시 크기는 대략 2(키·값) × 레이어 수 × KV 헤드 수 × 헤드 차원 × 값당 바이트로 계산해요. 레이어 32개, KV 헤드 8개, 헤드 차원 128인 모델을 가정하면 토큰당 값은 65,536개예요. 아래 표는 이 가정 모델에서 131,072토큰(128K) 문맥 하나를 담을 때의 크기로, 실제 모델 구조에 따라 달라지는 계산 예시예요.
FP16·BF16
- 값당 크기
- 2바이트
- 토큰당 크기
- 128KiB
- 128K 문맥 1개
- 16GiB
FP8
- 값당 크기
- 1바이트
- 토큰당 크기
- 64KiB
- 128K 문맥 1개
- 8GiB
NVFP4(스케일 포함)
- 값당 크기
- 0.5625바이트
- 토큰당 크기
- 36KiB
- 128K 문맥 1개
- 4.5GiB
같은 80GB급 GPU라도 KV 캐시에 쓸 수 있는 메모리는 모델 가중치를 올린 뒤 남는 부분뿐이에요. 그래서 문맥 하나가 16GiB에서 4.5GiB로 줄면 동시에 처리할 수 있는 긴 대화 수가 크게 달라져요.
FP4 양자화란? FP16·FP8·NVFP4·MXFP4 형식 비교
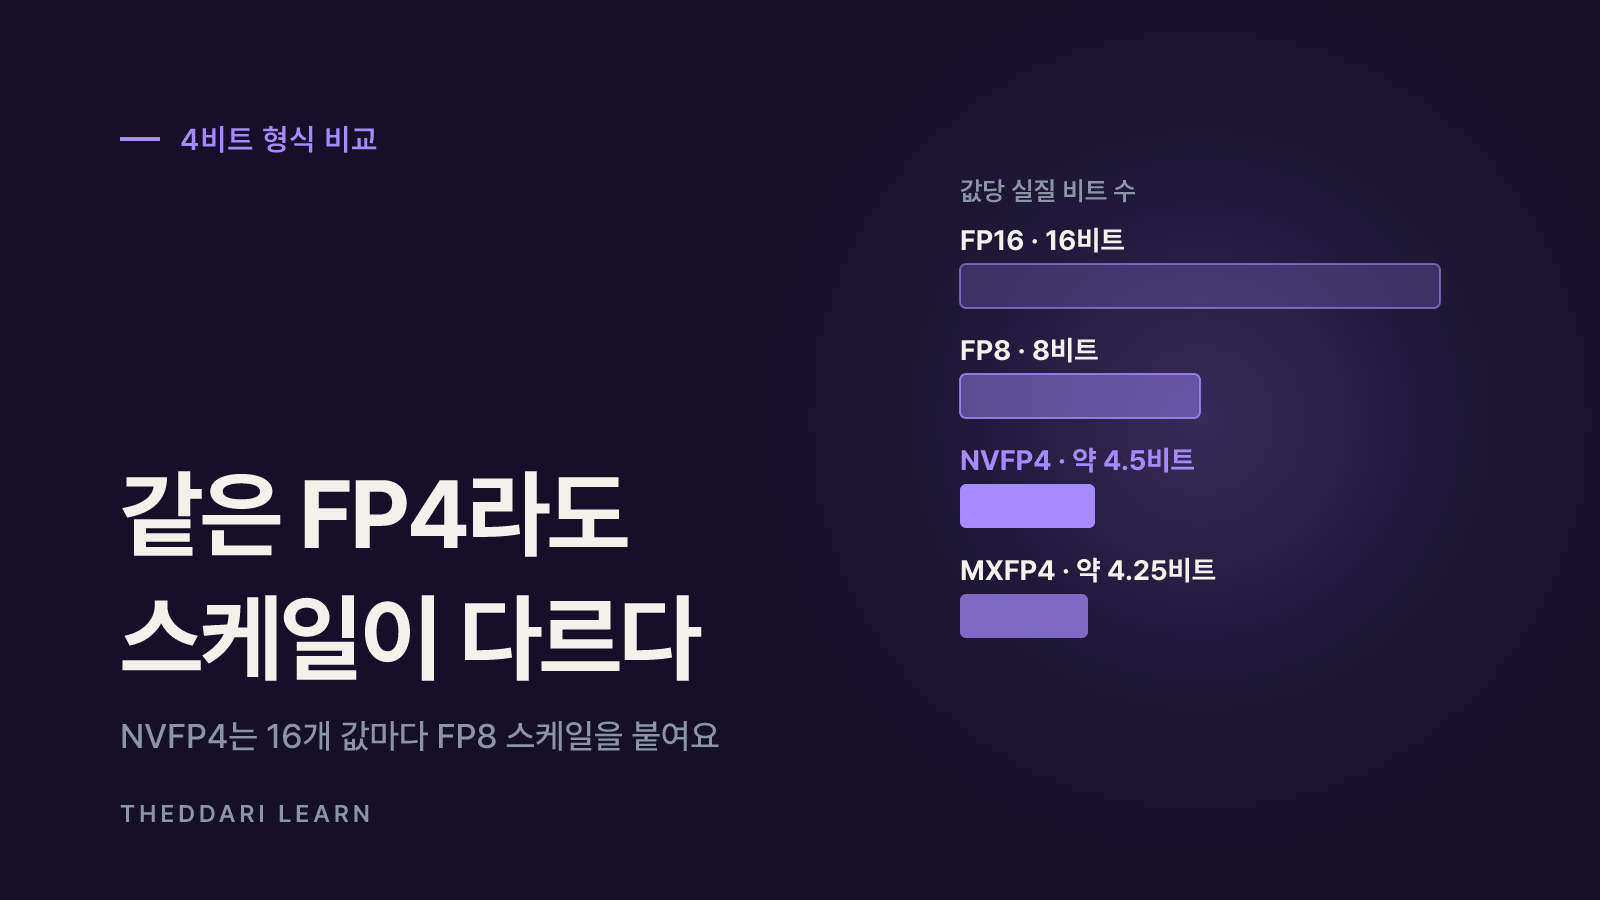
FP4는 4비트 부동소수점이에요. 엔비디아의 NVFP4 소개 글에 따르면 기본 구조는 E2M1, 즉 부호 1비트·지수 2비트·가수 1비트이고 표현 범위는 대략 -6에서 6이에요. 4비트로는 표현할 수 있는 값이 너무 적어서, 여러 값을 묶은 블록마다 스케일(배율)을 따로 저장해 원래 크기를 복원해요. 이 블록 스케일을 어떻게 두느냐가 형식 차이의 핵심이에요.
FP16·BF16
- 구조
- 16비트 부동소수점
- 값당 실질 비트
- 16
- 특징
- 대부분 모델의 기본 KV 정밀도
FP8(E4M3 등)
- 구조
- 8비트 부동소수점
- 값당 실질 비트
- 8
- 특징
- 현재 운영 환경에서 널리 쓰는 KV 압축
MXFP4
- 구조
- FP4 값 + 32개 블록마다 2의 거듭제곱 스케일
- 값당 실질 비트
- 약 4.25
- 특징
- 단순하지만 스케일이 거칠어 오차가 커질 수 있음
NVFP4
- 구조
- FP4 값 + 16개 블록마다 FP8(E4M3) 스케일 + 텐서별 FP32 스케일
- 값당 실질 비트
- 약 4.5
- 특징
- 블록이 작고 스케일이 정밀해 오차가 작음
INT4
- 구조
- 정수 16단계 + 그룹별 스케일
- 값당 실질 비트
- 그룹 크기에 따라 다름
- 특징
- GPU 전용 FP4 연산 경로가 없으면 소프트웨어 복원 필요
엔비디아는 NVFP4가 값 하나에 4비트, 16개 값마다 FP8 스케일 하나를 붙여 값당 약 4.5비트를 쓰고, 그 결과 FP16보다 약 3.5배, FP8보다 약 1.8배 메모리를 줄인다고 설명해요. TensorRT LLM 기술 블로그도 NVFP4 페이지가 값당 0.5625바이트로 FP16·BF16의 2바이트, FP8의 1바이트보다 작다고 정리해요. MXFP4의 4.25비트는 32개 값마다 8비트 스케일 하나를 붙인다는 구조에서 계산한 값이에요.
이름에 FP4가 들어가도 같은 형식이 아닐 수 있어요. 모델 카드나 서빙 설정에서 NVFP4인지, MXFP4인지, 그룹 크기는 얼마인지까지 확인해야 품질 차이를 예측할 수 있어요.
KV 캐시를 4비트로 줄이면 AI 추론 비용은 어떻게 달라질까
비용 효과는 세 갈래로 나타나요. 첫째는 메모리 용량이에요. 엔비디아는 NVFP4 KV 캐시가 FP8 KV 캐시보다 메모리를 약 50% 줄여 문맥 예산을 사실상 2배로 늘린다고 밝혔어요. 둘째는 메모리 대역폭이에요. 토큰을 하나씩 만드는 디코딩 단계는 KV 캐시를 반복해서 읽기 때문에, 캐시가 작으면 읽어야 할 데이터도 줄어요. 셋째는 캐시 적중률이에요. 더 많은 문맥이 GPU에 남아 있으면 다시 계산할 일이 줄어 첫 토큰까지 걸리는 시간(TTFT)이 짧아져요.
- 엔비디아 측정(Qwen3-Coder-480B-A35B): FP8 대비 TTFT 최대 3배 개선, 캐시 적중률 최대 20% 상승. 캐시 메모리가 충분히 커지면 차이가 줄어드는 정체 구간이 있다고 함께 밝혔어요.
- BitDecoding-FP4 논문(NVIDIA B300, Qwen3-4B·Qwen3-30B-A3B): BF16 KV 캐시 대비 최대 서빙 처리량 2.4~3.0배.
- TensorRT LLM의 NVFP4 콜드 페이지 압축: GPU 밖(호스트·디스크)으로 내보낸 KV 페이지만 NVFP4로 저장해 에이전트 작업 재현 실험에서 최대 1.64배 많은 요청을 처리하고 TTFT를 최대 1.9배 낮췄어요.
이 수치들은 모두 서로 다른 모델·GPU·작업에서 나온 최대값이에요. 짧은 질문 위주로 동시 요청이 적은 서비스라면 KV 캐시가 병목이 아니라서 체감 효과가 작을 수 있어요. 반대로 긴 문서 분석, 코딩 에이전트처럼 문맥이 길고 같은 접두부를 반복해서 쓰는 작업일수록 효과가 커요. 또 엔비디아의 현재 구현은 저장만 NVFP4로 하고 어텐션 계산 전에 FP8로 복원하므로, 연산량 자체가 4분의 1이 되는 것은 아니에요.
AI 서비스 요금이나 GPU 공급 이슈가 시장에서 어떻게 이야기되는지는 더따리 AI 텔레그램 트렌드에서 흐름을 함께 볼 수 있어요.

품질은 얼마나 떨어질까? 이상치와 오차가 생기는 지점
엔비디아는 Qwen3-480B-A35B에서 NVFP4 KV 캐시의 정확도 손실이 BF16·FP8 대비 1% 미만이었다고 밝혔어요. 예를 들어 MMLU-PRO는 FP16 약 78.2%, FP8 약 78.1%, NVFP4 약 77.4%였고, 64K 토큰 긴 문맥 평가인 Ruler 64K는 약 95.6%, 95.5%, 94.6%였어요. 반면 Llama 3.3 70B의 MMLU에서는 NVFP4 약 81.9%, MXFP4 약 77.8%로 같은 4비트라도 형식에 따라 약 5% 차이가 났어요.
주의할 점은 이 결과가 잘 설계된 형식과 보정을 전제로 한다는 거예요. BitDecoding-FP4 논문은 기존 FP4 KV 시스템이 단순한(vanilla) 양자화를 써서 정확도가 크게 떨어진다고 지적하고, 오차의 원인을 세 가지로 나눠요.
- 쿼리 쪽 오차: 쿼리를 FP4 텐서 두 개로 나누는 방식으로 쿼리 로짓 오차를 60%에서 1%로 줄였다고 보고해요.
- 확률 언더플로: 문맥이 길어지면 어텐션 확률이 아주 작아지는데, E4M3 스케일이 이를 0으로 반올림하는 문제가 생겨요.
- 키 이상치: 키 벡터의 일부 채널에 유난히 큰 값이 몰리면 블록 스케일이 그 값에 맞춰져 나머지 값의 정밀도가 무너져요. 논문은 정적 스무딩·하다마드 회전·스케일 탐색을 함께 써서 억제했어요.
이렇게 보완한 결과 BitDecoding-FP4는 NVFP4에서 BF16 KV 대비 0.5점 이내, MXFP4에서 1점 이내의 정확도를 유지했다고 보고해요. CodeQuant2 논문은 KV 캐시가 아니라 가중치·활성화 양자화를 다루지만 비슷한 경고를 해요. 추론 모델은 디코딩 초반 단계에서 활성화 값의 변동이 커서, 이 구간을 빼고 보정 데이터를 고르면 이상치를 놓칠 수 있다는 거예요. 이 논문은 회전·스케일링과 클러스터링 기반 룩업 테이블로 BF16 대비 최대 2.85배 속도를 보고했어요.
벤치마크 1% 미만 손실은 평균값이에요. 수학 풀이나 코드 생성처럼 작은 오차가 연쇄적으로 커지는 작업, 64K 토큰을 넘는 아주 긴 문맥, 특정 언어 데이터에서는 차이가 더 클 수 있으니 내 작업으로 직접 비교해야 해요.
LLM 양자화 설정을 고를 때 확인할 점
- 1
하드웨어 지원 확인
NVFP4는 블랙웰 아키텍처에서 하드웨어 가속이 돼요. 이전 세대 GPU에서는 FP8 KV 캐시가 현실적인 선택일 수 있어요.
- 2
엔진 옵션과 보정 방식 확인
vLLM 문서에 따르면 FP8 KV 캐시를 보정 없이 켜면 모든 스케일이 1.0으로 설정되고, 권장 방식은 llm-compressor로 데이터셋 보정을 하는 거예요. 4비트도 보정 여부가 품질을 크게 바꿔요.
- 3
민감한 레이어는 제외
vLLM은 슬라이딩 윈도 어텐션 같은 일부 레이어가 KV 양자화에 더 민감하다며 해당 레이어만 원래 정밀도로 두는 옵션을 제공해요.
- 4
긴 문맥·추론 작업으로 평가
짧은 상식 문항보다 실제 서비스 길이의 문서, 다단계 추론, 코드 생성 문항으로 BF16·FP8·FP4 결과를 나란히 비교해요.
- 5
처리량과 지연을 함께 측정
동시 요청 수, 평균 문맥 길이, TTFT, 초당 토큰 수를 같은 조건에서 측정해야 절감 효과를 정확히 계산할 수 있어요.
새 양자화 논문이나 모델 공개 소식은 빠르게 쏟아지지만 실제 적용 범위는 제한적인 경우가 많아요. 더따리 블로그 트렌드에서 국내 개발자들이 어떤 양자화 경험을 공유하는지 함께 살펴보면 도입 전 시행착오를 줄일 수 있어요.
정리: 4비트 KV 캐시는 언제 의미가 있을까
- 긴 문맥·많은 동시 요청·반복 접두부가 있는 서빙이라면 FP8에서 NVFP4로 가는 효과가 커요.
- 품질은 형식(NVFP4·MXFP4·INT4), 블록 크기, 보정 데이터, 이상치 처리에 따라 달라져요. 이름만 보고 판단하지 마세요.
- 논문 수치는 특정 모델·GPU에서의 최대값이에요. 내 작업으로 BF16·FP8과 나란히 비교한 결과가 가장 확실한 근거예요.
- GPU 밖으로 내보내는 KV 페이지만 압축하는 콜드 페이지 방식처럼, 품질 위험을 줄이면서 비용을 아끼는 절충안도 있어요.