DeepSeek V4.1 Flash 1017이란? 특징과 API·로컬 사용 전 확인할 점
DeepSeek V4.1 Flash 1017의 공개 사양(MIT 라이선스·1M 컨텍스트·763B 파라미터), 이전 버전 대비 변경점, 공식 API·OpenRouter 요금과 로컬 실행 전 확인할 점을 정리했어요.
목차7개 섹션
핵심 요약
- DeepSeek V4.1 Flash 1017은 2026년 9월 10일 나온 V4.1 Flash의 '마이너 업데이트'로, 2026년 10월 17일 웹·앱·API에 동시에 반영되고 가중치가 MIT 라이선스로 공개됐어요.
- 공식 API에서는 모델 이름 deepseek-flash가 이 버전을 가리키며, 컨텍스트 1M 토큰·최대 출력 384K 토큰, 비전·도구 호출·JSON 출력을 지원해요.
- 공식 요금은 100만 토큰당 입력(캐시 미스) $0.15·출력 $0.6(오프피크)이고, 피크 시간에는 두 배예요. 한국 시간 평일 10~13시, 15~19시가 피크에 해당해요.
- 허깅페이스 메타데이터 기준 763B 파라미터 규모라 개인 PC에서 원본 그대로 돌리기는 현실적이지 않고, Jinja 채팅 템플릿도 없어 전용 인코딩 코드를 써야 해요.
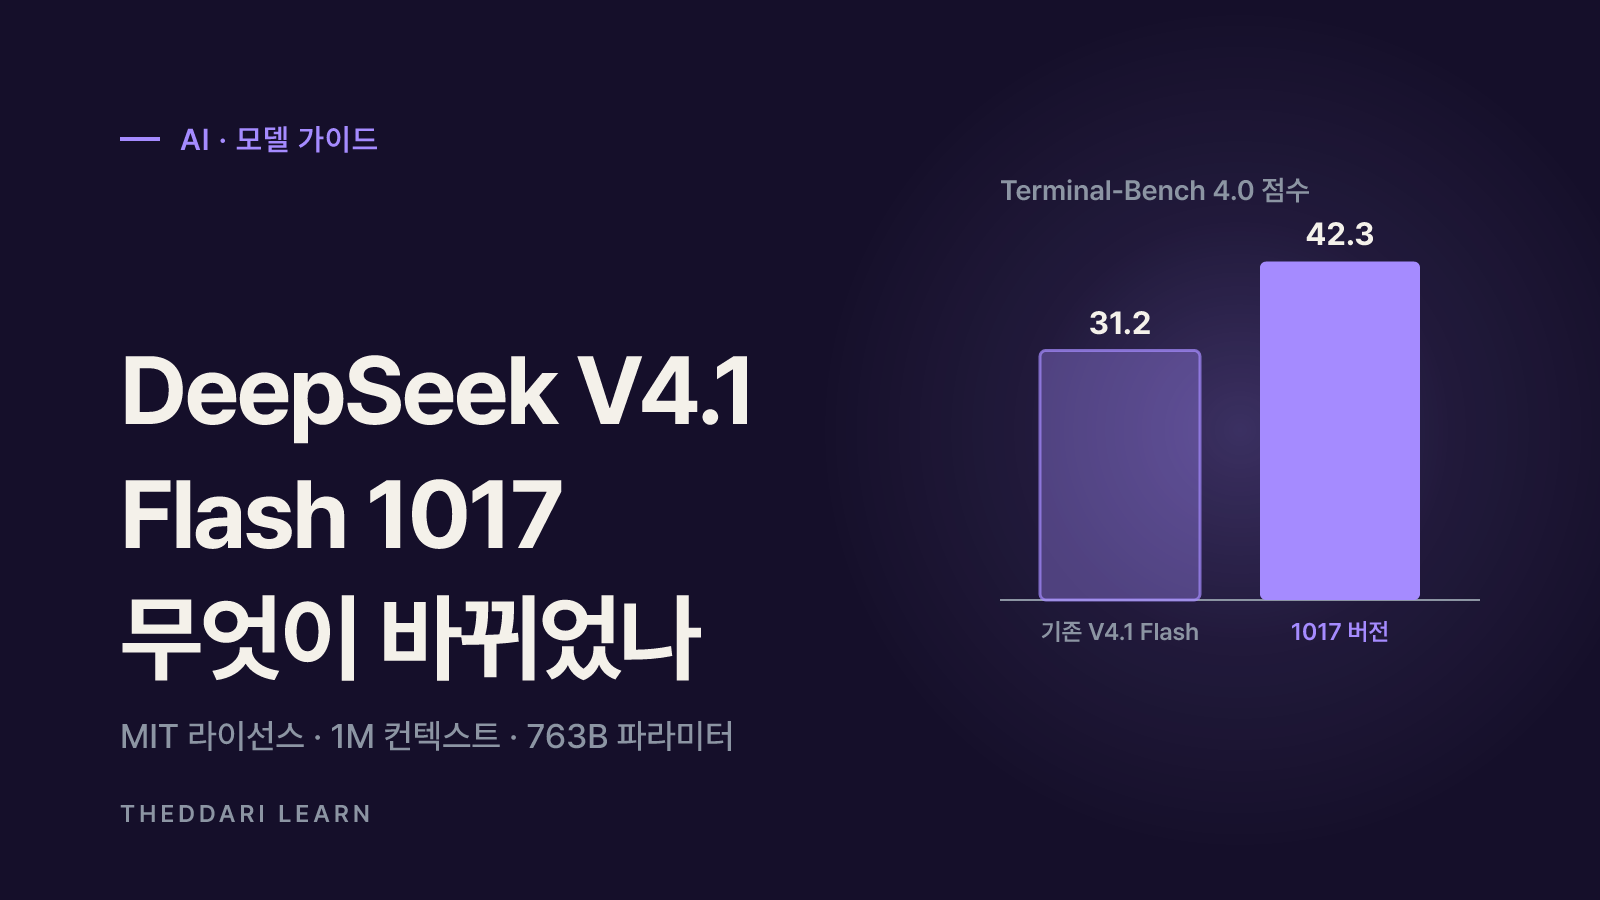
- 벤치마크 향상폭(예: Terminal-Bench 4.0 31.2→42.3)은 DeepSeek가 직접 낸 수치라 내 작업으로 따로 검증해야 해요.
DeepSeek V4.1 Flash 1017은 DeepSeek가 2026년 10월 17일 공개한 V4.1 Flash의 업데이트 체크포인트예요. 회사는 이를 '마이너 업데이트'라고 부르지만, 자체 벤치마크에서는 코딩·에이전트 작업 점수가 크게 올랐고 같은 날 웹·앱·API 기본 모델이 이 버전으로 바뀌었어요. 가중치는 허깅페이스에 MIT 라이선스로 올라와 있어요. 이 글은 2026년 10월 기준 공식 모델 카드와 API 문서를 직접 확인해, 어떤 모델인지와 API·로컬로 쓰기 전에 무엇을 따져야 하는지 정리했어요.
결론부터 말하면, 대부분의 개인·소규모 팀에게는 공식 API나 OpenRouter로 먼저 써 보는 것이 현실적이에요. 원본 모델이 763B 파라미터 규모라 로컬 실행은 다중 GPU 서버가 있는 경우에만 고려할 만하고, 벤치마크 향상폭은 DeepSeek 자체 발표 수치라 내 작업으로 검증하는 단계가 꼭 필요해요.
DeepSeek V4.1 Flash 1017이란? 공개 사양 한눈에 보기
이름의 '1017'은 공개일(10월 17일)을 뜻하는 날짜 접미사예요. 원래 V4.1 Flash는 2026년 9월 10일 출시됐고, 1017은 같은 계열을 다시 학습·조정한 체크포인트예요. 모델 카드는 추론·코딩·에이전트·비전 벤치마크가 개선됐고, 작업 실행 시간과 출력 길이가 줄어 더 빠르고 저렴하게 끝낼 수 있다고 설명해요.
| 항목 | 모델 카드·공식 문서에서 확인한 내용 |
|---|---|
| 공개일 | 2026년 10월 17일 (웹·앱·API 동시 반영) |
| 라이선스 | MIT (저장소와 모델 가중치 모두) |
| 모델 크기 | 허깅페이스 Safetensors 메타데이터 763B 파라미터 |
| 텐서 형식 | BF16·F32·F8_E4M3·I8 혼합 |
| 입력·출력 | 이미지·텍스트 입력, 텍스트 출력 (Image-Text-to-Text) |
| 컨텍스트 | 1M 토큰, 권장 max_tokens 256K 이상 |
| 권장 샘플링 | temperature 1.0, top_p 1.0 |
| 채팅 템플릿 | Jinja 템플릿 없음, encoding 폴더의 Python 참조 구현 사용 |
파라미터 수가 두 개로 보이는 이유
원본 V4.1 Flash 모델 카드는 552B 백본 파라미터에 별도의 196B Engram 조건부 메모리를 둔 MoE(전문가 혼합) 구조라고 설명해요. 토큰마다 실제로 쓰는 파라미터는 프리필(입력 처리) 때 8B, 디코드(생성) 때 16B뿐이에요. 허깅페이스 메타데이터의 763B는 이런 부가 구성 요소까지 포함한 저장 파일 기준 숫자로 보이며, 1017 카드는 활성 파라미터나 구조 변경 여부를 따로 밝히지 않았어요. 그래서 '552B 모델'과 '763B 모델'이라는 설명이 함께 돌아다니는데, 로컬 메모리 계산에는 실제로 내려받는 파일 크기를 기준으로 삼는 편이 안전해요.
구조적 특징: 긴 컨텍스트를 싸게 처리
V4.1 계열의 핵심은 KV 캐시 압축이에요. 원본 카드에 따르면 20층 인코더와 20층 디코더로 나뉜 Causal Encoder-Decoder 구조, Compressed Sparse Attention 2, FP4 KV 캐시를 조합해 토큰당 전역 KV 캐시를 약 890바이트로 줄였고, 이는 이전 V4 Flash의 약 4분의 1이라고 해요. 1M 토큰 컨텍스트를 저렴하게 서비스할 수 있는 이유가 여기에 있어요. 추론 노력(reasoning effort)을 1~100 정수로 조절해 비용과 정확도를 맞바꿀 수 있다는 점도 특징이에요.
이전 V4.1 Flash와 무엇이 달라졌나
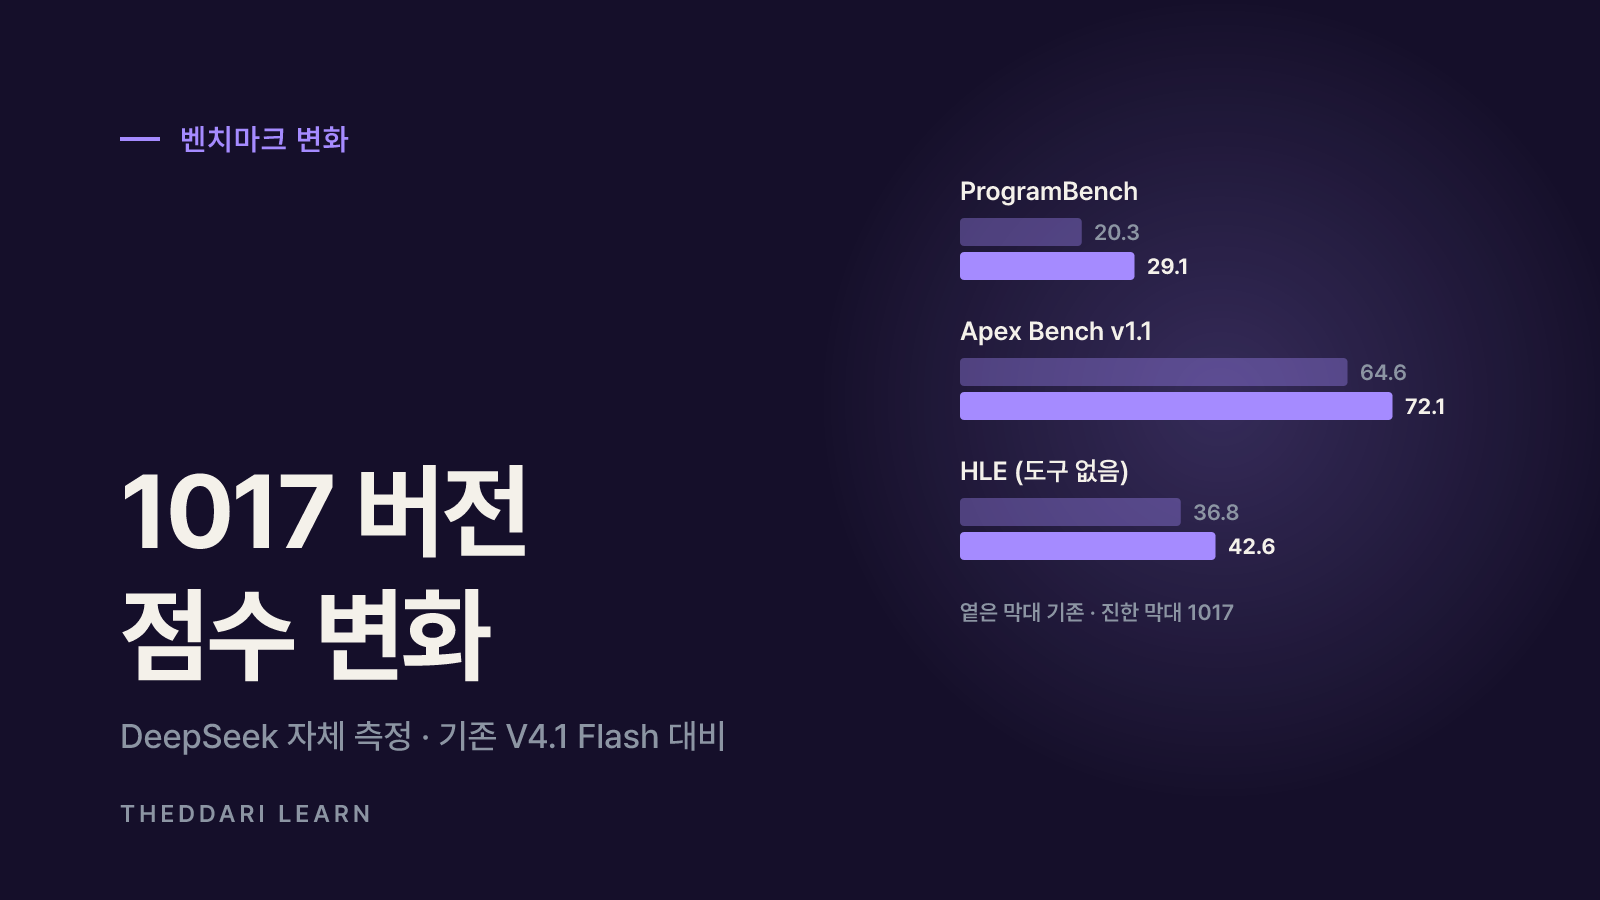
1017 모델 카드의 표는 같은 기준으로 이전 V4.1 Flash와 비교한 점수를 보여 줘요. 특히 터미널 작업과 코드 생성 계열이 크게 올랐어요.
Terminal-Bench 4.0
- V4.1 Flash
- 31.2
- V4.1 Flash 1017
- 42.3
- 변화
- +11.1
HLE (도구 없음)
- V4.1 Flash
- 36.8
- V4.1 Flash 1017
- 42.6
- 변화
- +5.8
DeepSWE v1.1
- V4.1 Flash
- 74.2
- V4.1 Flash 1017
- 77.0
- 변화
- +2.8
ProgramBench
- V4.1 Flash
- 20.3
- V4.1 Flash 1017
- 29.1
- 변화
- +8.8
Apex Bench v1.1
- V4.1 Flash
- 64.6
- V4.1 Flash 1017
- 72.1
- 변화
- +7.5
Automation-Bench
- V4.1 Flash
- 54.8
- V4.1 Flash 1017
- 60.5
- 변화
- +5.7
Agents' Last Exam
- V4.1 Flash
- 31.8
- V4.1 Flash 1017
- 35.4
- 변화
- +3.6
표의 수치는 모두 DeepSeek가 직접 측정해 발표한 값이에요. 모델 카드에 따르면 Terminal-Bench 4.0은 Claude Code 하네스, DeepSWE v1.1은 Mini-SWE-V2 하네스로 측정했어요. 같은 모델도 어떤 에이전트 도구로 돌리느냐에 따라 점수가 달라지는데, 원본 V4.1 Flash 카드에서도 DeepSWE 점수가 하네스별로 65.5~74.2로 벌어졌어요. 내가 쓰는 도구에서 같은 개선이 나온다고 가정하지 마세요.
DeepSeek 발표문은 이 버전이 DeepSeek Harness, Tencent CodeBuddy, WorkBuddy 등에 맞춰 최적화됐다며 DeepSeek Harness는 v0.2.1-rc.1 이상으로 올리라고 안내해요. 다른 코딩 에이전트에서는 체감 차이가 다를 수 있어요.
API로 쓰기: 딥시크 공식 API와 OpenRouter
공식 API에서 바뀐 점
DeepSeek API 문서에서 모델 이름 deepseek-flash의 버전은 DeepSeek-V4.1-Flash-1017로 표시돼요. OpenAI 형식 기본 URL은 https://api.deepseek.com, Anthropic 형식은 https://api.deepseek.com/anthropic이에요. 생각(thinking) 모드가 기본이고 비생각 모드로 바꿀 수 있으며, JSON 출력·도구 호출·Responses API·Anthropic API·비전 입력을 지원해요. FIM 완성은 비생각 모드에서만 돼요. 컨텍스트는 1M 토큰, 최대 출력은 384K 토큰이에요.
주의할 점은 이름이 그대로인데 모델이 바뀌었다는 거예요. 예전 이름 deepseek-v4-flash, deepseek-v4-flash-vision-exp도 아직 받지만 해당 모델은 은퇴했고, 요청은 1017 체크포인트가 처리해요. 운영 중인 서비스라면 프롬프트·출력 형식 회귀 테스트를 다시 돌려 보세요.
입력 (캐시 히트)
- 오프피크
- $0.003
- 피크
- $0.006
입력 (캐시 미스)
- 오프피크
- $0.15
- 피크
- $0.3
출력
- 오프피크
- $0.6
- 피크
- $1.2
피크 시간은 월~금 UTC 01:00~04:00, 06:00~10:00이에요(중국 공휴일 제외). 한국 시간으로는 평일 오전 10시~오후 1시, 오후 3시~7시라 국내 업무 시간과 상당 부분 겹쳐요. 배치 작업을 저녁이나 주말로 옮기면 같은 작업을 절반 가격에 처리할 수 있어요. 동시 요청 한도는 2,500으로 안내돼 있어요. 같은 날 공개된 Search·Fetch API는 각각 1,000회 성공 요청당 $0.75이고, DeepSeek Harness·Claude Code·Codex에서 서버 측 도구로 호출되는 검색은 2026년 10월 31일 16:00 UTC(한국 시간 11월 1일 오전 1시)부터 과금돼요.
OpenRouter로 쓰는 법
OpenRouter에서는 모델 ID deepseek/deepseek-v4.1-flash-1017로 https://openrouter.ai/api/v1/chat/completions 에 요청해요. 날짜가 붙은 ID라 특정 체크포인트를 명시할 수 있고, reasoning·tools·response_format 같은 파라미터를 받는다고 안내돼 있어요. 다만 2026년 10월 기준 EU 지역 내 라우팅은 지원하지 않고, 실제 처리 공급자에 따라 가격·속도가 달라질 수 있으니 호출 전 모델 페이지에서 확인하세요.
- 1
키 발급과 지출 한도
공식 플랫폼이나 OpenRouter에서 API 키를 만들고, 먼저 충전 금액·지출 한도를 작게 설정해요. 1M 컨텍스트에 긴 출력이 겹치면 한 번 호출 비용이 예상보다 커질 수 있어요.
- 2
모델 이름 고정 여부 결정
자동 업데이트를 원하면 deepseek-flash, 특정 버전을 고정하고 싶으면 OpenRouter의 날짜 ID처럼 버전이 명시된 경로를 써요.
- 3
샘플 작업으로 비교
평소 쓰는 프롬프트 20~30개를 이전 모델 결과와 비교해 정확도·출력 길이·도구 호출 형식을 확인해요.
- 4
데이터 정책 확인
회사 코드나 개인정보를 보내기 전에 공급자의 데이터 보관·학습 사용 정책과 사내 보안 규정을 확인해요.
딥시크 로컬 실행 전 확인할 점
가중치가 공개됐다고 해서 누구나 내 컴퓨터에서 돌릴 수 있는 건 아니에요. 확인해야 할 조건을 정리하면 다음과 같아요.
- 메모리 규모: 763B 파라미터를 8비트로만 계산해도 수백 GB가 필요해요. 다중 데이터센터 GPU 서버가 전제이며, 맥북·단일 게이밍 GPU로는 원본 실행이 어려워요.
- 런타임 지원: 허깅페이스는 vLLM·SGLang 서빙 예시를 보여 주지만, 실제 가중치 변환·추론 절차는 저장소의 inference 폴더 안내를 따라야 해요. 새 아키텍처라 사용 중인 런타임 버전이 지원하는지 먼저 확인하세요.
- 채팅 템플릿 없음: Jinja 형식 템플릿이 없어서 일반적인 apply_chat_template 흐름이 그대로 맞지 않을 수 있어요. 저장소의 encoding.py나 DeepSeek가 공개한 deepseek-recipe 라이브러리로 프롬프트를 만들어야 도구 호출·생각 모드가 제대로 동작해요.
- 긴 출력 설정: 권장 max_tokens가 256K 이상이라 서버 메모리와 타임아웃을 넉넉히 잡아야 해요. 짧게 자르면 생각 모드 답변이 중간에 끊길 수 있어요.
- 양자화 버전: 커뮤니티 양자화 모델이 여럿 올라와 있지만 DeepSeek 공식 배포가 아니에요. 제작자, 품질 저하 정도, llama.cpp·Ollama 등 런타임 지원 여부를 따로 확인하세요.
- 호스팅 상태: 2026년 10월 확인 시점에 허깅페이스 Inference Provider 중 이 모델을 배포한 곳은 없다고 표시돼 있었어요.
허깅페이스 모델 이름의 GGUF·양자화 표기가 낯설다면, 양자화 파일을 고르기 전에 표기 규칙을 먼저 익혀 두면 잘못된 파일을 받는 실수를 줄일 수 있어요.
쓰기 전에 따져 볼 위험과 한계
- 자체 발표 벤치마크: 모든 점수는 DeepSeek 측정값이고 독립 재현이 아직 충분하지 않아요. 표의 비교 모델 점수도 같은 조건인지 확인이 어려워요.
- 조용한 모델 교체: deepseek-flash 같은 별칭은 앞으로도 예고 후 바뀔 수 있어요. 결과가 갑자기 달라지면 모델 버전부터 확인하세요.
- 비용 변수: 출력 길이가 줄었다는 설명이 있어도, 1M 컨텍스트와 생각 모드를 함께 쓰면 비용이 빠르게 늘어요. 피크·오프피크 차이도 두 배예요.
- 데이터·규제: DeepSeek 공식 API를 쓰면 데이터가 해당 회사 인프라에서 처리돼요. 소속 기관에 특정 AI 서비스 사용 제한이 있는지, 개인정보 처리 근거가 있는지 확인하세요. 오픈 가중치를 자체 서버에서 돌리면 이 문제를 줄일 수 있지만 운영 비용이 늘어요.
- 가격 변경 가능성: 공식 문서도 가격이 바뀔 수 있다고 명시해요. 이 글의 요금은 2026년 10월 확인 기준이에요.
새 모델 소식은 하루에도 여러 번 바뀌어요. AI 커뮤니티에서 실제 사용 후기와 장애 소식을 빠르게 확인하려면 아래 텔레그램 AI 채널 모음과 블로그 대시보드를 함께 보면 도움이 돼요.

정리하면, DeepSeek V4.1 Flash 1017은 MIT 라이선스와 1M 컨텍스트, 낮은 API 단가를 갖춘 업데이트예요. 먼저 오프피크 시간에 API로 내 작업을 시험하고, 이전 버전과 결과를 비교한 뒤, 데이터 정책과 로컬 운영 비용까지 따져서 도입 범위를 정하는 순서가 안전해요.
자주 묻는 질문
DeepSeek V4.1 Flash 1017은 무료로 쓸 수 있나요?
deepseek-flash와 deepseek-v4-flash는 같은 모델인가요?
맥북이나 게이밍 PC에서 로컬로 돌릴 수 있나요?
OpenRouter로 쓰면 공식 API와 무엇이 다른가요?
출처·참고 자료
- 1