자동 연구 AI는 어디까지 왔나? Auto-Research Arena 벤치마크 결과 읽기
Auto-Research Arena 논문으로 자동 연구 AI 수준을 정리했어요. 9개 목표·7개 하네스 비교, 단순 순차 탐색이 2위를 한 의미, 재현성·사람 개입 확인법까지 담았어요.
목차9개 섹션
핵심 요약
- 자동 연구 AI는 제한된 실험 환경 안에서는 스스로 가설을 세우고 실험·수정을 반복할 수 있지만, 목표·제약·평가 기준은 여전히 사람이 정해요.
- Auto-Research Arena는 언어 모델 사전학습 코드를 대상으로 9개 효율 목표, 7개 연구 하네스, 2개 기반 모델(Claude Opus 5, GPT-6 Astra)을 비교했어요.
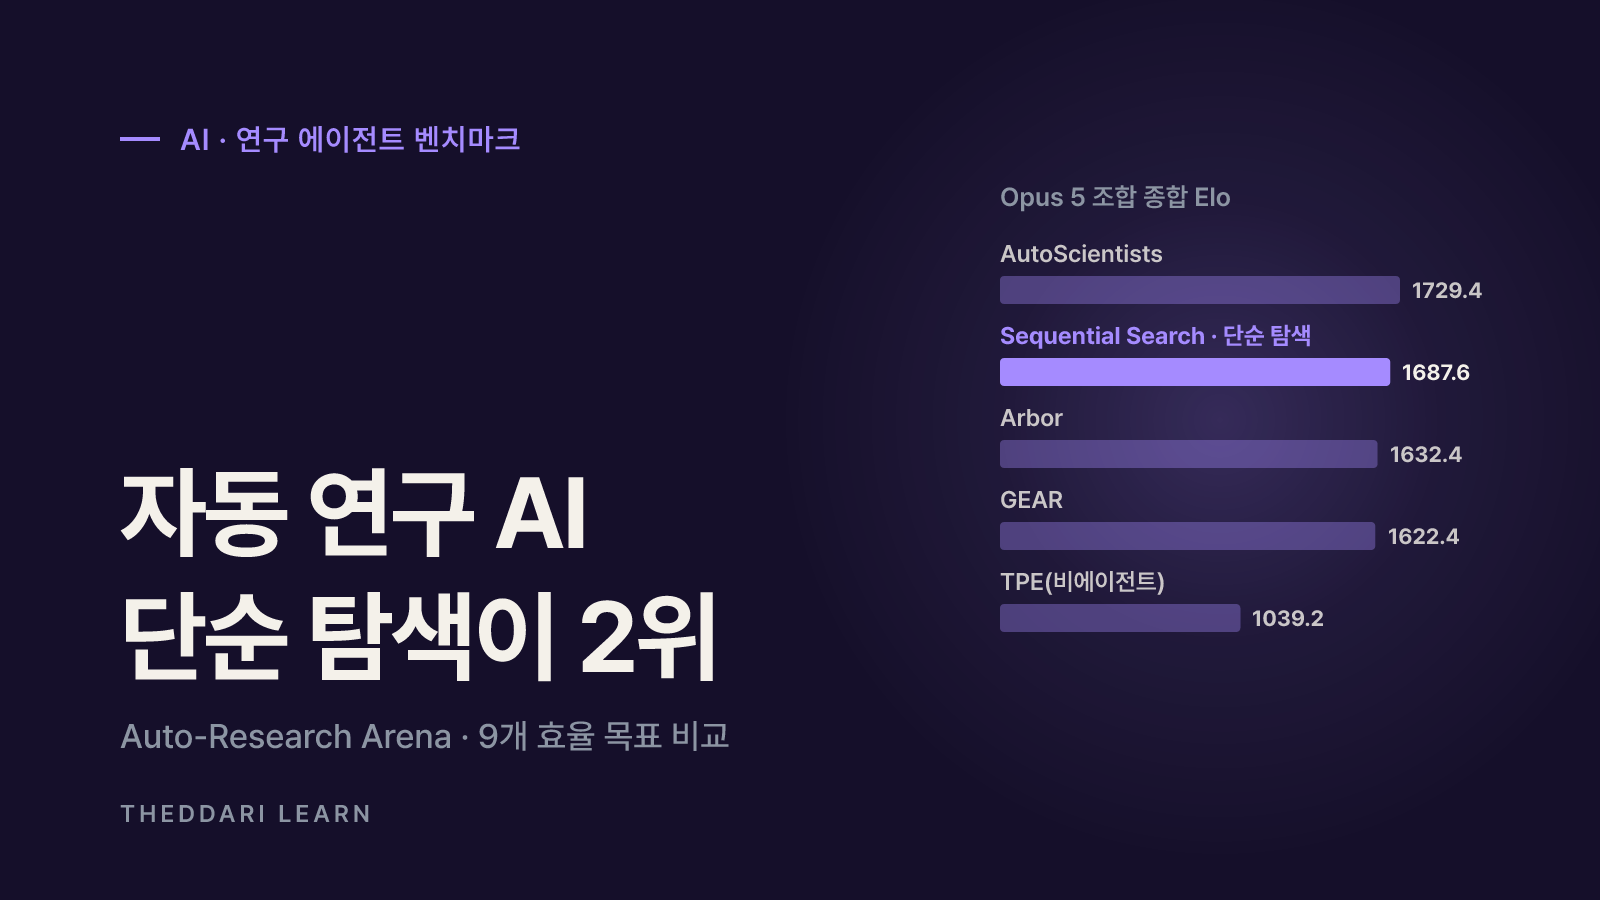
- 눈에 띄는 결과는 한 번에 하나씩 고쳐 보는 단순한 순차 탐색(Sequential Search)이 두 모델 모두에서 종합 2위를 한 점이에요. 복잡한 설계가 아직 성과로 꾸준히 이어지지 않는다는 뜻이에요.
- 에이전트가 찾은 아이디어를 모아 1시간 학습에 다시 쓰자 학습 손실이 2.675에서 2.544로 낮아졌지만, 작은 모델·단일 시드·동료 평가 전 논문이라는 한계가 있어요.
- 자동 연구 주장을 볼 때는 과제 범위, 사람 개입 정도, 실험 예산, 재현 가능한 코드 공개 여부를 먼저 확인하는 게 좋아요.
자동 연구 AI는 '정해진 실험 환경 안에서 가설을 세우고, 코드를 고치고, 결과를 보고 다음 시도를 고르는 일'까지는 이미 꽤 해내요. 하지만 무엇을 연구할지, 어떤 결과를 합격으로 볼지는 여전히 사람이 정해요. 2026년 10월 26일 arXiv에 올라온 Auto-Research Arena 논문은 이 경계를 숫자로 보여 주는 벤치마크예요. 이 글은 2026년 10월 기준 논문 v1과 공개 코드를 직접 읽고, 무엇을 측정했는지, 결과가 무엇을 말하는지, 어디까지 믿어야 하는지를 정리했어요.
자동 연구 AI란? Auto-Research Arena가 던진 질문
자동 연구(auto-research) 시스템은 대형 언어 모델(LLM)을 두뇌로 쓰는 AI 연구 에이전트예요. 논문의 정의를 빌리면 이런 시스템은 아이디어를 제안하고, 실험을 돌리고, 그 결과로 다음 연구 방향을 정하는 과정을 반복해요. 사람 연구자가 하루에 몇 번 하는 '고치고 돌려 보고 비교하기'를 자동으로 수십~수백 번 하는 셈이에요.
이때 같은 LLM을 쓰더라도 실험을 어떻게 조직하느냐에 따라 성과가 달라져요. 논문은 이 조직 방식을 하네스(harness)라고 불러요. 여러 에이전트가 팀을 이루는 방식, 가설을 나무 구조로 관리하는 방식, 진화 알고리즘처럼 후보 집단을 섞는 방식 등이 있어요. 문제는 이런 하네스를 공정하게 비교할 기준이 부족했다는 점이에요.
기존 벤치마크는 대부분 하나의 목표만 봤어요. 예를 들어 안드레이 카파시의 autoresearch는 정해진 학습 시간 안에 검증 손실을 최소화하는 문제였어요. 하나의 목표만 보면 그 문제에 특화된 방법이 과대평가될 수 있어요. Auto-Research Arena는 같은 실험 환경에 9개의 서로 다른 목표를 두고, 한 하네스가 여러 연구 문제에서 꾸준히 잘하는지를 보려고 만든 시험장이에요.
Auto-Research Arena는 무엇을 어떻게 측정하나
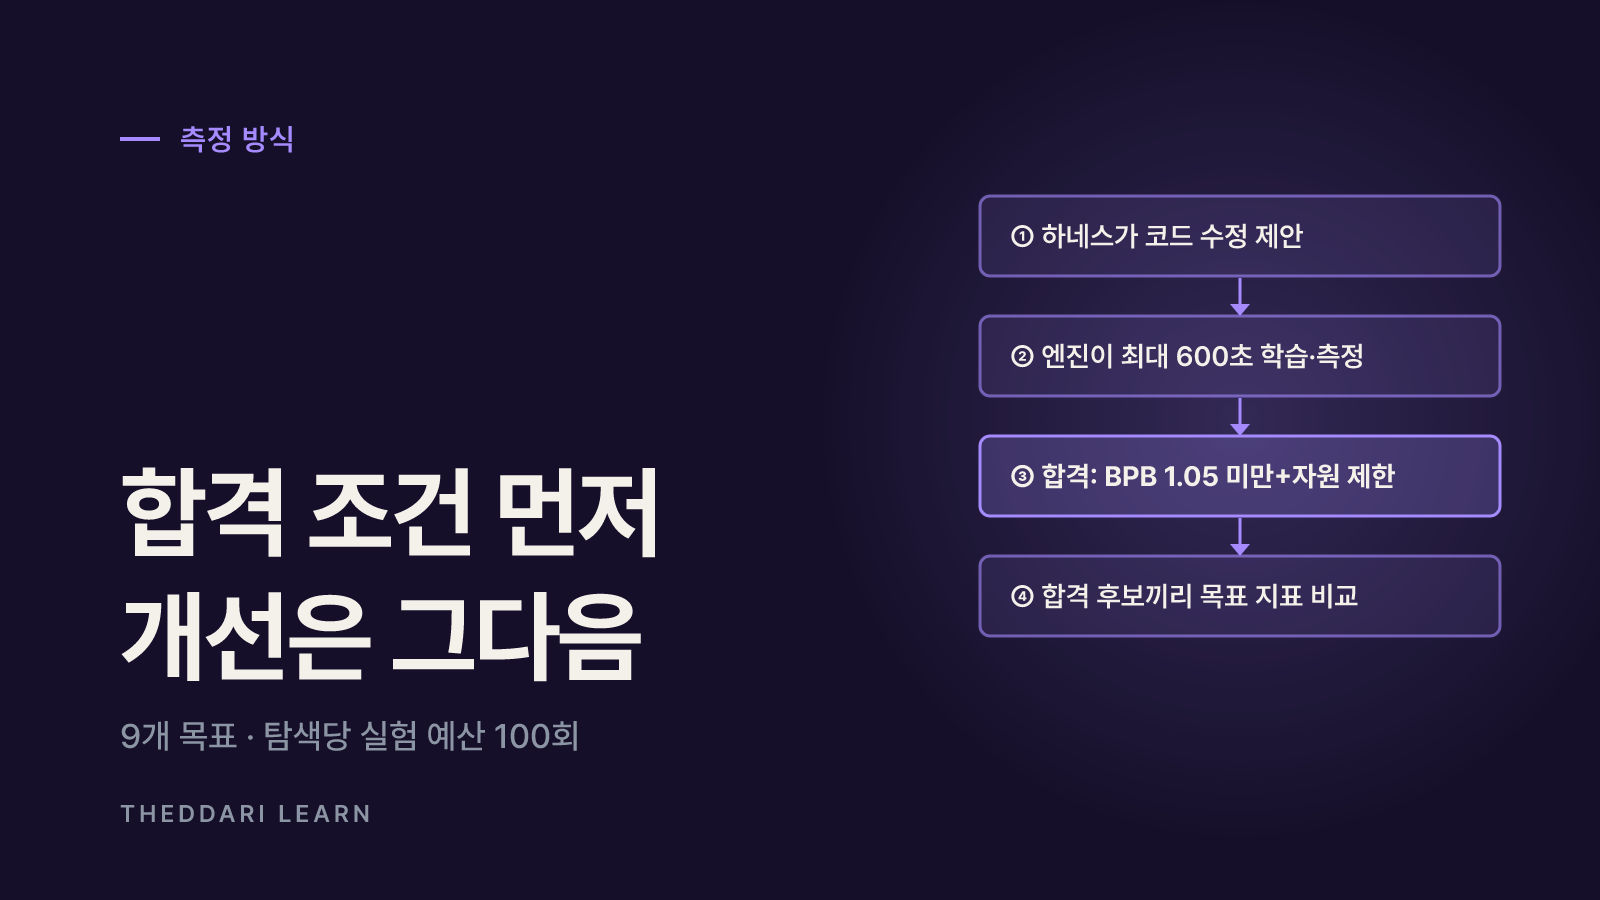
핵심 설계는 '합격 조건'과 '개선 방향'을 분리한 거예요. 후보 프로그램은 먼저 모델 품질과 자원 제한을 지켜야 합격(admissible)이 되고, 합격한 후보끼리만 선택한 목표 지표가 얼마나 낮아졌는지를 비교해요. 품질을 크게 희생해 숫자만 줄이는 편법을 막기 위한 장치예요.
| 항목 | 논문 v1 설정 |
|---|---|
| 대상 과제 | 카파시 autoresearch 기반의 소형 LLM 사전학습 코드 |
| 품질 합격선 | 검증 BPB(바이트당 비트) 1.05 미만 |
| 목표 수 | 9개(모델 크기, 학습 데이터·업데이트·FLOPs·메모리·시간, 추론 메모리·디코딩 지연·긴 프롬프트 지연) |
| 실험 예산 | 탐색 1회당 100번의 과금 실험(GPU 실행이 시작되면 실패해도 1회로 계산) |
| 하드웨어 | 후보마다 NVIDIA A100 80GB 1장, 시드 42, 최대 600초 학습 |
| 학습 데이터 | 약 6.31억 토큰 규모의 ClimbMix 데이터 풀 |
| 기반 모델 | Claude Opus 5, GPT-6 Astra(둘 다 중간 수준 추론 강도) |
| 비교 대상 | LLM 기반 하네스 6개 + 비에이전트 기준선 TPE 1개 |
하네스는 기준 프로그램에서 출발해 코드를 고치고, 평가를 요청하고, 측정값을 보고 다음 시도를 정해요. 평가는 벤치마크 쪽 엔진이 독립적으로 하고 모든 실험을 기록해요. 하네스가 마지막에 어떤 프로그램을 들고 있든, 기록된 후보 중 조건을 지킨 가장 좋은 결과가 점수가 돼요. 단위가 다른 9개 목표를 합치기 위해 목표별로 하네스를 맞대어 비교한 뒤 Elo 점수로 종합했어요.
BPB(bits per byte)는 텍스트 1바이트를 예측하는 데 필요한 평균 비트 수예요. 낮을수록 모델이 텍스트를 더 잘 예측한다는 뜻이에요. 논문은 기준 프로그램보다 약간 높은 1.05를 합격선으로 두어, 구조를 바꾸면서 생기는 소폭의 품질 하락은 허용했어요.
AI 연구 에이전트 비교 결과: 단순한 방법이 2위
논문 표 2의 종합 Elo를 기반 모델별로 정리하면 다음과 같아요. 점수가 높을수록 9개 목표 전반에서 다른 하네스를 더 자주 이겼다는 뜻이에요.
1
- Claude Opus 5 조합
- AutoScientists
- Elo
- 1729.4
- GPT-6 Astra 조합
- GEAR
- Elo
- 1835.3
2
- Claude Opus 5 조합
- Sequential Search
- Elo
- 1687.6
- GPT-6 Astra 조합
- Sequential Search
- Elo
- 1702.4
3
- Claude Opus 5 조합
- Arbor
- Elo
- 1632.4
- GPT-6 Astra 조합
- Arbor
- Elo
- 1459.6
4
- Claude Opus 5 조합
- GEAR
- Elo
- 1622.4
- GPT-6 Astra 조합
- Beam Search
- Elo
- 1423.3
5
- Claude Opus 5 조합
- Beam Search
- Elo
- 1438.6
- GPT-6 Astra 조합
- AutoScientists
- Elo
- 1298.7
6
- Claude Opus 5 조합
- Heuresis
- Elo
- 1350.4
- GPT-6 Astra 조합
- Heuresis
- Elo
- 1280.6
7
- Claude Opus 5 조합
- TPE(비에이전트)
- Elo
- 1039.2
- GPT-6 Astra 조합
- -
- Elo
- -
한 번에 하나씩 고치는 방법이 강했어요
Sequential Search는 저자들이 기준선으로 만든 가장 단순한 하네스예요. 프로그램 하나를 유지하면서 수정 하나를 시험하고, 조건을 지키며 나아지면 받아들인 뒤 다음으로 넘어가요. 이 방법이 두 기반 모델 모두에서 종합 2위를 했어요. 논문은 이를 '더 정교한 오케스트레이션이 아직 꾸준한 성과로 이어지지 않는다'는 신호로 해석하고, 현재 자동 연구 시스템 설계에 개선 여지가 크다고 봤어요.
한 문제에 특화된 방법은 넓은 시험에서 약했어요
TPE는 정해진 하이퍼파라미터 공간만 탐색하는 비에이전트 방법으로, 원래 검증 손실 최소화 설정에 맞춰 설계됐어요. 9개 목표 전체로 넓히자 모든 LLM 하네스보다 뒤처졌어요. 한 벤치마크 순위표 1위가 다른 연구 문제에서도 통한다는 보장이 없다는 뜻이에요.
최종 점수가 같아도 연구 효율은 달라요
Opus 5 조합의 학습 시간 목표에서 GEAR, Arbor, Beam Search, Heuresis는 모두 270초에 도달했지만, 처음 그 값에 닿은 시점은 각각 12번째, 39번째, 50번째, 99번째 실험이었어요. 같은 결과라도 실험 비용이 8배 넘게 차이 날 수 있어요. 또 하네스마다 실제로 쓴 평균 실험 수가 14.7회(GPT-6 조합 Arbor)부터 100회까지 달라, 예산을 끝까지 쓰지 않고 멈춘 경우도 있었어요.

에이전트가 찾은 아이디어는 실제로 쓸모가 있었나
효율 숫자만 보면 개선 폭이 커요. Opus 5 조합의 최고 프로그램들은 기준 대비 모델 크기를 5,033만에서 1,320만 파라미터로, 학습 연산을 토큰당 2억 3,908만에서 5,215만 FLOPs로, 최대 학습 메모리를 43.96GiB에서 0.373GiB로 줄이면서 BPB 1.05 미만을 지켰어요. 다만 이 결과는 작은 모델과 10분 학습이라는 좁은 조건의 값이에요.
논문은 탐색 과정에서 32개의 서로 다른 발견(그중 20개는 탐색 중 실제 개선으로 채택)을 9개 아이디어 계열로 묶었어요. 대표 사례는 파라미터를 줄이라는 목표에서 나온 루프 트랜스포머예요. 블록 하나의 가중치를 여러 깊이에서 반복해 쓰고, 깊이마다 따로 학습되는 잔차 게인을 붙였어요. 최근 사람 연구자들이 루프 트랜스포머의 핵심 요소로 다룬 아이디어와 원리가 비슷하지만, 구현 방식은 달랐다고 해요.
저자들은 이 발견들이 탐색 밖에서도 통하는지 따로 확인했어요. 발견 목록을 새 탐색에 넘겨 품질 중심으로 조합·수정하게 한 뒤, 1시간 동안 처음부터 학습시켰어요. 그 결과 같은 학습 데이터 기준 학습 손실이 2.675에서 2.544로, 같은 누적 FLOPs 기준 2.617에서 2.544로 낮아졌고, 거의 같은 모델 크기에서 검증 BPB도 0.9295에서 0.9112로 내려갔어요.
이 수치는 저자들이 직접 보고한 단일 실험 결과예요. 수억 토큰 규모의 소형 모델 실험이라 수십억~수조 토큰으로 학습하는 대형 모델에서도 같은 효과가 나는지는 논문이 보여 주지 않았어요.
한계: 어디까지가 '스스로 하는 연구'인가
Auto-Research Arena는 자동 연구 AI를 비교하는 데 유용한 틀이지만, 'AI가 혼자 연구한다'는 말로 바로 옮기기엔 조건이 많아요. 논문과 공개 코드를 읽고 확인한 주요 한계는 다음과 같아요.
- 사람이 문제를 정의해요. 목표 지표, 품질 합격선, 자원 제한, 수정 가능한 코드 범위, 평가기는 모두 벤치마크 설계자가 정해요. 에이전트는 그 안에서 탐색해요.
- 과제 범위가 좁아요. 약 5천만 파라미터 수준의 소형 모델을 최대 600초 학습하는 환경이에요. 대규모 학습, 새로운 데이터 수집, 실험실 실험 같은 연구는 포함하지 않아요.
- 반복 측정이 제한적이에요. 후보 평가는 시드 42 하나로 이뤄졌어요. 우연에 따른 편차를 얼마나 걸러냈는지는 독자가 따로 따져 봐야 해요.
- 저자 기준선이 2위예요. 가장 단순한 Sequential Search는 저자들이 직접 만든 방법이에요. 다른 하네스는 벤치마크에 맞춰 통합하는 과정에서 원래 설정이 바뀌었을 수 있어요(예: GEAR에는 제약 검사 패치를 추가).
- 동료 평가 전 v1 논문이에요. 2026년 10월 기준 arXiv 사전 공개본이며 이후 수정·반박이 나올 수 있어요.
- 재현 비용이 높아요. README 기준 NVIDIA A100-SXM4-80GB와 리눅스 환경이 필요해요.
자동 연구 주장을 읽을 때 확인할 5가지
앞으로 'AI가 스스로 연구해 성능을 X% 올렸다'는 기사나 발표를 자주 보게 될 거예요. 아래 순서로 확인하면 과장된 주장을 걸러 내는 데 도움이 돼요.
- 1
과제와 목표가 무엇인지 봐요
연구 주제를 AI가 골랐는지, 사람이 정한 지표를 최적화했는지 구분해요. Auto-Research Arena는 후자예요.
- 2
합격 조건이 있는지 봐요
품질 하한이나 자원 제한 없이 숫자 하나만 줄였다면 편법일 수 있어요. 이 벤치마크처럼 BPB 같은 품질 기준을 함께 지켰는지 확인해요.
- 3
실험 예산과 실패 비용을 봐요
몇 번 시도해서 얻은 결과인지, 실패한 실험도 비용에 넣었는지 확인해요. 같은 결과라도 12번 만에 찾은 것과 99번 만에 찾은 것은 다르게 평가해야 해요.
- 4
사람 개입 범위를 봐요
프롬프트 수정, 결과 선별, 코드 통합 과정에서 사람이 얼마나 손을 댔는지 확인해요. 공개 코드의 통합 예시와 설정 파일이 단서가 돼요.
- 5
재현 자료와 일반화 검증을 봐요
코드·로그·제출 보고서가 공개됐는지, 탐색 조건 밖(더 긴 학습, 다른 모델 크기)에서도 효과를 확인했는지 봐요.
AI 벤치마크 점수 차이를 해석하는 일반적인 방법은 AI 모델 비교 사이트·벤치마크 순위표 읽는 법에서, 비슷한 주장의 검증 방법은 AI 수학 성과 주장 검증하는 법에서 함께 볼 수 있어요. 자동 연구 관련 논문과 커뮤니티 반응은 블로그 트렌드에서도 계속 모아 볼 수 있어요.
정리: 지금의 자동 연구 AI 수준
2026년 10월 기준 Auto-Research Arena 결과를 요약하면, 자동 연구 AI는 사람이 잘 정의한 문제 안에서 100번 남짓의 실험으로 효율을 크게 끌어올리고, 사람 연구와 닮은 아이디어를 찾아낼 수 있는 단계예요. 동시에 가장 단순한 탐색 방법이 정교한 시스템과 비슷하거나 더 잘했다는 점은, 하네스 설계가 아직 초기 단계라는 뜻이기도 해요. 연구 주제를 고르고 결과의 과학적 의미를 판단하는 일은 이 벤치마크의 측정 범위 밖이에요. 새 자동 연구 발표를 볼 때는 과제 범위, 합격 조건, 실험 예산, 사람 개입, 재현 자료를 함께 확인해 보세요.
자주 묻는 질문
AI가 혼자서 논문 수준의 연구를 할 수 있나요?
Auto-Research Arena에서 가장 잘한 AI 연구 에이전트는 무엇인가요?
Elo 점수는 왜 쓰나요? 일반 정확도와 무엇이 다른가요?
이 벤치마크를 직접 돌려 볼 수 있나요?
AI 과학자(AI Scientist) 같은 다른 자동 연구 시스템과는 어떻게 달라요?
출처·참고 자료
관련 글
 AI
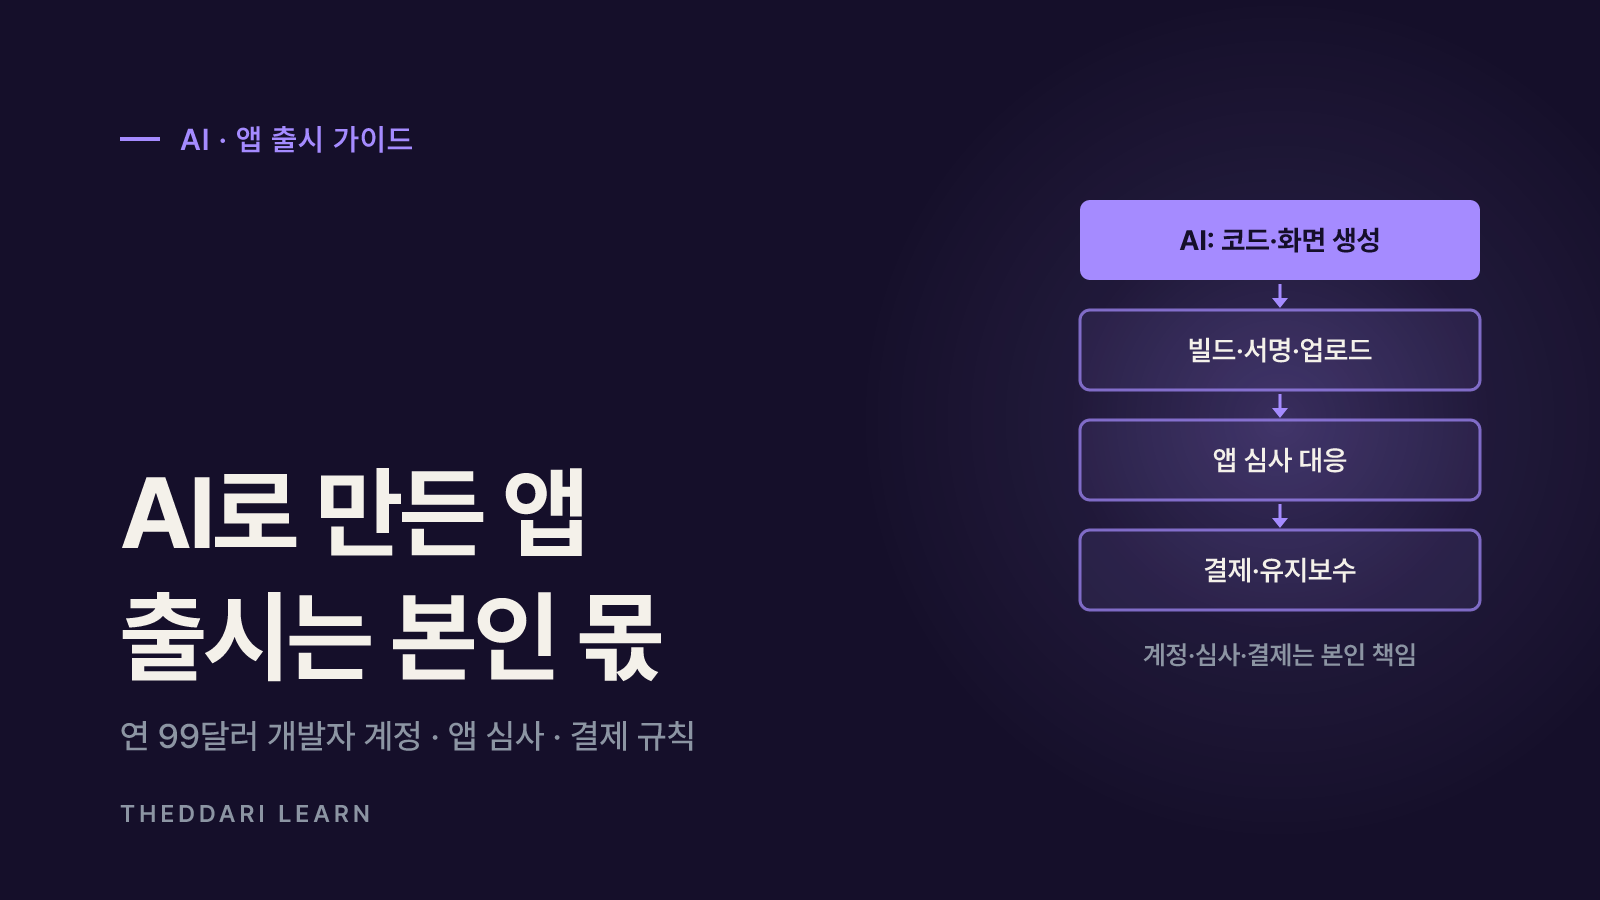
AI 앱 출시, 코딩 몰라도 될까? 개발자 계정·심사·결제 현실
AI가 코드를 써 줘도 개발자 계정, 빌드 서명, 앱 심사, 결제 방식 선택, 출시 후 유지보수는 본인 몫이에요. 애플 공식 문서로 AI 앱 출시의 실제 단계를 짚었어요.
 AI
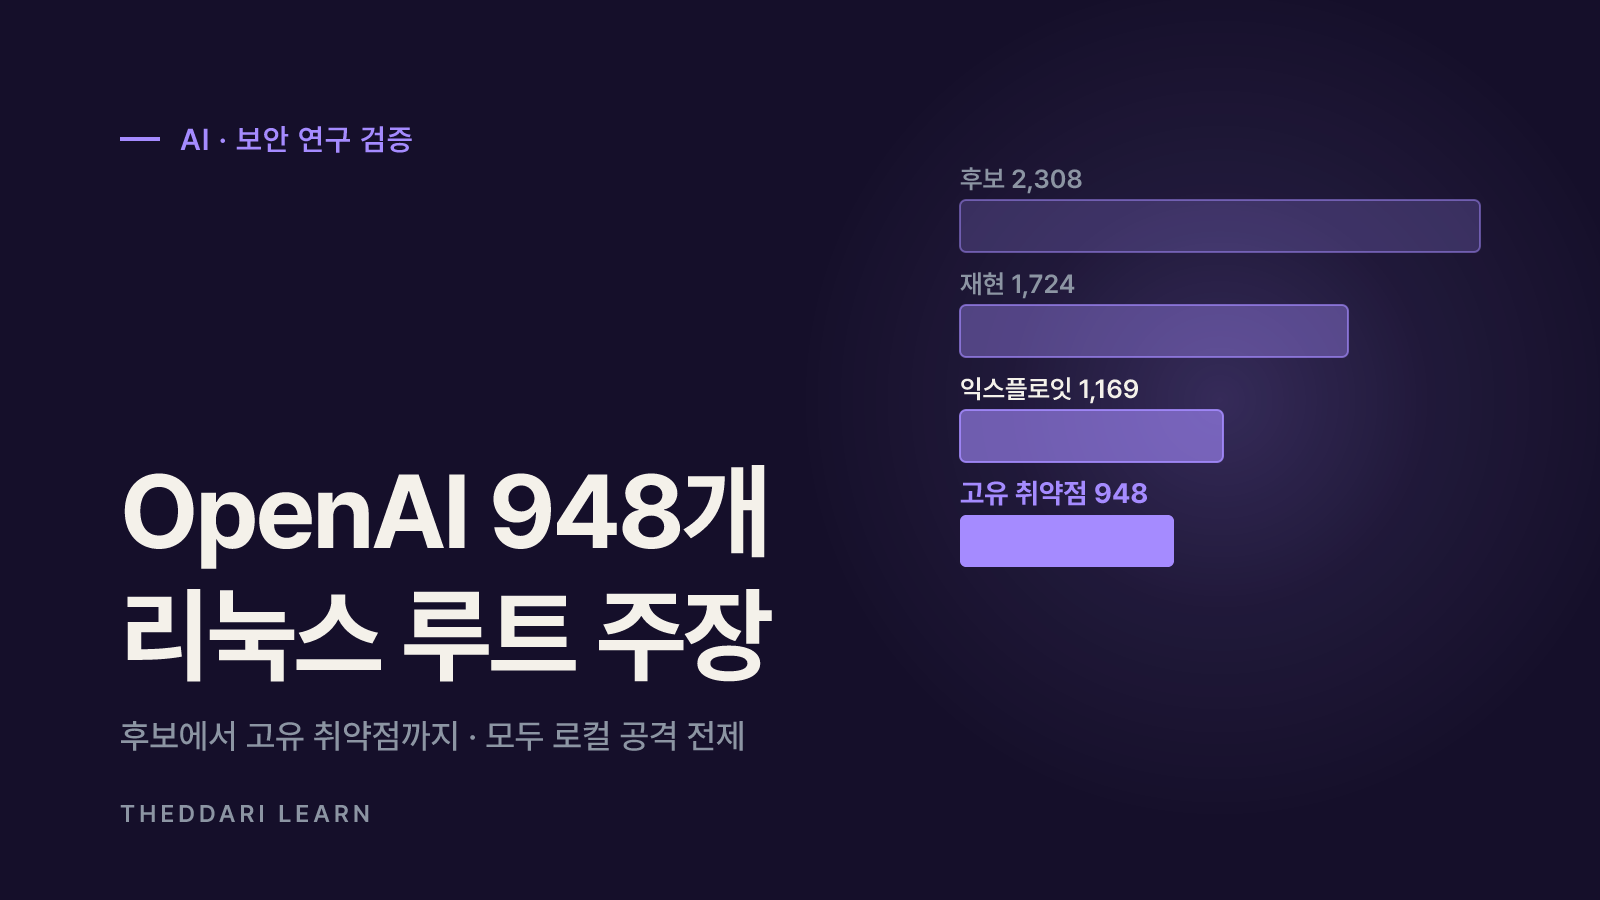
OpenAI 리눅스 취약점 948개, 사실일까? 주장 확인법과 서버 점검
'OpenAI가 리눅스를 루팅할 948가지 방법을 찾았다'는 말은 원 발표와 대체로 맞지만, 조건이 붙어 있어요. 948이 무엇을 센 숫자인지, AI 취약점 주장을 어떻게 검증하는지, 서버에서 무엇을 먼저 점검할지 정리했어요.
 AI
Qwen4-Max란? 알리바바 새 플래그십 모델과 API 쓰기 전 확인할 점
Qwen4-Max는 알리바바 Qwen4 세대의 첫 플래그십 모델이에요. 가중치를 내려받는 오픈 모델이 아니라 QwenCloud API와 Token Plan으로 쓰는 모델이고, 지역에 따라 요금과 추론 위치가 달라요. 쓰기 전에 확인할 점을 공식 문서 기준으로 정리했어요.