AI 탄소 배출, 질문 하나에 얼마? 전력망 따라 8.5배 차이 나는 이유
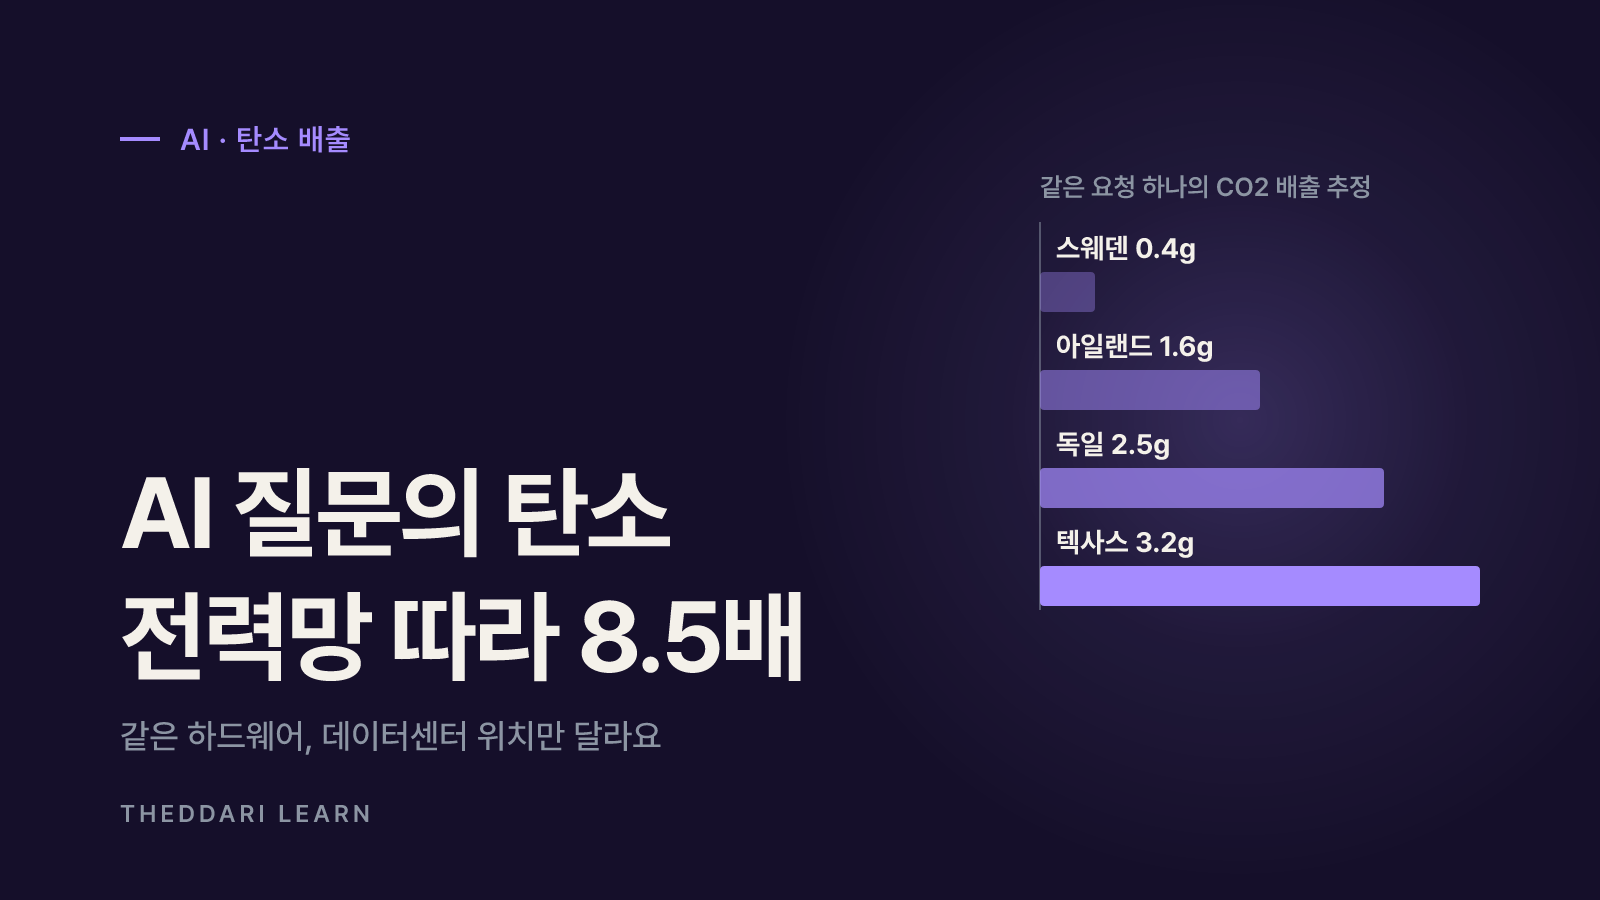
같은 AI 요청도 스웨덴 약 0.4g, 텍사스 3.2g으로 CO2 배출이 8.5배 달라요. 전력망 탄소집약도·냉각·하드웨어 제조가 어떻게 계산되는지와 추정치의 한계를 정리했어요.
목차7개 섹션
핵심 요약
- Berget AI 추정(2026년 10월 21일 발표)에서 Kimi K3 요청 하나는 스웨덴 약 0.4g, 아일랜드 1.6g, 독일 2.5g, 텍사스 3.2g의 CO2를 배출해요.
- 차이의 핵심은 전력망 탄소집약도예요. 스웨덴은 kWh당 약 8g, 텍사스(ERCOT)는 약 333g으로 집계됐어요.
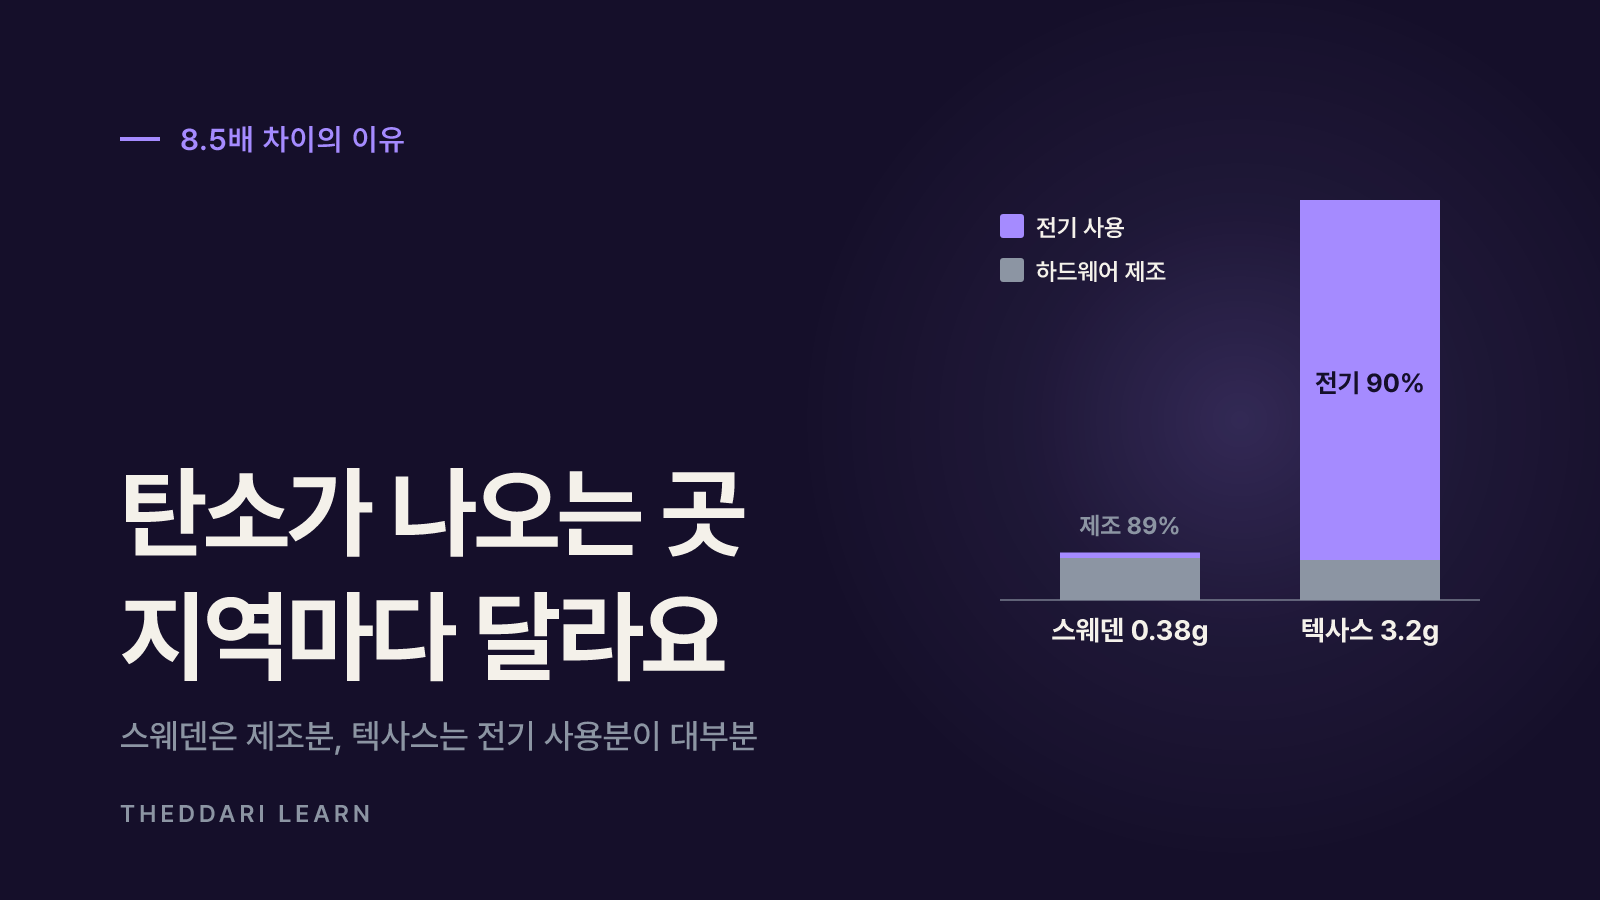
- 전력이 깨끗한 곳에서는 하드웨어 제조 배출이 대부분(스웨덴 89%)을, 화석연료 비중이 큰 곳에서는 전기 사용분이 대부분(텍사스 90%)을 차지해요.
- 구글이 밝힌 Gemini 중앙값 0.03g은 모델·토큰 수·집계 방식(시장 기반)이 달라 Berget 수치와 직접 비교할 수 없어요.
- 요청당 배출량은 위치·모델·시간대·캐시·학습 포함 여부 같은 가정에 따라 크게 바뀌는 추정치예요.
AI 탄소 배출은 질문 내용보다 그 질문이 어느 전력망 위의 서버에서 처리되느냐에 따라 크게 달라져요. 스웨덴 AI 사업자 Berget AI가 2026년 10월 21일 공개한 추정에 따르면, 오픈 모델 Kimi K3에 보낸 같은 요청 하나가 스웨덴에서는 약 0.4g, 텍사스에서는 3.2g의 CO2를 배출해 약 8.5배 차이가 났어요. 같은 하드웨어 기준인데도 이렇게 벌어지는 이유와, 이런 요청당 수치를 읽을 때 꼭 확인해야 할 가정을 2026년 10월 기준 공개 자료로 정리했어요.
AI 탄소 배출, 요청 하나에 얼마나 나오나요
Berget AI 보도자료는 스톡홀름환경연구소(SEI), 비영리단체 WattTime·Klimatkollen과 함께 만든 요청별 탄소 계산법을 공개하면서 지역별 예시를 제시했어요. 기준은 B300 GPU 노드를 여러 고객이 함께 쓰는 환경, 입력 5,000토큰·출력 387토큰의 실제 운영에서 흔한 요청이에요. 계산에는 지역 평균 전력망 배출계수(위치 기반 방식)와 하드웨어 제조 배출이 들어가고, 모델 학습 배출은 빠져 있어요.
스웨덴
- 요청 1건 CO2 (Kimi K3)
- 약 0.4g (0.38g)
- 전력망 탄소집약도 (gCO2e/kWh)
- 약 8
- 출처 연도
- IEA 2024
아일랜드
- 요청 1건 CO2 (Kimi K3)
- 1.6g
- 전력망 탄소집약도 (gCO2e/kWh)
- 약 224
- 출처 연도
- SEAI 2024
독일
- 요청 1건 CO2 (Kimi K3)
- 2.5g
- 전력망 탄소집약도 (gCO2e/kWh)
- 약 337
- 출처 연도
- Ember 2024
텍사스(ERCOT)
- 요청 1건 CO2 (Kimi K3)
- 3.2g
- 전력망 탄소집약도 (gCO2e/kWh)
- 약 333
- 출처 연도
- EPA eGRID 2023
참고로 같은 자료에 실린 세계 평균 전력망 탄소집약도는 kWh당 약 470g이에요. 이 숫자들은 Berget이 자기 인프라와 공개 계수로 계산한 추정치이지 각 지역 데이터센터를 실측한 값이 아니에요. 보도자료에는 엠바고 배포본이 아일랜드 1.2g, 독일 2.1g, 텍사스 3.9g, 10배 차이로 적었다가 출처 재검토 후 위 값으로 정정했다는 내용도 붙어 있어요. 같은 발표 안에서도 계수 하나가 바뀌면 결과가 달라진다는 점을 보여 주는 사례예요.
같은 요청이 지역 따라 8.5배 달라지는 이유
요청당 탄소는 대략 사용 전력 × 전력망 탄소집약도 × 데이터센터 부대 전력 비율(PUE) + 하드웨어 제조 배출 할당분으로 계산돼요. 세 가지 요인이 지역마다 다르게 작동해요.
1. 전력망 탄소집약도
가장 큰 요인이에요. 수력·원자력 비중이 큰 스웨덴 전력망은 kWh당 약 8g인데 가스·석탄 발전 비중이 큰 텍사스는 약 333g이에요. 같은 전기를 써도 배출 계수가 40배 넘게 차이 나요. 그래서 Berget 자료에서 텍사스 요청 3.2g 중 90%는 전기 사용에서 나왔어요.
2. 기후와 냉각(PUE)
PUE는 데이터센터 전체 전력을 서버 전력으로 나눈 값으로, 냉각·전력 변환에 드는 추가 전력을 나타내요. Berget은 북유럽의 외기 냉각은 PUE 약 1.15에 물을 쓰지 않고, 더운 기후는 1.8 가까이 오르며 kWh당 물 최대 2L를 쓴다고 정리했어요. GitHub 계산기 기본값도 독일 1.35, 텍사스 1.80이에요. 독일과 텍사스의 전력망 계수는 비슷한데 요청당 배출이 2.5g과 3.2g으로 갈리는 이유가 여기에 있어요. 텍사스 요청에는 냉각수 약 6mL도 함께 집계됐어요.
3. 하드웨어 제조 배출
GPU를 만드는 데도 탄소가 나와요. Berget은 데이터센터 GPU 1장당 약 1,000kg CO2로 잡고 5년 수명에 나눠 요청마다 배분해요. 이 몫은 위치와 상관없이 같아서, 전력이 깨끗한 스웨덴에서는 0.38g 중 89%가 제조분이에요. 그래서 운영 전력분만 보면 지역 차이가 훨씬 크게 나와요. 계산기 README의 Gemma 4 31B 예시에서는 스웨덴과 미국 평균의 운영 배출 차이가 약 56.7배인데, 제조분을 더한 총합 차이는 약 7.2배로 줄어요.
유휴 전력도 변수예요. Berget은 놀고 있는 B300 한 대가 7일 측정 기준 236W를 쓴다고 밝혔어요. 서버 가동률이 낮을수록 대기 전력이 요청 수가 적은 곳에 나뉘어 요청당 배출이 커져요.
구글 Gemini 0.03g과 왜 이렇게 다를까요
구글은 2025년 8월 2025년 5월 데이터를 기준으로 Gemini 앱 텍스트 프롬프트 중앙값이 0.24Wh의 에너지, 0.03gCO2e, 물 0.26mL를 쓴다고 발표했어요. Berget의 스웨덴 수치보다도 작아 보이지만 두 숫자는 같은 저울에 올린 값이 아니에요.
대상 요청
- Berget AI (Kimi K3)
- 입력 5,000·출력 387토큰의 일반적 요청
- 구글 (Gemini 앱)
- 텍스트 프롬프트 중앙값
모델
- Berget AI (Kimi K3)
- 2.8T 파라미터 MoE 오픈 모델
- 구글 (Gemini 앱)
- 구글이 서비스하는 여러 Gemini 모델 중 중앙값 위치 모델
전력망 계수
- Berget AI (Kimi K3)
- 지역 평균(위치 기반)
- 구글 (Gemini 앱)
- 구글 2024 플릿 평균, 시장 기반 Scope 2 포함
하드웨어 제조분
- Berget AI (Kimi K3)
- 포함
- 구글 (Gemini 앱)
- Scope 1+3로 일부 반영
검증
- Berget AI (Kimi K3)
- 방법론·코드 MIT 공개
- 구글 (Gemini 앱)
- 제3자 검증 없음(구글 명시)
가장 큰 차이는 위치 기반과 시장 기반 집계예요. 위치 기반은 서버가 연결된 지역 전력망의 평균 배출계수를 쓰고, 시장 기반은 기업이 산 재생에너지 계약을 반영해 계수를 낮출 수 있어요. 구글 논문 표에서도 0.03g 중 시장 기반 Scope 2가 0.023g이에요. 또 구글은 가속기 전력만 세는 좁은 방식이면 에너지가 0.10Wh로 줄어든다며 측정 범위에 따라 2.4배 차이가 난다고 직접 밝혔어요. 숫자를 비교할 때는 토큰 길이, 모델 크기, 집계 방식, 포함 범위가 같은지부터 확인해야 해요.
요청당 배출 추정의 가정과 한계
- 평균 vs 한계 배출계수: Berget은 지역 평균 계수를 썼어요. AI 수요가 늘어 추가로 돌리는 발전소나 새로 짓는 발전소의 영향을 반영하는 한계 배출계수를 쓰면 스웨덴 데이터센터 수치가 크게 바뀔 수 있다고 직접 각주에 적었고, 계산기에 다음 달 추가할 예정이라고 밝혔어요.
- 학습 배출 제외: 사업자 자체 보고 학습 배출량이 ±50% 편차를 보여 기본값에서 뺐어요. 포함하면 요청당 수치가 커질 수 있어요.
- 제조 배출 불확실성: GPU 제조사가 칩별 전과정평가를 공개하지 않아 내재 탄소 추정치에 ±30~50% 불확실성이 있어요. 칩 제조의 물·에너지 영향은 현재 버전에 들어 있지 않아요.
- 요청마다 다름: 모델 종류, 하루 중 시간대, 프롬프트 일부가 캐시됐는지에 따라 결과가 달라져서 평균 하나를 곱하지 않고 요청별로 계산해요.
- 사업자 추정치: Berget은 저탄소 지역을 내세우는 스웨덴 사업자예요. 방법을 공개했다는 점은 장점이지만, 기본값이 자사 인프라라는 점도 함께 고려해야 해요.
규모 관점의 숫자도 같이 볼 만해요. SEI 연구 책임자는 보도자료에서 국제에너지기구(IEA)가 데이터센터 전력 소비가 2030년까지 약 945TWh로 두 배 넘게 늘 것으로 전망한다고 인용했어요. 요청 하나는 작아도 호출 수가 늘면 어느 전력망에서 처리되는지가 총량에 직접 반영돼요. 텍사스처럼 데이터센터가 빠르게 늘어나는 지역에서는 CO2 외에 발전소 대기오염과 냉각수 사용도 지역 쟁점이 되고 있어요.
AI 전력 소비와 탄소를 줄이려면 무엇을 확인할까요
Berget 자료에 따르면 오픈 웨이트 모델이 Vercel AI Gateway 토큰의 29%(2026년 6월, 4월 약 11%)를 차지할 만큼 늘었어요. 오픈 모델은 어느 데이터센터에서든 돌릴 수 있어서, 배출 정보가 보이면 구매자가 처리 지역을 고를 여지가 생겨요.
- 1
처리 지역을 확인해요
API 사업자의 리전 목록과 데이터 처리 위치를 확인해요. 같은 모델이라도 리전 선택이 가능하다면 해당 지역 전력망 계수를 비교해 볼 수 있어요. 데이터 주권·지연 시간 요건도 함께 따져야 해요.
- 2
수치의 집계 방식을 물어봐요
사업자가 탄소 수치를 준다면 위치 기반인지 시장 기반인지, 하드웨어 제조와 학습이 포함됐는지, 어느 연도의 배출계수인지 확인해요. 방식이 다른 수치끼리 순위를 매기지 않아요.
- 3
요청 자체를 줄여요
입력 토큰이 많을수록 연산이 늘어요. 불필요하게 긴 컨텍스트를 줄이고, 반복 프롬프트는 캐시를 활용하며, 작업에 맞는 작은 모델을 쓰면 전력 사용이 줄어요.
- 4
공개 계산기로 감을 잡아요
Berget의 계산기(co2.berget.ai)와 GitHub 코드는 모델·지역·하드웨어를 바꿔 볼 수 있어요. 결과는 추정치이므로 보고용으로 쓸 때는 가정을 함께 적어요.
AI 인프라와 데이터센터 관련 뉴스가 어떻게 흘러가는지는 더따리의 AI 텔레그램 채널 모음과 블로그 트렌드에서 함께 살펴볼 수 있어요. 새 수치가 나오면 위 표의 항목(모델, 토큰, 계수, 포함 범위)에 대입해 보면 과장인지 비교 가능한 값인지 가려내기 쉬워요.

정리하면, AI 요청 하나의 CO2는 0.03g부터 몇 g까지 다양한 숫자로 보도되지만 그 차이의 상당 부분은 전력망 위치, 냉각 조건, 제조분 포함 여부, 집계 방식 같은 가정에서 나와요. 8.5배라는 숫자는 '어디서 돌리느냐'가 중요하다는 신호로 읽고, 개별 수치는 출처의 계산 조건과 함께 확인하는 것이 안전해요.
자주 묻는 질문
ChatGPT나 Gemini에 질문 하나 하면 탄소가 얼마나 나오나요?
독일과 텍사스는 전력망 탄소집약도가 비슷한데 왜 배출량이 다른가요?
스웨덴 데이터센터를 쓰면 AI 탄소 배출이 거의 0이 되나요?
AI 모델 학습 배출도 요청당 수치에 포함되나요?
출처·참고 자료
- 1