목차8개 섹션
결론부터 말하면, AI 탐지기의 점수는 '누가 썼는지'를 입증하는 증거가 아니라 추가 확인이 필요한지 알려 주는 약한 단서예요. 2026년 10월 기준으로 공개된 연구들을 보면 탐지기는 사람이 쓴 글을 AI로 판정하는 오탐과, 조금 손본 AI 글을 사람 글로 놓치는 미탐을 모두 일으켜요. 이 글은 학생·교사·채용 담당자·개발자처럼 AI 작성 글 판별 결과를 받아 들거나 직접 써야 하는 분을 위해, 탐지 원리와 실제 정확도, 휴머나이저 도구의 등장, AI 작성 코드 탐지 연구의 현재 수준을 근거와 함께 정리했어요.
상징적인 사례가 있어요. ChatGPT를 만든 OpenAI는 2023년 1월 31일 AI 작성 텍스트 분류기를 공개했지만, 공식 페이지 고지처럼 '정확도가 낮다'는 이유로 2023년 7월 20일 서비스를 중단했어요. 공개 당시 평가에서도 AI가 쓴 글의 26%만 'AI 작성 가능성 높음'으로 잡았고, 사람 글의 9%를 AI 글로 잘못 표시했어요.
AI 탐지기는 어떻게 판별할까: 원리와 점수의 의미
대부분의 AI 텍스트 탐지기는 크게 두 갈래예요. 하나는 언어 모델이 보기에 문장이 얼마나 예측하기 쉬운지를 재는 방식이고, 다른 하나는 사람 글과 AI 글을 모아 분류 모델을 학습시키는 방식이에요. 어느 쪽이든 결과는 '이 글이 AI 글과 통계적으로 닮았다'는 추정이지, 실제로 AI가 썼다는 기록을 찾는 것이 아니에요.
퍼플렉서티: 예측하기 쉬운 문장은 AI처럼 보여요
퍼플렉서티(perplexity)는 언어 모델이 다음 단어를 맞히기 어려운 정도예요. 생성형 AI는 확률이 높은 단어를 골라 쓰는 경향이 있어 퍼플렉서티가 낮게 나오기 쉬워요. 문제는 사람도 예측하기 쉬운 글을 쓴다는 점이에요. 어휘 폭이 좁은 외국어 글, 정해진 형식의 보고서, 소수 목록처럼 답이 정해진 내용은 누가 써도 비슷해져요. OpenAI도 '매우 예측 가능한 텍스트는 신뢰성 있게 판별할 수 없다'고 밝혔어요.
분류기 점수는 학습 데이터 밖에서 흔들려요
학습형 분류기는 훈련에 쓴 모델·장르·길이와 비슷한 글에서는 잘 작동하지만, 처음 보는 유형에서는 틀린 답을 매우 자신 있게 내놓을 수 있어요. OpenAI는 자사 분류기가 1,000자 미만의 짧은 글에서 매우 불안정하고, 영어 외 언어와 코드에서는 신뢰할 수 없다고 적었어요. 새 AI 모델이 나올 때마다 글의 통계적 특징도 바뀌기 때문에, 탐지기 점수는 시점과 대상에 따라 의미가 달라져요.
점수가 90%라고 해서 'AI가 썼을 확률이 90%'라는 뜻은 아니에요. 대부분은 모델 내부의 신뢰도 값이며, 실제로 맞을 확률은 그 탐지기의 오탐률·미탐률과 검사 대상 중 AI 글 비율에 따라 달라져요.
AI 탐지기 정확도: 연구로 본 오탐과 미탐
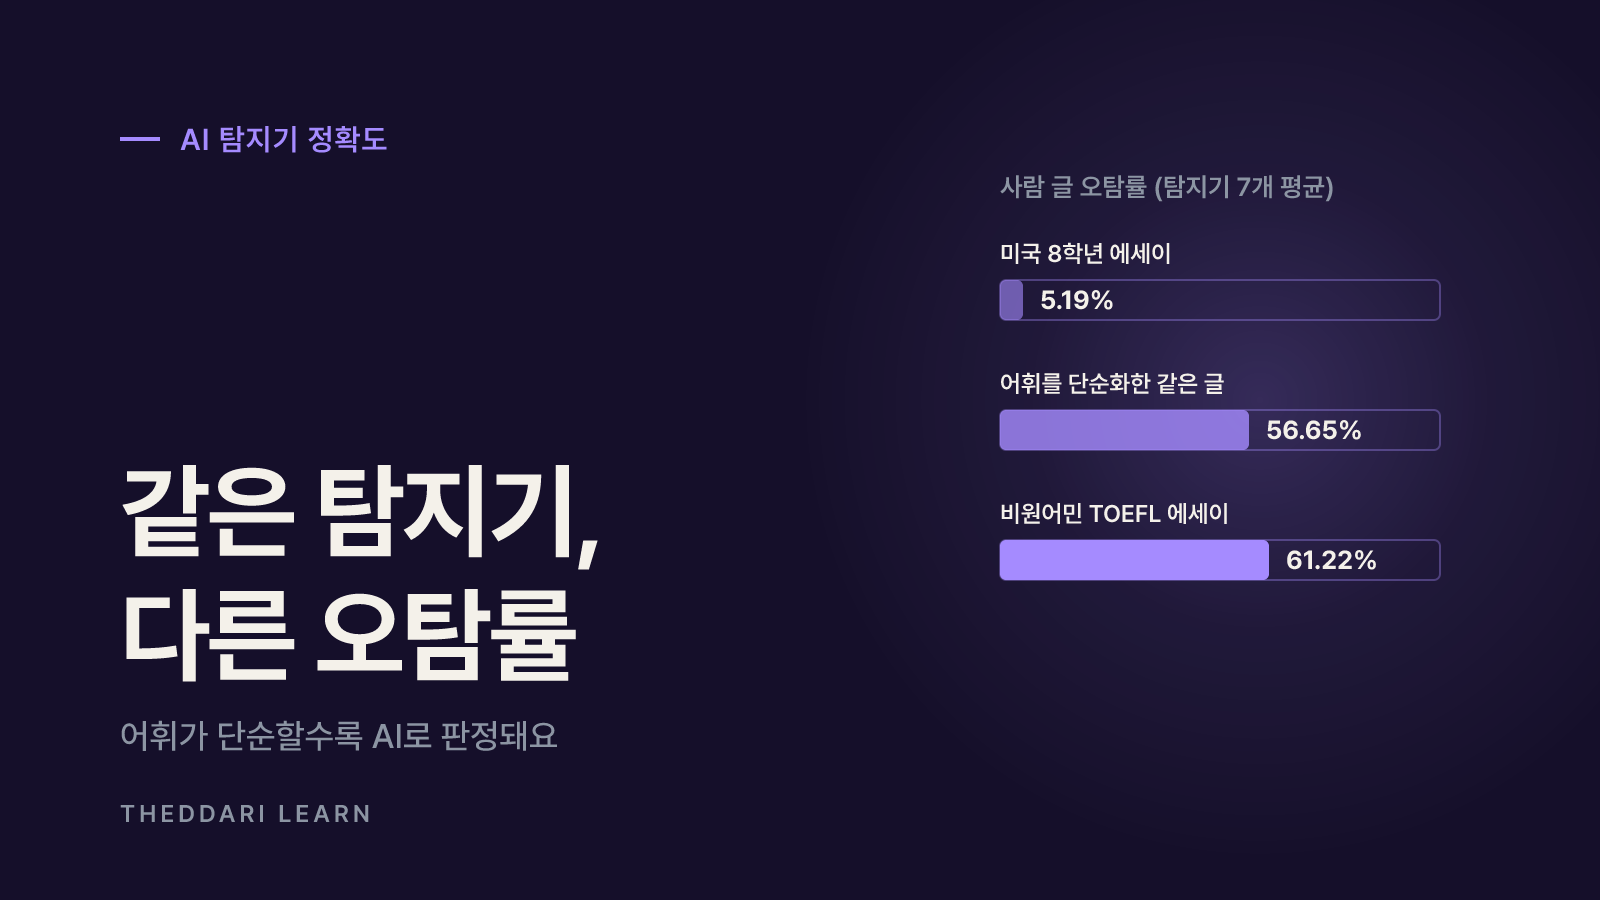
탐지기 정확도를 볼 때는 두 숫자를 따로 봐야 해요. 오탐률은 사람 글을 AI 글로 잘못 판정하는 비율이고, 탐지율은 AI 글을 제대로 잡아내는 비율이에요. 억울한 판정을 줄이려면 오탐률이, 부정 사용을 잡으려면 탐지율이 중요한데, 두 값은 보통 서로 줄다리기를 해요.
OpenAI 분류기(2023년 1월)
- 검사 대상
- 영어 챌린지 세트
- 주요 결과
- AI 글 탐지 26%, 사람 글 오탐 9%, 2023년 7월 20일 철회
Liang 외 스탠퍼드(2023년 7월)
- 검사 대상
- 비원어민 TOEFL 에세이 91편, 7개 탐지기
- 주요 결과
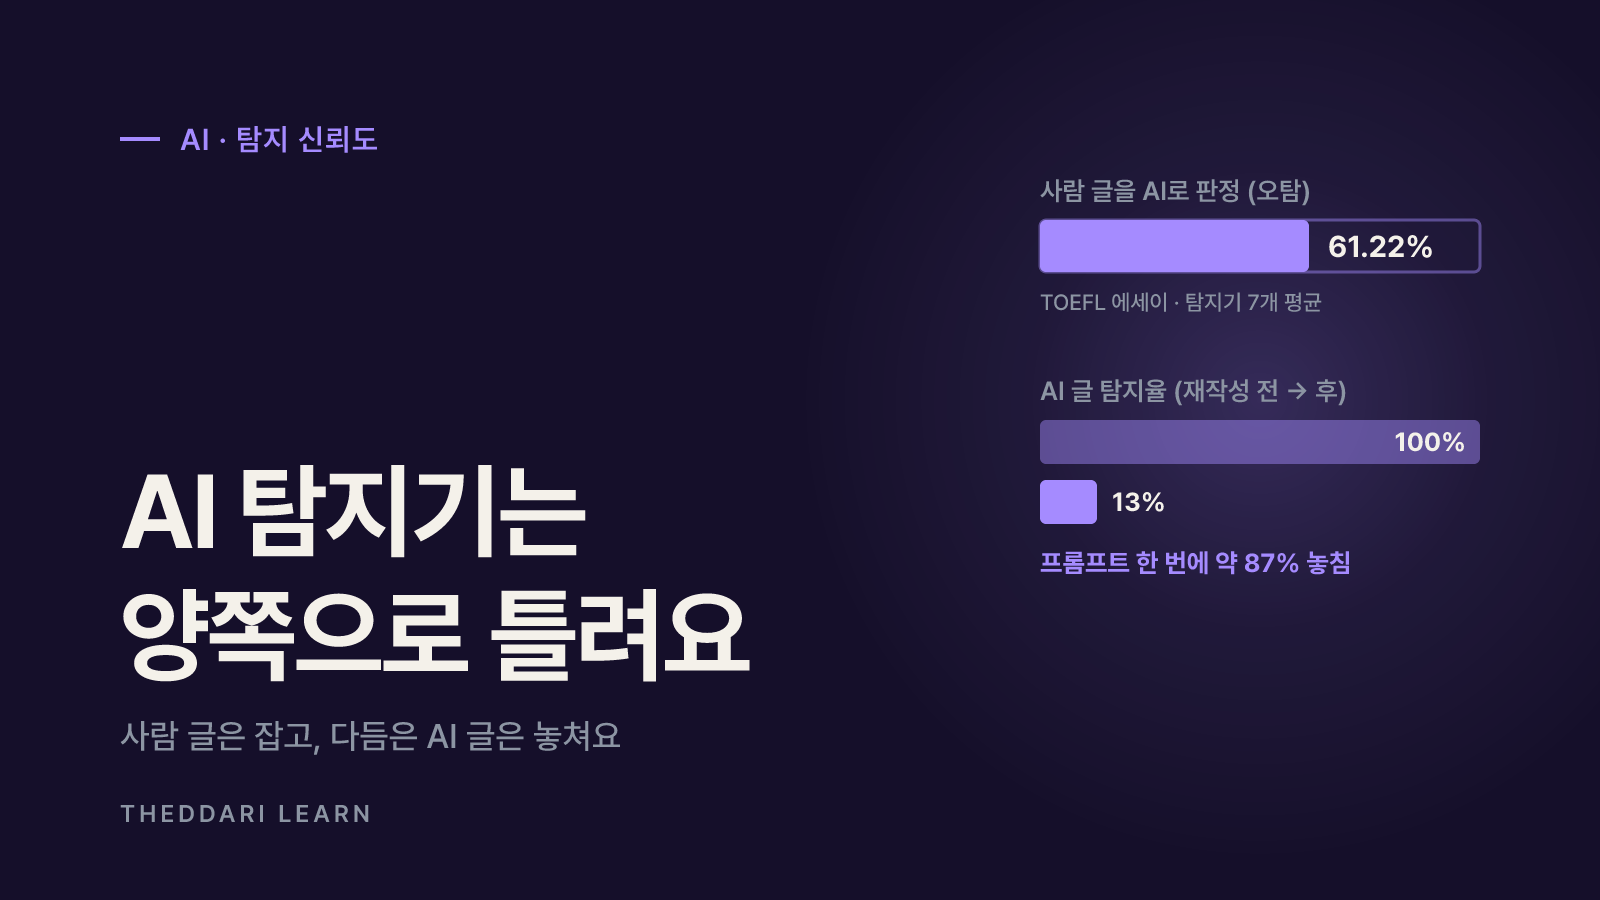
- 평균 오탐률 61.22%, 89편(97.80%)이 최소 한 탐지기에서 AI로 판정
Mozilla 재평가(2024년 3월)
- 검사 대상
- Binoculars, 공개 데이터셋
- 주요 결과
- 논문 주장 오탐 0.01% 대비 실측 약 0.7%(약 140건 중 1건), 탐지율 43%
Park 외(2026년 8월, EMNLP 2026)
- 검사 대상
- 교정 서비스 문서 쌍 135,389개, 13개 탐지기
- 주요 결과
- 사람 글 오탐률이 탐지기마다 0.0%~100.0%로 제각각
비원어민 글이 더 자주 AI로 찍혀요
스탠퍼드 연구진의 2023년 논문은 같은 7개 탐지기에 미국 8학년 에세이와 중국 교육 포럼의 TOEFL 에세이를 넣었어요. 미국 학생 글은 거의 정확히 사람 글로 판정됐지만 TOEFL 에세이는 평균 61.22%가 AI 작성으로 잘못 분류됐어요. 7개 탐지기 모두가 AI라고 판정한 TOEFL 글도 18편(19.78%)이었어요. 반대로 미국 학생 글의 어휘를 비원어민처럼 단순하게 바꾸자 오탐률이 평균 5.19%에서 56.65%로 뛰었어요. 글의 출처가 아니라 어휘 다양성이 판정을 좌우했다는 뜻이에요.
2026년 8월 공개된 Park 외 연구는 더 큰 규모로 이 문제를 다시 봤어요. 비원어민 원고와 원어민 교정본 135,389쌍을 13개 탐지기에 넣었더니 사람 글 오탐률이 탐지기마다 0.0%에서 100.0%까지 갈렸고, 같은 교정이 어떤 탐지기에서는 AI 점수를 올리고 다른 탐지기에서는 내렸어요. 연구진은 전문 교정 문체 자체가 탐지 결과를 흔드는 혼란 변수라고 결론 내렸어요.
낮은 오탐률도 대규모로 쓰면 억울한 사례가 생겨요
Mozilla 재단의 평가는 '오탐률 0.01%'를 내세운 Binoculars 탐지기를 공개 데이터셋으로 다시 시험해 약 0.7%의 오탐률을 얻었어요. 1만 건 중 1건이 아니라 약 140건 중 1건꼴로 사람이 억울하게 AI 사용자로 지목될 수 있다는 뜻이에요. 1% 안팎의 오탐률도 한 학교에서 수천 편의 과제를 검사하면 수십 명의 무고한 학생이 걸릴 수 있는 규모예요.
AI 휴머나이저는 탐지를 피할 수 있을까
AI 휴머나이저는 AI가 쓴 초안을 사람이 쓴 것처럼 다시 쓰는 도구예요. 문장 길이를 일부러 들쭉날쭉하게 만들고, 상투적인 연결어를 지우고, 구체적인 단어로 바꾸는 식이에요. 탐지기가 통계적 특징에 기대는 만큼, 그 특징을 바꾸면 판정도 바뀌어요.
간단한 재작성 프롬프트만으로도 탐지율이 떨어져요
전용 도구가 없어도 효과가 있었어요. 앞의 스탠퍼드 연구에서 ChatGPT-3.5로 만든 대학 입학 에세이 31편은 처음에 탐지율이 최대 100%였지만, '문학적인 표현으로 다듬어 달라'는 두 번째 프롬프트를 한 번 거치자 최대 13%로 떨어졌어요. 거꾸로 말하면 그 단계에서 AI 글의 약 87%를 놓친 셈이에요. 과학 초록에서도 탐지율이 최대 68%에서 28%로 낮아졌어요. Mozilla 평가에서도 '자연스러운 표현과 작은 실수를 넣어 달라'고 한 번 요청한 결과물이 사람 글로 판정됐어요.
전용 휴머나이저 모델의 등장
2026년 10월에는 허깅페이스에서 내려받아 로컬에서 돌리는 휴머나이저 모델도 주목받았어요. jialinyyzz/humanizer 모델 카드에 따르면 Google Gemma 4 12B를 미세조정한 120억 파라미터 모델로, 영어·중국어 초안을 다시 쓰고 Apache 2.0 라이선스로 공개됐어요. 제작자는 2026년 10월 2일 Originality.ai 탐지기의 가장 엄격한 설정으로 영어 재작성 210건을 검사해 11건(약 5%)만 AI로 표시됐다고 밝혔어요. 학습에 탐지기를 쓰지 않았다는 점도 강조해요.
같은 카드에는 한계도 적혀 있어요. 엄격한 LLM 채점기가 영어 재작성 420건 중 376건만 사실 오류가 없다고 판정했고, 나머지에서는 숫자·이름·날짜 같은 세부가 바뀌는 사례가 나왔어요. 제작자 스스로 '한 탐지기, 한 날짜의 측정이며 어떤 탐지 결과도 보장하지 않는다', '학교·고용주·출판사의 AI 규정을 따르라'고 적었어요. 이 수치는 제작자의 자체 평가라 독립 검증된 값이 아니라는 점도 함께 봐야 해요.
휴머나이저로 탐지를 피하는 것과 규정을 지키는 것은 다른 문제예요. AI 사용 공개를 요구하는 과제·기고·업무에서 사용 사실을 숨기면, 탐지에 걸리지 않더라도 나중에 작성 과정 확인이나 면담에서 문제가 될 수 있어요.
AI 코드 탐지는 글과 무엇이 다를까
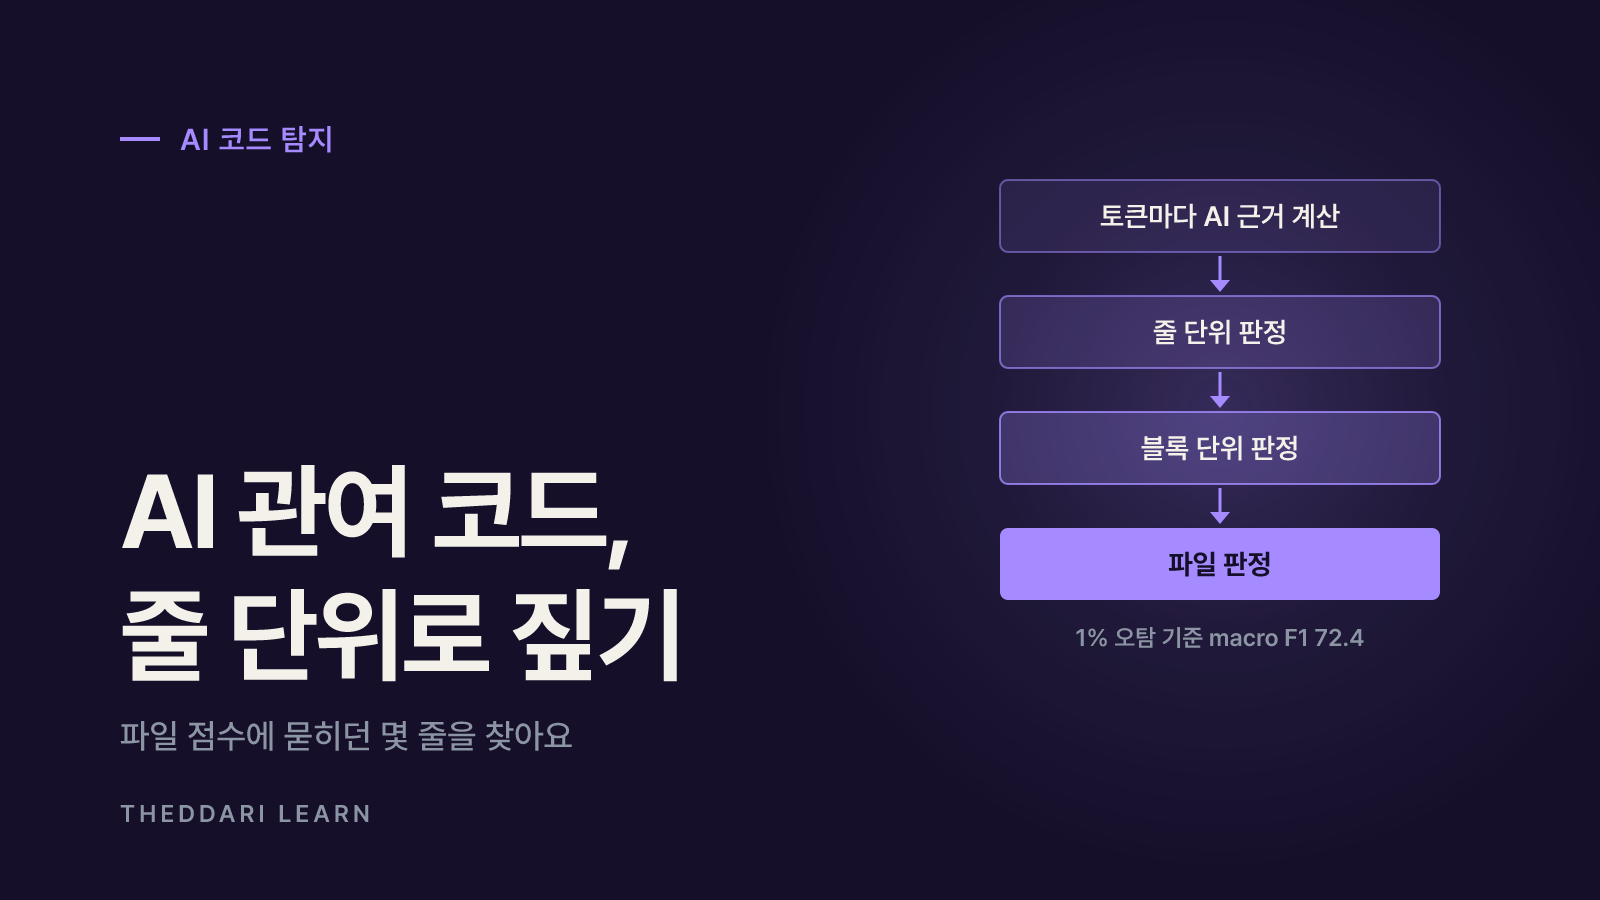
코드는 글보다 판별이 더 어려워요. 문법과 관용 패턴이 정해져 있어 사람과 AI의 코드가 원래 비슷하고, 실제 개발에서는 사람이 쓴 파일 안에 AI 자동완성 몇 줄이 섞이는 경우가 많아요. 파일 전체에 점수 하나를 매기면 몇 줄의 AI 흔적이 평균에 묻혀 버려요.
2026년 10월 20일 arXiv에 올라온 From Tokens to Files 논문은 이 문제를 겨냥해요. 코드 언어 모델에 기계 작성 코드용·사람 작성 코드용 어댑터를 따로 붙여 토큰마다 'AI다운 정도'를 계산하고, 이를 줄·블록·파일 단위로 모아 판정해요. 어느 줄이 AI 관여 부분인지 위치까지 짚으려는 접근이에요.
- 내부 테스트(AI 관여 파일 11,773개, 사람 파일 2,541개)에서 오탐률 1% 기준 macro F1 72.4를 보고했어요.
- 외부 공동 작성 벤치마크 HybridCodeAuthorship에서는 별도 적응 없이 줄 단위 F1 62.5로, 해당 벤치마크 논문이 보고한 최고치 56보다 높았다고 밝혔어요.
- 2022년 이전에 만들어진 저장소의 사람 작성 파일 19,445개에서 오탐률이 0.55~0.81%로 유지됐다고 해요.
수치는 의미 있지만 해석에 주의가 필요해요. 사전공개 논문이라 동료 심사와 독립 재현 전이고, 1% 안팎의 오탐률도 대형 조직의 수만 개 파일에 적용하면 상당한 수의 사람 코드가 걸려요. 코드에서는 탐지보다 커밋 기록, 코드 리뷰, AI 도구 사용 정책처럼 출처를 남기는 절차가 더 확실한 관리 수단이에요. 배포 전 검증법은 더따리의 다른 Learn 글에서도 다뤘어요.
탐지 결과를 받았을 때 확인할 것
탐지기를 쓰는 쪽이든 결과로 지목된 쪽이든, 점수 하나로 결론을 내리지 않는 것이 핵심이에요. 다음 순서로 확인하면 억울한 판정과 놓치는 사례를 함께 줄일 수 있어요.
- 1
어떤 탐지기·설정인지 확인
탐지기 이름, 버전, 엄격도 설정, 검사 날짜를 기록해요. 같은 글도 탐지기와 설정에 따라 판정이 정반대로 나올 수 있어요.
- 2
글의 조건이 탐지기 적용 범위인지 확인
1,000자 미만의 짧은 글, 영어가 아닌 글, 코드, 형식이 정해진 문서, 전문 교정을 거친 글은 오탐 위험이 큰 조건이에요.
- 3
탐지기 밖의 근거 모으기
문서 편집 기록, 날짜별 초안, 참고 자료 메모, 작성 중 대화처럼 작성 과정을 보여 주는 자료를 확인해요. 작성자에게 내용을 직접 설명하게 하는 것도 좋은 방법이에요.
- 4
규정과 공개 의무 확인
AI 사용이 금지인지, 허용하되 공개해야 하는지 기관 규정을 확인해요. 허용된 범위의 AI 사용이라면 탐지 점수 자체는 문제가 되지 않을 수 있어요.
- 5
판단은 사람이, 소명 기회와 함께
탐지 결과는 대화를 시작하는 근거로만 쓰고, 지목된 사람이 자료를 제출하고 설명할 기회를 보장해요.
AI 관련 소식과 새 도구가 빠르게 바뀌는 만큼, 탐지기·휴머나이저 논쟁의 흐름은 텔레그램 AI 채널 동향과 블로그 동향에서 함께 살펴볼 수 있어요.

정리: AI 작성 글 판별, 이렇게 접근하세요
- AI 탐지기 점수는 단서일 뿐 증거가 아니에요. OpenAI 분류기 철회와 여러 독립 평가가 이를 보여 줘요.
- 오탐은 비원어민, 정형화된 문체, 전문 교정 글에서 더 자주 생겨요. 탐지기마다 결과도 크게 달라요.
- 재작성 프롬프트와 휴머나이저로 탐지율은 쉽게 떨어지지만, 사실 오류와 규정 위반 위험이 남아요.
- AI 코드 탐지는 줄 단위로 위치를 짚는 연구가 나왔지만 2026년 10월 기준 검증 단계예요.
- 결국 신뢰할 만한 판별은 작성 과정 기록, 투명한 AI 사용 규정, 사람의 확인을 함께 쓰는 방식이에요.