목차8개 섹션
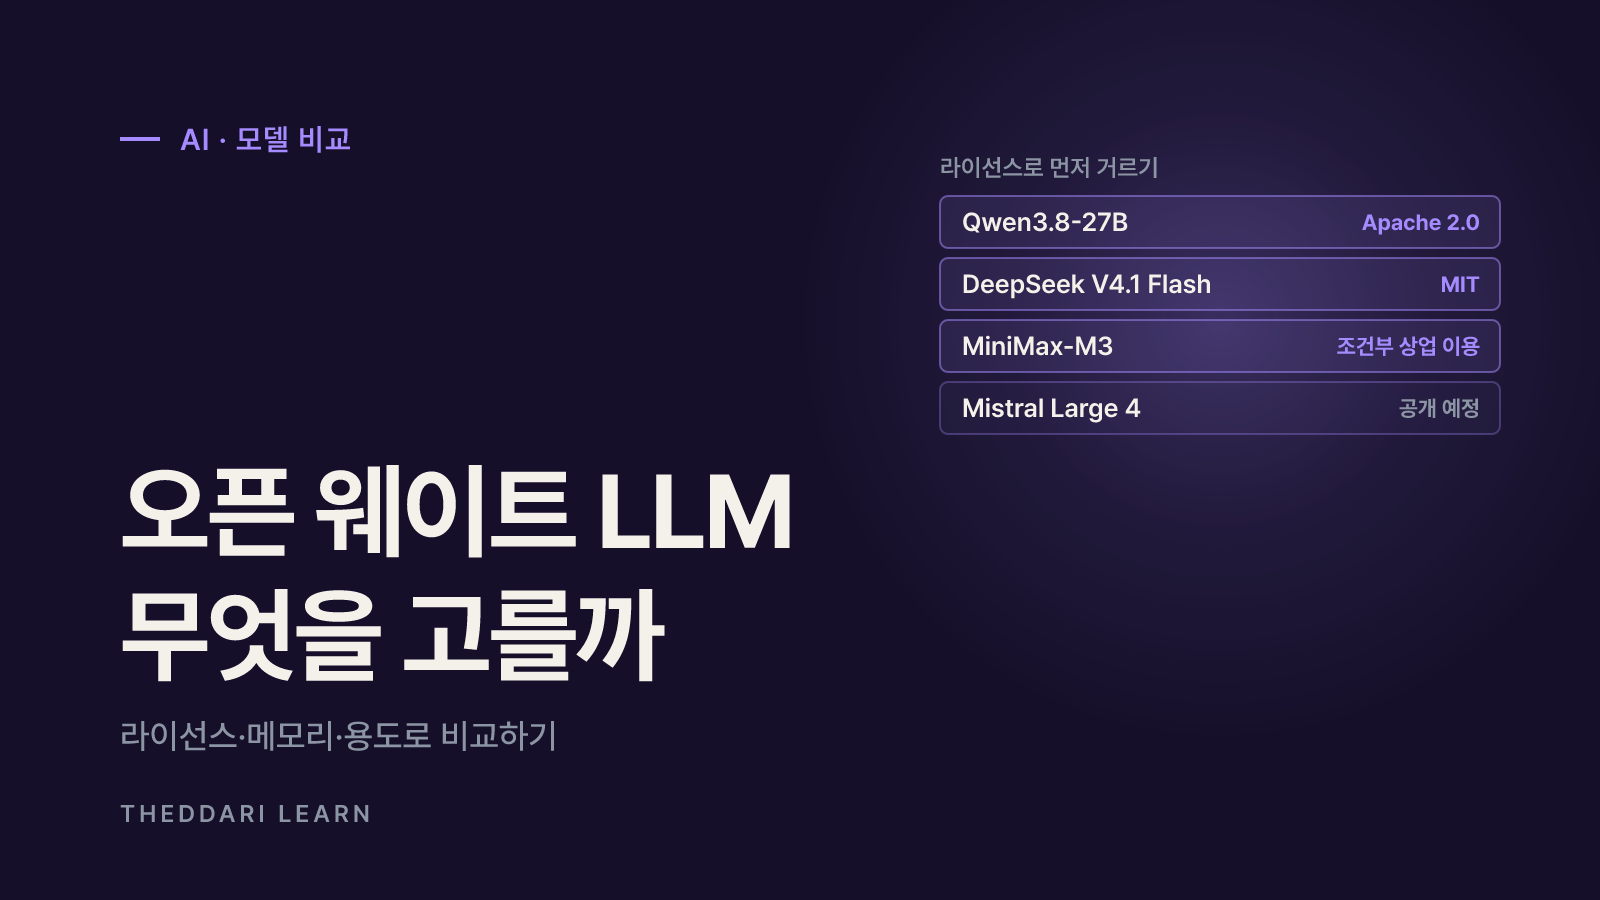
오픈소스 AI 모델을 고를 때는 어디서 돌릴지(내 GPU인지, API인지)와 상업적으로 써도 되는지를 먼저 정하면 후보가 빠르게 줄어요. 2026년 10월 기준으로 보면, 개인 PC나 GPU 한 대에서 돌릴 수 있는 현실적인 후보는 Qwen3.8-27B 하나이고, DeepSeek V4.1 Flash 1017·MiniMax-M3·Mistral Large 4는 서버급 GPU 여러 장이 필요해 대부분 API나 호스팅 서비스로 쓰게 돼요. 라이선스는 DeepSeek(MIT)과 Qwen(Apache 2.0)이 가장 자유롭고, MiniMax-M3는 상업 이용에 조건이 붙으며, Mistral Large 4는 가중치 공개 전이라 아직 확정되지 않았어요.
이 글은 각 모델을 따로 소개하기보다 고르는 기준에 집중해요. 수치는 2026년 10월 24일 각 회사의 Hugging Face 모델 카드와 공식 발표에서 확인한 값이며, 모델은 자주 업데이트되니 실제 도입 직전에 같은 페이지를 다시 확인해요.
오픈소스 AI 모델 비교표: 네 모델의 사양 한눈에 보기
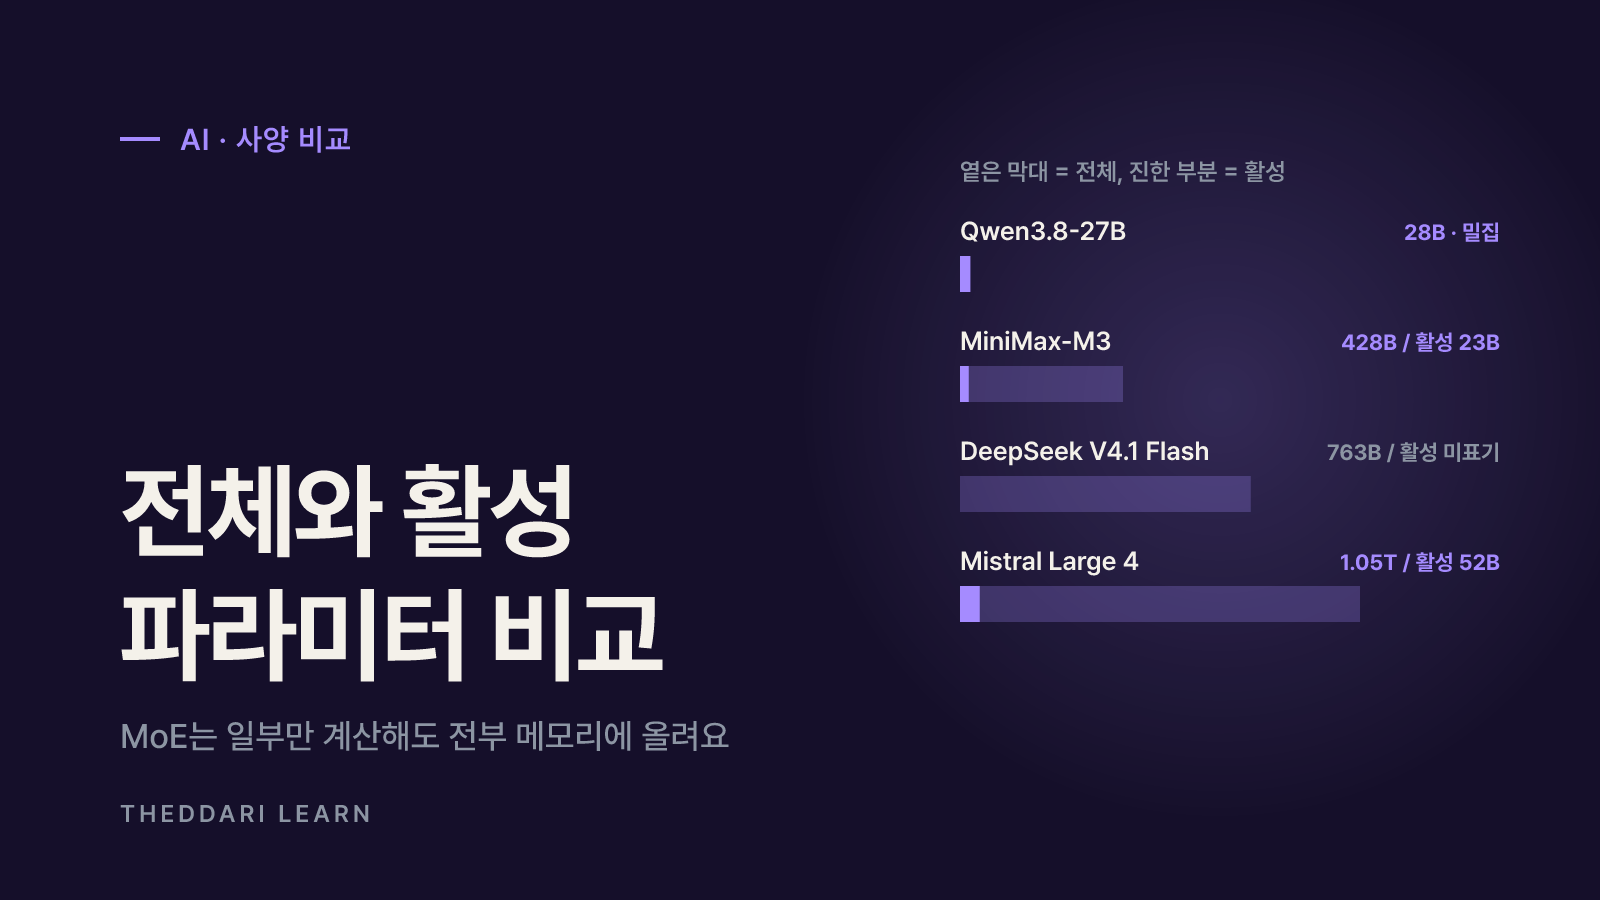
아래 표는 모델 카드에 적힌 값만 옮겼어요. '활성 파라미터'는 MoE(전문가 혼합) 구조에서 토큰 하나를 처리할 때 실제로 계산에 쓰이는 부분이에요. 밀집(dense) 모델인 Qwen3.8-27B는 전체가 매번 쓰여요.
구조
- Qwen3.8-27B
- 밀집, 이미지·영상 입력
- DeepSeek V4.1 Flash 1017
- MoE, 이미지 입력
- MiniMax-M3
- MoE, 텍스트·이미지·영상
- Mistral Large 4
- MoE, 이미지 입력
전체 파라미터
- Qwen3.8-27B
- 27B(비전 포함 약 28B)
- DeepSeek V4.1 Flash 1017
- 약 763B
- MiniMax-M3
- 약 428B
- Mistral Large 4
- 약 1.05T
활성 파라미터
- Qwen3.8-27B
- 27B(전체)
- DeepSeek V4.1 Flash 1017
- 카드에 명시 없음
- MiniMax-M3
- 약 23B
- Mistral Large 4
- 52B
컨텍스트
- Qwen3.8-27B
- 기본 262,144 토큰, YaRN으로 최대 100만
- DeepSeek V4.1 Flash 1017
- 권장 100만 토큰
- MiniMax-M3
- 100만 토큰
- Mistral Large 4
- 100만 토큰
라이선스
- Qwen3.8-27B
- Apache 2.0
- DeepSeek V4.1 Flash 1017
- MIT
- MiniMax-M3
- MiniMax Community License
- Mistral Large 4
- 가중치 공개 시 확인
공개 상태
- Qwen3.8-27B
- 가중치 공개
- DeepSeek V4.1 Flash 1017
- 가중치 공개
- MiniMax-M3
- 가중치 공개
- Mistral Large 4
- 10월 6일 API 프리뷰, 가중치는 10월 말 예정
출처: Qwen3.8-27B 모델 카드, DeepSeek-V4.1-Flash-1017 모델 카드, MiniMax-M3 모델 카드, Mistral Large 4 문서. DeepSeek 카드는 활성 파라미터 수를 본문에 적지 않았고, Hugging Face가 표시한 저장 크기(763B)만 확인됐어요.
라이선스 차이: 상업적으로 써도 될까?
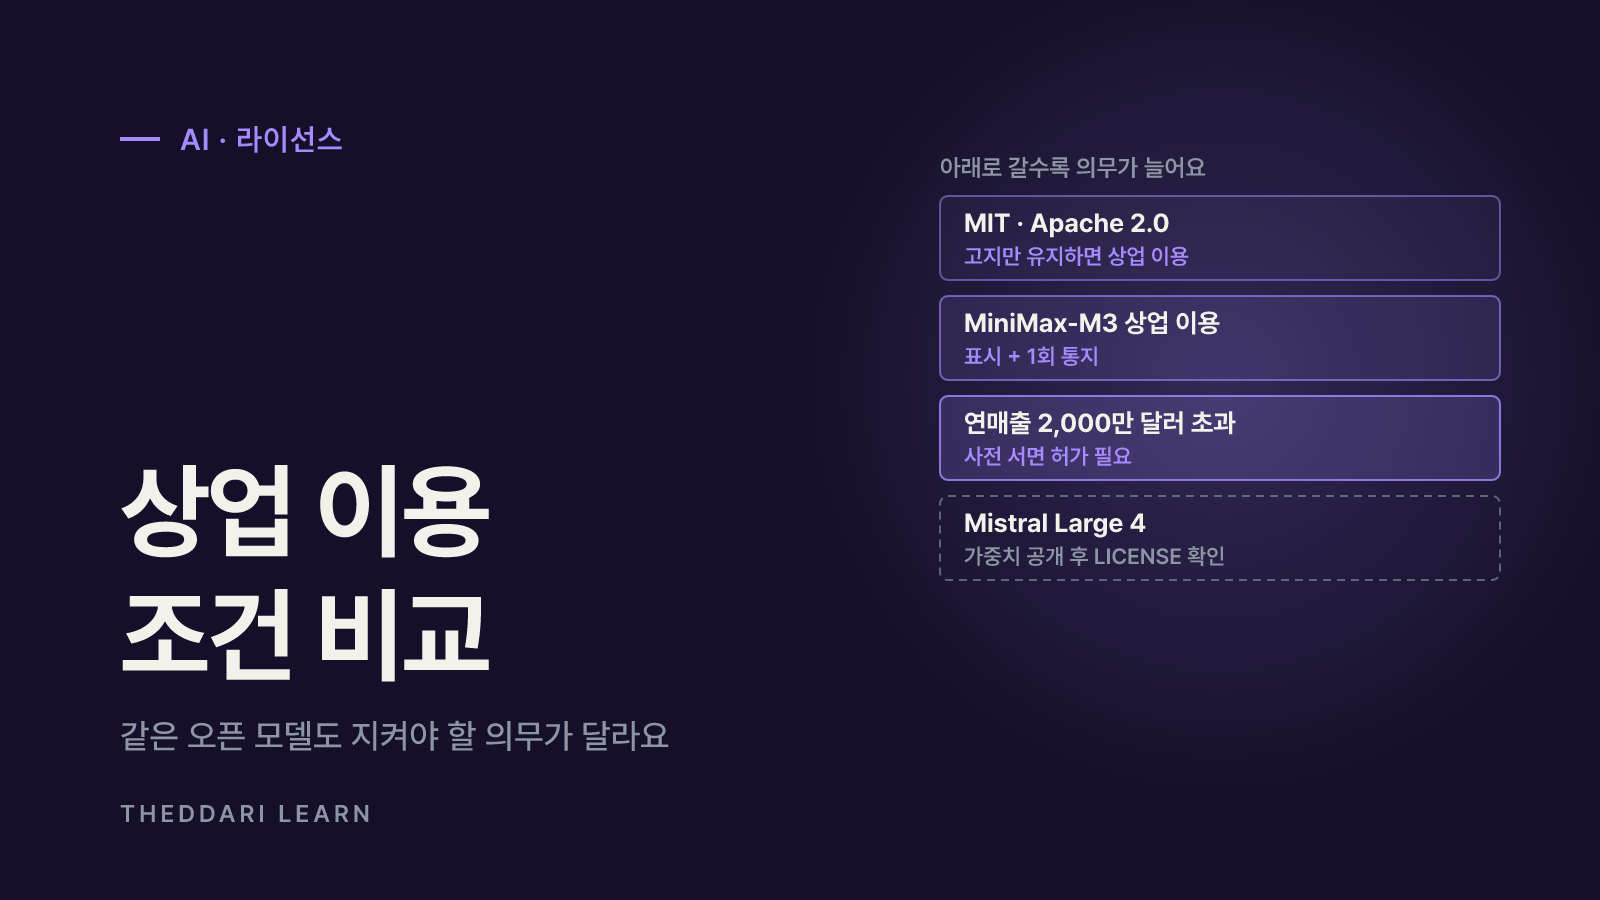
같은 '오픈' 모델이라도 라이선스가 다르면 할 수 있는 일이 달라져요. 서비스에 넣거나 파인튜닝한 모델을 배포할 계획이라면 성능보다 이 항목을 먼저 봐요.
- MIT (DeepSeek V4.1 Flash 1017): 저장소와 가중치 모두 MIT예요. 저작권·라이선스 고지만 유지하면 수정·상업 이용·재배포가 자유로워요.
- Apache 2.0 (Qwen3.8-27B): 상업 이용과 수정이 허용되고, 재배포할 때 라이선스 사본과 변경 고지를 포함해야 해요. 특허 관련 조항이 있어 기업에서 익숙한 라이선스예요.
- MiniMax Community License (MiniMax-M3): 라이선스 원문상 기본 허락은 비상업 목적이에요. 상업 이용 시 관련 페이지에 'Built with MiniMax M3'를 표시하고 MiniMax에 1회 통지해야 하며, 연매출 2,000만 달러를 넘는 제품·서비스는 사전 서면 허가가 필요해요. 군사 목적 지원 등 금지 용도 목록도 있어요.
- Mistral Large 4: 발표문은 오픈 웨이트로 10월 말에 가중치를 공개한다고만 밝혔고, 이번에 확인한 페이지에는 라이선스 이름이 없어요. 공개 후 저장소의 LICENSE 파일을 확인해야 해요.
MiniMax 라이선스는 파인튜닝·지시 튜닝 등으로 수정한 파생 모델을 상업적으로 배포하는 것도 '상업 이용'으로 정의해요. 내부 실험은 괜찮아도 고객에게 제공하는 순간 표시·통지 의무가 생겨요.
필요 GPU 사양: 가중치 메모리 계산법
로컬 LLM을 돌릴 수 있는지는 대략 파라미터 수 × 파라미터당 바이트 수로 가중치 크기를 먼저 계산해 보면 알 수 있어요. BF16은 2바이트, 8비트(FP8·INT8)는 1바이트, 4비트 양자화는 약 0.5바이트예요. 여기에 컨텍스트 길이에 비례하는 KV 캐시와 실행 여유분이 더 필요하니 아래 값은 최소치로 봐요.
Qwen3.8-27B (약 28B)
- BF16(2바이트)
- 약 56GB
- 8비트(1바이트)
- 약 28GB
- 4비트(0.5바이트)
- 약 14GB
MiniMax-M3 (약 428B)
- BF16(2바이트)
- 약 856GB
- 8비트(1바이트)
- 약 428GB
- 4비트(0.5바이트)
- 약 214GB
DeepSeek V4.1 Flash 1017 (약 763B)
- BF16(2바이트)
- 배포 파일이 FP8 혼합
- 8비트(1바이트)
- 약 763GB
- 4비트(0.5바이트)
- 약 382GB
Mistral Large 4 (약 1.05T)
- BF16(2바이트)
- 약 2.1TB
- 8비트(1바이트)
- 약 1.05TB
- 4비트(0.5바이트)
- 약 525GB
표에서 보듯 활성 파라미터가 작아도 메모리 요구량은 줄지 않아요. MiniMax-M3의 활성 파라미터는 약 23B로 Qwen3.8-27B보다 작지만, 어느 전문가가 선택될지 모르기 때문에 428B 전체를 메모리에 올려야 해요. MoE의 장점은 같은 메모리에서 토큰당 계산이 적어 빠르다는 점이에요.
- Qwen3.8-27B: 4비트 양자화 시 24GB급 GPU 한 장이나 통합 메모리가 넉넉한 PC에서 시도할 수 있어요. Hugging Face에는 이 모델의 양자화 파생 저장소가 1,544개 올라와 있어 llama.cpp·Ollama·LM Studio용 파일을 찾기 쉬워요.
- MiniMax-M3·DeepSeek V4.1 Flash: 공식 권장 경로가 SGLang·vLLM 같은 서빙 엔진이에요. 데이터센터 GPU 여러 장을 묶는 구성이 전제라 개인보다는 기업·연구실 환경에 맞아요.
- Mistral Large 4: 1조 파라미터급이라 자체 호스팅은 대규모 GPU 클러스터가 필요해요. 대부분은 API로 먼저 써 보게 돼요.
용도별로 고르는 법: 코딩·에이전트·문서·한국어
코딩·에이전트 작업
네 회사 모두 코딩과 장기 에이전트 작업을 강점으로 내세워요. Qwen3.8-27B는 생각(thinking) 모드가 기본으로 켜져 있고 reasoning_effort로 깊이를 low·medium·xhigh로 조절해요. MiniMax-M3는 thinking 값을 enabled·adaptive·disabled로 바꿀 수 있어요. 비용이 중요하면 추론 깊이를 낮출 수 있는 모델이 유리하지만, Qwen 카드는 낮은 추론 깊이가 오히려 재시도를 늘려 전체 시간과 토큰을 늘릴 수 있다고 경고해요.
긴 문서·멀티모달
MiniMax-M3, DeepSeek V4.1 Flash, Mistral Large 4는 100만 토큰 컨텍스트를 전제로 해요. Qwen3.8-27B는 기본 262,144 토큰이고 YaRN 설정으로 100만까지 늘릴 수 있지만, 카드에 따르면 정적 YaRN은 짧은 입력의 성능을 떨어뜨릴 수 있어 긴 문서가 필요할 때만 켜는 게 좋아요. 영상까지 다뤄야 하면 영상 입력을 명시한 Qwen3.8-27B나 MiniMax-M3를 먼저 봐요.
한국어 서비스
확인한 모델 카드 중 한국어 점수를 같은 조건으로 공개한 곳은 없어요. Mistral은 학습 데이터가 160개 이상 언어를 포함한다고 밝혔지만 언어별 수치는 없어요. 한국어가 핵심이라면 실제 업무 예시로 직접 평가하는 단계를 건너뛰지 마세요.
로컬 실행과 API 중 고르는 순서
- 1
데이터가 외부로 나가도 되는지 정하기
개인정보·사내 기밀을 다루면 자체 호스팅이나 지역(리전)을 지정할 수 있는 API가 필요해요. Mistral은 유럽에서 자체 운영하는 배포를 제공한다고 밝혔어요.
- 2
라이선스로 후보 거르기
상업 서비스라면 MIT·Apache 2.0 모델을 우선 검토하고, MiniMax-M3는 표시·통지 의무를 감당할 수 있을 때 포함해요.
- 3
하드웨어로 후보 거르기
위 메모리 계산표로 가진 장비에 올라가는지 확인해요. 올라가지 않는 모델은 API나 Hugging Face 추론 제공자로 시험해요.
- 4
실제 업무 예시로 평가하기
한국어 질문·코드 작업 등 실제 입력 30~50개를 같은 프롬프트로 돌려 정확도·속도·출력 길이를 기록해요.
- 5
비용 계산하기
API는 토큰당 요금(예: Mistral Large 4 프리뷰는 100만 토큰당 입력 1.36달러·출력 4.18달러)을, 로컬은 GPU·전기·운영 시간을 월 단위로 비교해요.
새 오픈 모델 소식은 짧은 주기로 나오니, AI 텔레그램 트렌드에서 Mistral Large 4 가중치 공개 같은 소식을 확인하고 블로그 트렌드에서 실제 사용 후기와 비교 글이 어떻게 쌓이는지 함께 보면 판단에 도움이 돼요.

벤치마크·배포에서 놓치기 쉬운 위험
- 하네스가 다른 점수는 비교하지 않기: 같은 DeepSWE 1.1이라도 Qwen 카드는 Claude Code 하네스로 42.2, DeepSeek 카드는 Mini-SWE-V2 하네스로 77.0, Mistral 발표는 61.7%를 제시해요. 평가 도구·설정이 달라 이 숫자들로 순위를 매기면 안 돼요.
- 자사 내부 벤치마크 구분하기: QwenSWEBench·CoWorkBench처럼 회사가 직접 만든 평가는 참고만 하고, 공개 벤치마크나 직접 평가를 우선해요.
- 원격 코드 실행 확인하기: MiniMax-M3는 Transformers로 불러올 때
trust_remote_code=True가 필요해요. 저장소 코드를 실행하는 것이니 버전을 고정하고 검토한 뒤 써요. - 채팅 템플릿 차이: DeepSeek V4.1 Flash 1017은 Jinja 채팅 템플릿을 제공하지 않고 별도 인코딩 코드(
encoding폴더, deepseek-recipe)를 써야 해서, 일반 도구에 그대로 넣으면 형식이 어긋날 수 있어요. - 프리뷰 모델의 변동성: Mistral Large 4는 아직 강화학습이 진행 중이라 성능이 계속 바뀐다고 밝혔어요. 프리뷰 결과로 장기 계약을 결정하지 않는 편이 안전해요.
정리하면, GPU 한 대로 로컬 실행이 목표면 Qwen3.8-27B, 가장 자유로운 라이선스의 대형 모델이 필요하면 DeepSeek V4.1 Flash 1017, 100만 토큰 멀티모달 에이전트를 조건부 상업 라이선스로 쓸 수 있으면 MiniMax-M3, 유럽 기반 API와 곧 공개될 가중치를 기다릴 수 있으면 Mistral Large 4가 출발점이에요. 어느 쪽이든 마지막 결정은 내 데이터로 직접 돌려 본 결과로 내려요.