목차8개 섹션
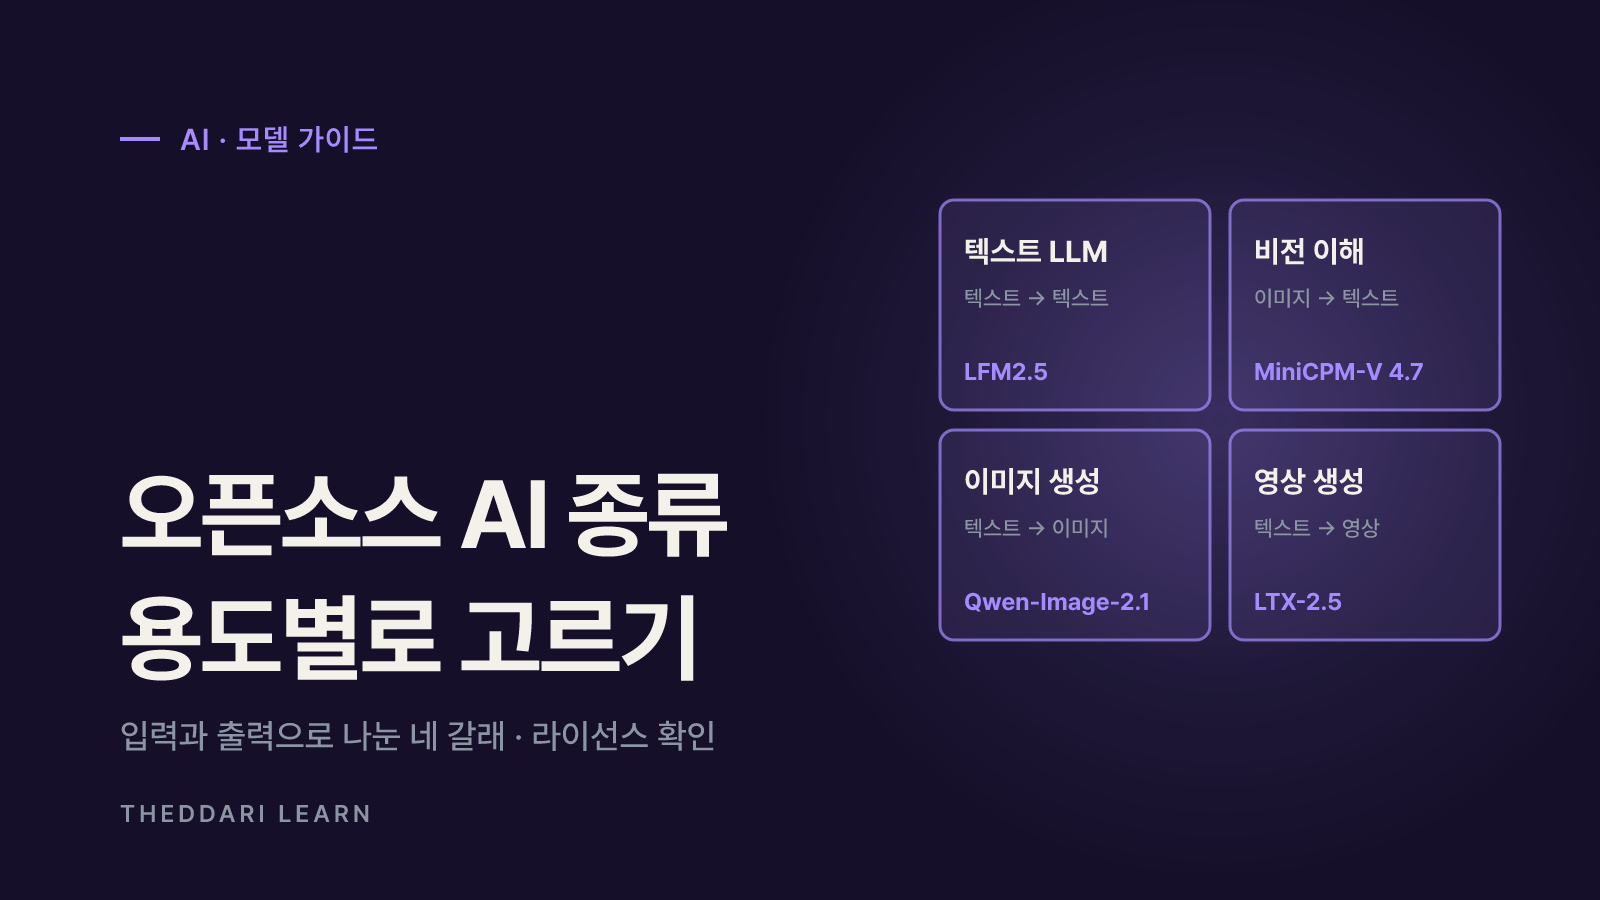
오픈소스 AI 종류는 '무엇을 넣고 무엇을 받느냐'로 나누면 가장 쉽게 고를 수 있어요. 글을 읽고 쓰는 텍스트 LLM, 이미지·영상을 보고 설명하는 비전 이해 모델(VLM), 글로 그림을 만드는 이미지 생성 모델, 글·이미지로 영상을 만드는 영상 생성 모델이 큰 네 갈래예요. 이 글은 2026년 10월 허깅페이스에서 많이 받는 모델 카드(Qwen·MiniCPM·LFM·LTX)를 직접 확인해 각 종류의 대표 예시와 크기·필요 사양·라이선스를 비교하는 기준을 정리했어요. 개별 벤치마크 순위보다 '내 용도에 맞는 종류를 먼저 고르는 법'에 집중해요.
오픈소스 AI 종류: 입력과 출력으로 나누는 네 갈래
허깅페이스의 모델 페이지에는 Text Generation, Image-Text-to-Text, Text-to-Image, Image-to-Video 같은 작업(task) 태그가 붙어 있어요. 이 태그가 곧 그 모델의 입력과 출력을 알려 줘요. 처음 고를 때는 모델 이름보다 이 태그를 먼저 보는 습관이 도움이 돼요.
텍스트 LLM
- 입력 → 출력
- 텍스트 → 텍스트
- 대표 용도
- 대화, 요약, 코딩, 에이전트 도구 호출
- 2026년 10월 예시
- LFM2.5-24B-A2B
비전 이해(VLM)
- 입력 → 출력
- 이미지·영상+텍스트 → 텍스트
- 대표 용도
- OCR, 문서 파싱, 사진 설명, 영상 요약
- 2026년 10월 예시
- Qwen3.8-27B, MiniCPM-V 4.7
이미지 생성
- 입력 → 출력
- 텍스트(+참조 이미지) → 이미지
- 대표 용도
- 포스터, 일러스트, 이미지 편집
- 2026년 10월 예시
- Qwen-Image-2.1-Turbo
영상 생성
- 입력 → 출력
- 텍스트·이미지·영상 → 영상(+오디오)
- 대표 용도
- 짧은 영상, 이미지 애니메이션
- 2026년 10월 예시
- LTX-2.5
이 밖에도 음성 인식(STT), 음성 합성(TTS), 검색용 임베딩 모델 같은 종류가 있지만, '오픈소스 AI 종류'를 찾는 대부분의 사용자는 위 네 갈래 중 하나를 원해요. 텍스트 LLM과 비전 이해 모델은 같은 실행 도구(vLLM, SGLang, llama.cpp, Ollama 등)를 많이 공유하고, 이미지·영상 생성은 Diffusers나 ComfyUI 같은 별도 도구를 쓰는 경우가 많아요.
오픈소스 AI 모델 비교: Qwen·MiniCPM·LFM·LTX 한눈에 보기
아래 표는 2026년 10월 각 모델 카드에서 직접 확인한 정보만 정리했어요. 속도 수치는 모두 개발사가 자기 조건에서 측정한 값이라 내 환경에서 그대로 나온다는 뜻은 아니에요.
Qwen3.8-27B
- 종류
- 텍스트+이미지·영상 이해
- 크기
- 27B dense
- 눈여겨볼 점
- 기본 컨텍스트 262,144토큰, 최대 100만 토큰까지 확장 안내, 사고(thinking) 모드 기본
- 라이선스
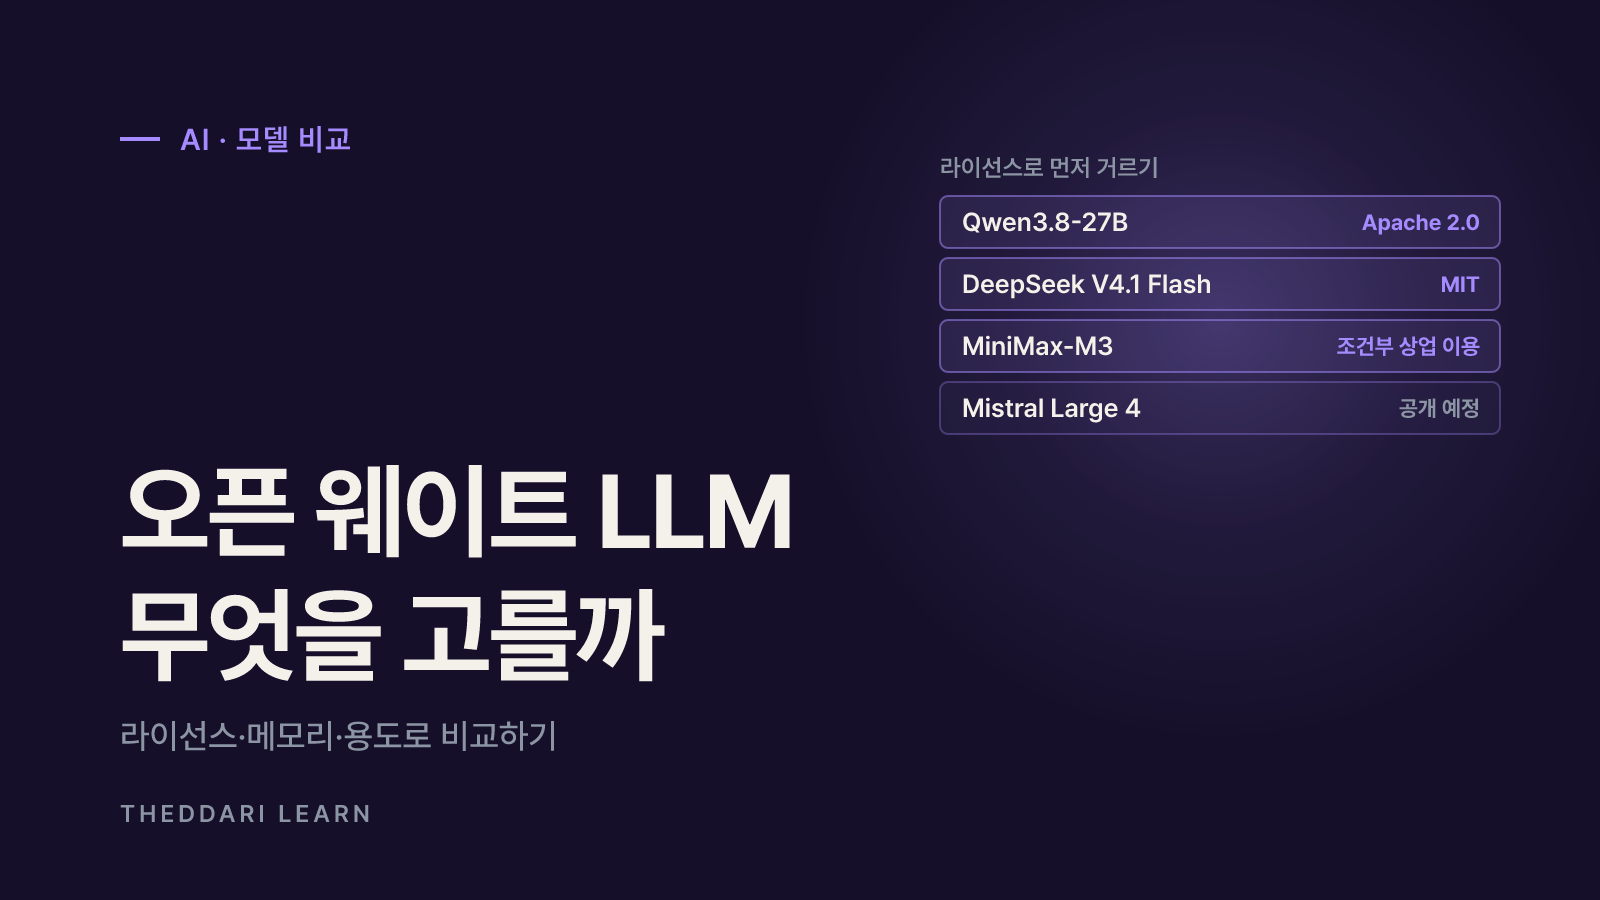
- Apache 2.0
MiniCPM-V 4.7
- 종류
- 비전 이해
- 크기
- 35B-A3B MoE, 1B
- 눈여겨볼 점
- 단일·다중 이미지와 영상 이해, iOS·Android·HarmonyOS 기기 배포 지원
- 라이선스
- Apache 2.0
LFM2.5-24B-A2B
- 종류
- 텍스트 전용 추론·에이전트
- 크기
- 총 24.0B, 활성 2.45B
- 눈여겨볼 점
- 컨텍스트 131,072토큰, 한국어 포함 16개 언어, 항상 사고 후 답변
- 라이선스
- lfm1.0(Liquid AI 자체 라이선스)
Qwen-Image-2.1-Turbo
- 종류
- 이미지 생성·편집
- 크기
- 7B
- 눈여겨볼 점
- 8단계 디노이징으로 빠르게 생성, Diffusers로 실행
- 라이선스
- Qwen Research License
LTX-2.5
- 종류
- 영상+오디오 생성
- 크기
- 22B DiT + Gemma 4 12B 텍스트 인코더
- 눈여겨볼 점
- 텍스트·이미지·영상 입력, 동기화된 오디오, 멀티샷 생성
- 라이선스
- LTX-2.x Community License
텍스트 LLM: LFM2.5-24B-A2B
LFM2.5-24B-A2B 모델 카드는 이 모델을 기기 안에서 빠르고 비공개로 돌리는 에이전트용 추론 모델로 소개해요. 총 24.0B 중 토큰당 약 2.45B만 계산하고, llama.cpp Q4_K_M 양자화·4K 입력 조건에서 Apple M5 Max 기준 초당 184토큰을 냈다고 밝혀요. 다만 개발사 스스로 '지식이 많이 필요한 작업에는 단독으로 쓰지 말고 검색·RAG와 함께 쓰라'고 권해요. 혼자서 백과사전처럼 답하는 모델이 아니라 도구를 부르며 일하는 모델이라는 뜻이에요.
비전 이해: Qwen3.8-27B와 MiniCPM-V 4.7
Qwen3.8-27B는 이미지와 영상을 기본으로 이해하는 27B dense 비전-언어 모델이에요. 코딩·문서·에이전트 작업까지 한 모델로 하고 싶을 때 후보가 돼요. MiniCPM-V 4.7은 휴대폰·태블릿 같은 기기 안 실행에 초점을 맞췄어요. 모델 카드는 35B-A3B 버전이 iPhone 17 Pro Max에서 3GB 메모리로 초당 13토큰 이상을 냈다고 설명하고, 더 가벼운 1B 버전도 함께 공개해요. 언어 백본은 Qwen3.5·Qwen3.6, 비전 모듈은 SigLIP2를 썼다고 밝히고 있어요.
이미지·영상 생성: Qwen-Image-2.1-Turbo와 LTX-2.5
Qwen-Image-2.1-Turbo는 Qwen-Image-2.1을 가속한 체크포인트로, 같은 7B 구조에서 8단계 디노이징만으로 이미지 생성과 편집을 해요. LTX-2.5는 텍스트·이미지·영상 입력으로 영상과 동기화된 오디오를 함께 만드는 오픈웨이트 모델이에요. 22B 트랜스포머에 Gemma 4 12B 기반 텍스트 인코더, 영상·오디오 VAE, 업스케일러가 파일별로 나뉘어 배포돼서 한 개 파일보다 준비할 것이 많아요.
크기와 필요 사양 읽는 법: dense와 MoE
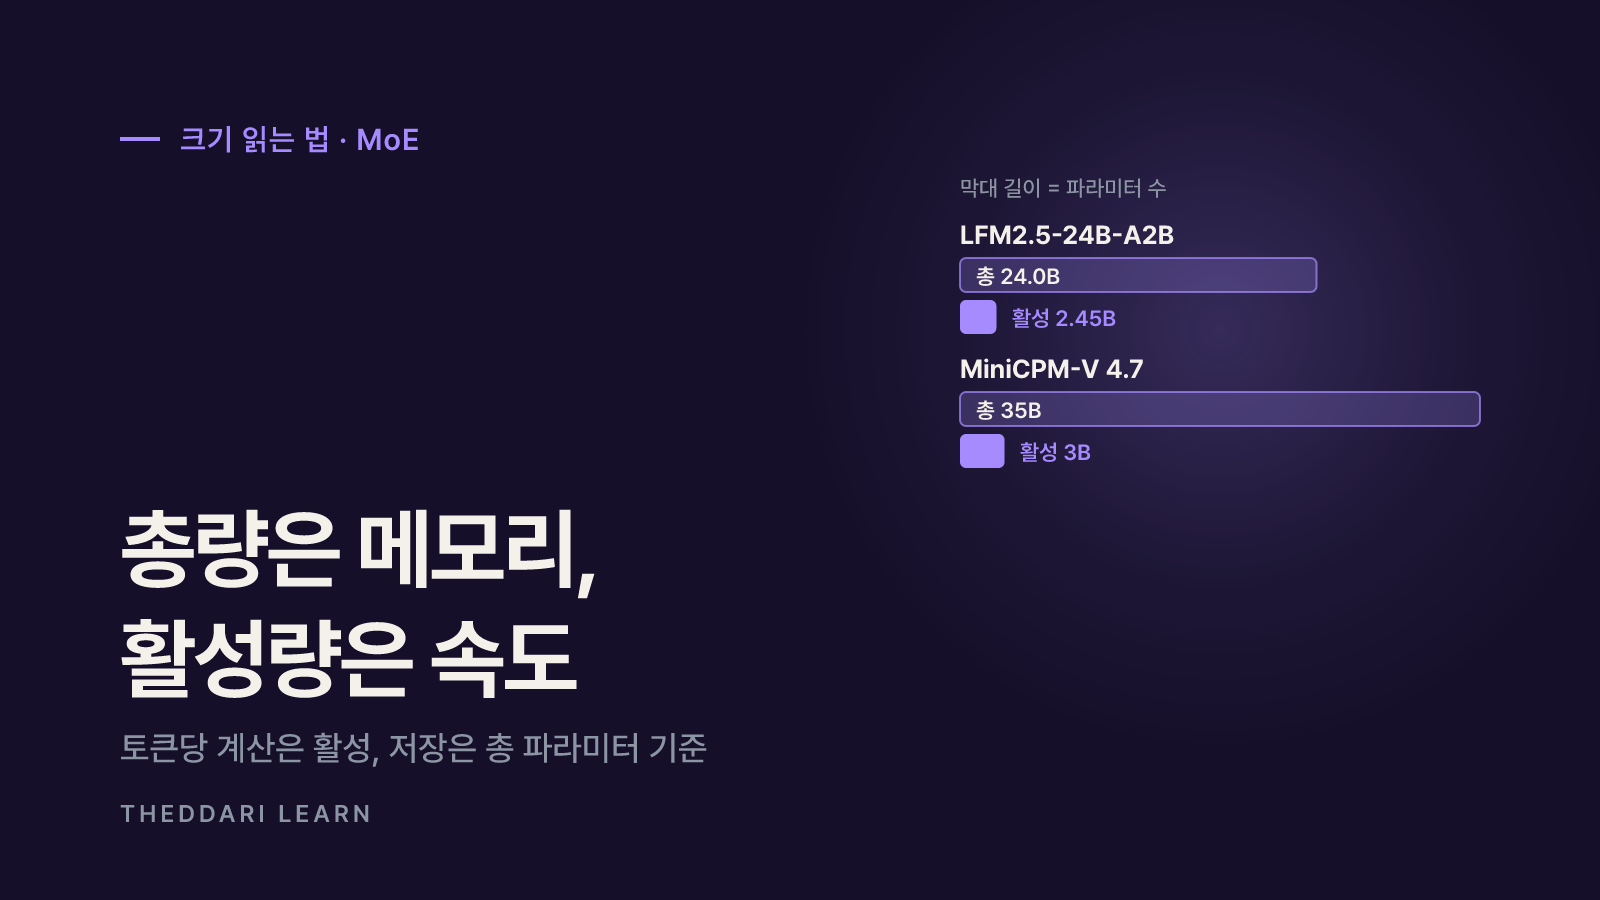
모델 이름의 숫자는 파라미터 수예요. 27B처럼 숫자 하나면 모든 파라미터를 매번 계산하는 dense 모델이고, 24B-A2B처럼 A가 붙으면 총 24B 중 토큰당 약 2B만 활성화하는 MoE(Mixture of Experts) 모델이에요.
- 활성 파라미터 → 속도: 토큰당 계산량이 적어서 같은 총 크기의 dense 모델보다 빠르게 답할 수 있어요.
- 총 파라미터 → 저장·메모리: MiniCPM-V 4.7 모델 카드도 MoE는 토큰마다 다른 전문가를 고를 수 있어 저장 부담이 활성 파라미터에 한정되지 않는다고 설명해요. 메모리 계획은 총 크기와 양자화 파일 크기로 세워요.
- 양자화 버전 → 실제 필요량: GGUF(llama.cpp·Ollama), AWQ·GPTQ(GPU), FP8, MLX(Apple Silicon) 같은 버전이 있으면 원본 BF16보다 메모리를 크게 줄일 수 있어요. 대신 품질이 조금 떨어질 수 있어요.
- 생성 모델은 구성 요소를 모두 더해요: LTX-2.5처럼 트랜스포머·텍스트 인코더·VAE·업스케일러가 분리된 모델은 각 파일이 모두 메모리에 올라가야 해요. 모델 카드가 fp8 변환과 CPU 오프로드를 저VRAM 방법으로 따로 안내하는 이유예요.
모델 이름의 GGUF·A3B·Q4_K_M 같은 표기가 낯설다면 먼저 각 기호가 무엇을 뜻하는지 정리한 뒤 파일을 고르세요. 같은 모델이라도 양자화 파일에 따라 필요 메모리가 크게 달라져요.
라이선스 확인: '오픈'이어도 조건은 다르다
오픈소스 AI 모델 비교에서 가장 자주 놓치는 부분이 라이선스예요. 같은 회사의 모델이어도 종류마다 라이선스가 다를 수 있어요. 2026년 10월 모델 카드 기준으로 정리하면 이래요.
Apache 2.0
- 해당 예시
- Qwen3.8-27B, MiniCPM-V 4.7
- 확인할 점
- 상업 이용·수정·재배포가 넓게 허용되지만 저작권·라이선스 고지 의무가 있어요
자체 공개 라이선스
- 해당 예시
- LFM2.5-24B-A2B(lfm1.0)
- 확인할 점
- 표준 라이선스가 아니므로 상업 이용 조건·기업 규모 기준을 원문에서 확인해요
연구용 라이선스
- 해당 예시
- Qwen-Image-2.1-Turbo(Qwen Research License)
- 확인할 점
- 상업 서비스에 넣기 전 허용 범위와 별도 허가 필요 여부를 확인해요
매출 기준 커뮤니티 라이선스
- 해당 예시
- LTX-2.5(LTX-2.x Community License)
- 확인할 점
- 연 매출 1천만 달러 미만은 상업·운영 이용이 무료, 그 이상은 유료 상업 계약이 필요해요. 매출은 계열사를 포함한 전체 기준이에요
LTX-2.5 모델 카드는 파인튜닝한 모델을 넘길 때 유료 라이선스가 필요할 수 있다고도 적고 있어요. 또 내려받기 전에 허깅페이스 계정 정보 공유에 동의해야 하는 게이트 모델이에요. 이런 조건은 '써도 되느냐'뿐 아니라 '만든 결과물을 고객에게 넘겨도 되느냐'까지 영향을 줘요.
용도별로 무엇을 고를까: 4단계 선택 순서
- 1
1. 입력과 출력을 한 문장으로 적기
예: '스캔한 계약서(이미지)를 넣고 요약(텍스트)을 받고 싶다'면 비전 이해 모델이에요. '상품 설명(텍스트)으로 홍보 영상을 만들고 싶다'면 영상 생성 모델이에요. 이 문장이 정해지면 후보 종류가 하나로 줄어요.
- 2
2. 실행 위치와 하드웨어 정하기
휴대폰·노트북 안에서 돌려야 하면 MiniCPM-V 4.7 1B나 LFM2.5처럼 기기 내 실행을 내세우는 작은 모델·MoE가 유리해요. 서버 GPU가 있으면 Qwen3.8-27B 같은 dense 모델이나 영상 생성 모델도 검토할 수 있어요. 필요 메모리는 실제 양자화 파일 크기로 확인해요.
- 3
3. 라이선스로 걸러 내기
개인 실험인지, 회사 서비스인지, 결과물을 고객에게 넘기는지에 따라 같은 모델도 쓸 수 있는지가 달라져요. 상업 서비스라면 Apache 2.0 계열을 먼저 보고, 연구용·매출 기준 라이선스는 조건을 문서로 남겨 두세요.
- 4
4. 내 데이터로 직접 시험하기
모델 카드의 벤치마크는 개발사가 정한 조건에서 나온 숫자예요. 한국어 문서, 내 업무 이미지, 실제 프롬프트 10~20개로 직접 비교해야 체감 품질과 속도를 알 수 있어요.
새로 공개되는 모델 소식을 계속 따라가고 싶다면 더따리의 AI 텔레그램 트렌드에서 많이 언급되는 모델을 확인하고, 블로그 트렌드에서 실제 사용 후기를 찾아보는 방법도 있어요. 트렌드는 화제성을 보여 줄 뿐 품질을 보장하지 않으니 위 4단계와 함께 써요.

로컬 AI 모델을 고르기 전 확인할 위험
- 벤치마크 비교의 함정: LFM2.5 모델 카드는 에이전트 지표에서 강점을 보이지만 일부 코딩 지표에서는 비교 모델보다 낮은 값을 함께 공개해요. 한두 개 점수만 보고 '최고 모델'로 판단하지 않아요.
- 개발사 측정 속도: 초당 토큰 수는 특정 칩·양자화·입력 길이 조건의 값이에요. 같은 모델도 실행 도구 버전과 설정에 따라 크게 달라져요.
- 생성 모델의 출력 위험: LTX-2.5 모델 카드는 사실 정보를 제공하지 못하고, 편향을 키우거나 부적절한 결과를 만들 수 있다고 한계를 명시해요. 공개 전 사람이 결과물을 검토해요.
- 비공식 변형 모델: 원본 이외에 다른 사람이 올린 파인튜닝·양자화 모델은 라이선스와 안전성이 원본과 다를 수 있어요. 가능하면 공식 조직 계정의 파일을 먼저 써요.
- 빠른 세대 교체: 이미지·영상 분야는 몇 달 만에 새 버전이 나와요. 서비스에 넣는다면 모델을 바꿔 끼울 수 있게 구성해 두는 편이 안전해요.
정리하면, 오픈소스 AI 모델은 '어떤 회사 모델이 제일 좋은가'보다 '내 입력과 출력에 맞는 종류가 무엇인가'를 먼저 정해야 실패가 적어요. 종류를 정한 뒤 하드웨어로 크기를, 라이선스로 사용 범위를 거르고, 마지막으로 내 데이터로 직접 시험해 결정하세요.