Mistral Large 4 로컬 실행 사양과 라이선스: 1T MoE 직접 돌리기
Mistral Large 4 오픈 웨이트를 직접 돌리려면? 1T·A52B MoE 구조, FP8·NVFP4·GGUF 용량별 필요 GPU, 상업 이용과 MaaS 라이선스 조건을 정리했어요.
목차7개 섹션
핵심 요약
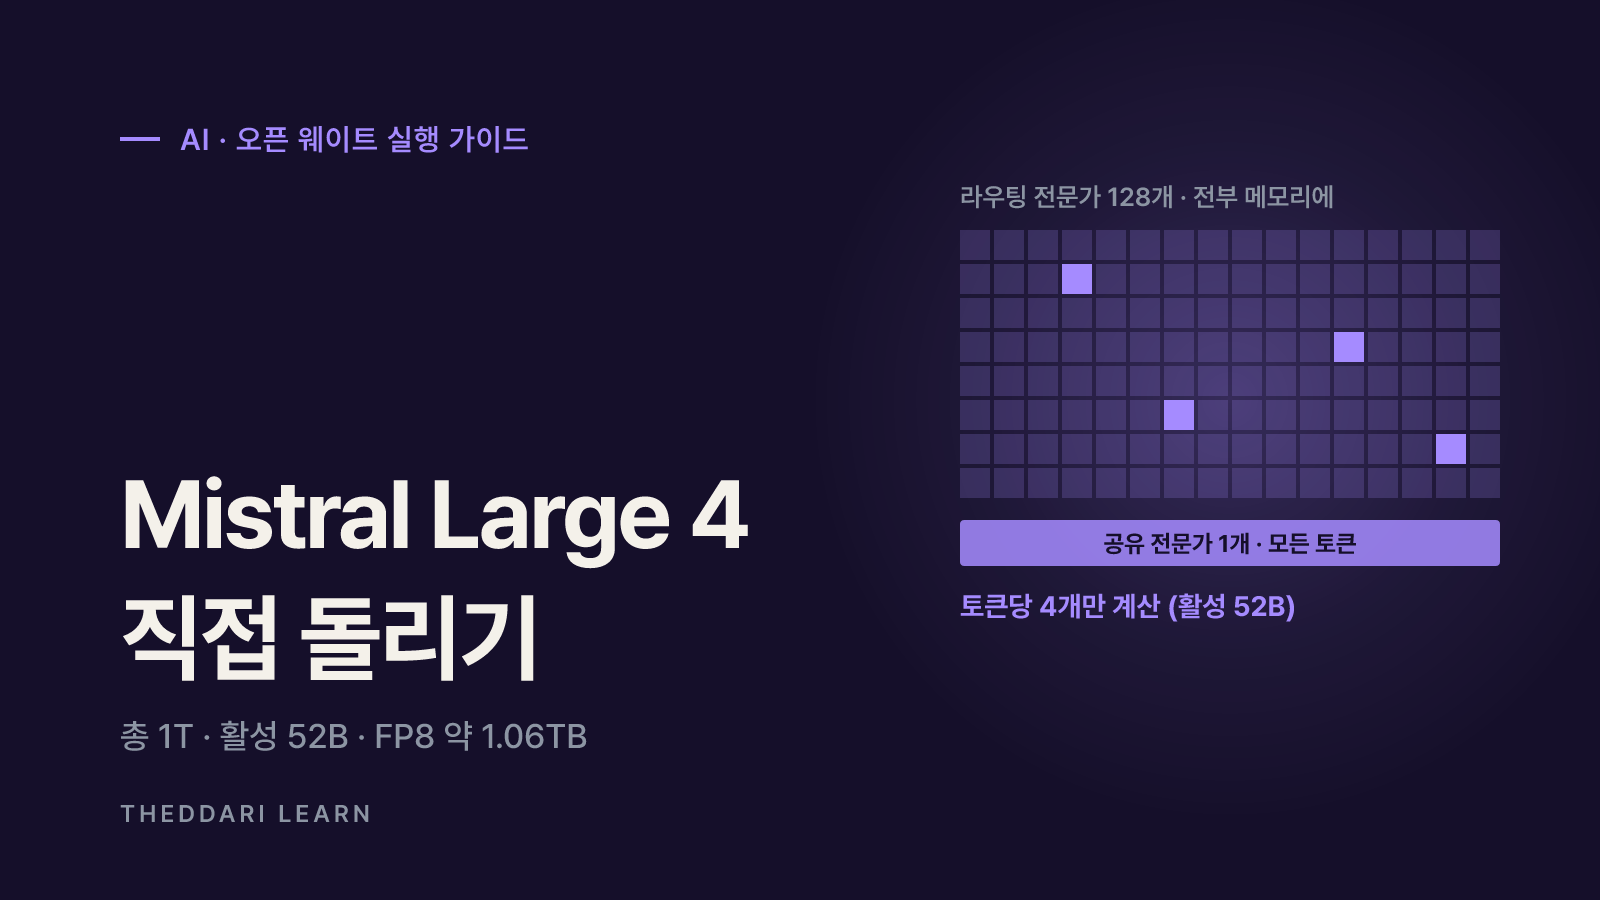
- Mistral Large 4는 총 약 1T 파라미터, 토큰당 활성 49B(임베딩·출력층 포함 52B)인 MoE 모델이며 2026년 10월 29일 가중치가 허깅페이스에 공개됐어요.
- 토큰마다 계산은 52B 규모지만 128개 전문가 전체를 메모리에 올려야 해서, 공식 FP8 체크포인트만 약 1.06TB, NVFP4는 약 610GB예요.
- vLLM 레시피가 검증한 구성은 GB300·B300·B200 8장, H200 16장(2노드), MI350X 8장 같은 데이터센터급 GPU예요.
- GGUF로는 Q4_K_M 635GB, Q2_K 381GB, IQ2_XXS 298GB까지 줄어 512GB 통합 메모리 장비에 올릴 수 있지만 속도·품질은 따로 검증해야 해요.
- 라이선스는 수정 MIT로 상업 이용·미세조정이 가능하지만, 제3자에게 모델을 서비스로 제공하는 MaaS 사업자는 별도 상업 라이선스가 필요해요.
Mistral Large 4를 직접 돌리려면 1T 파라미터 전체를 담을 메모리가 먼저 필요해요. 미스트랄은 2026년 10월 29일 개선된 Mistral Large 4(별칭 Le Chonk)의 가중치를 허깅페이스에 공개했어요. 토큰마다 계산하는 파라미터는 약 52B이지만, 공식 FP8 체크포인트 크기만 약 1.06TB라서 데이터센터급 GPU 8장 이상이 출발점이에요. 이 글은 2026년 10월 기준 공식 발표·모델 카드·vLLM 레시피·라이선스 원문을 근거로 구조, 필요 사양, 양자화 선택지, 상업 이용 조건을 정리해요. 모델 특징과 API 사용법보다 자체 호스팅을 할지 판단하는 데 초점을 둬요.
Mistral Large 4 오픈 웨이트의 1T·A52B MoE 구조
모델 이름의 1T-A52B는 총 파라미터 약 1조(1T), 토큰당 활성 파라미터 약 52B라는 뜻이에요. 모델 카드에 따르면 정확히는 토큰당 활성 49B이고, 임베딩과 출력층을 포함하면 52B예요. 구조는 128개의 라우팅 전문가(routed expert) 중 토큰마다 4개를 고르고, 모든 토큰이 함께 쓰는 공유 전문가 1개를 더하는 세분화된 MoE(Mixture-of-Experts)예요. vLLM 레시피는 72개 층, DSA 희소 인덱서를 쓰는 MLA 어텐션, 층 간 KV 공유, Pixtral 계열 비전 인코더가 들어 있다고 설명해요.
MoE를 처음 접하면 활성 52B만 보고 52B급 밀집(dense) 모델처럼 가볍게 돌릴 수 있다고 생각하기 쉬워요. 하지만 라우터가 어떤 전문가를 고를지는 토큰마다 달라서 128개 전문가 전체가 언제든 호출될 수 있어요. 그래서 메모리 요구량은 총 1T에 가깝고, 활성 파라미터는 토큰당 연산량과 생성 속도에 더 가깝게 영향을 줘요. 같은 메모리를 가진 장비라면 1T 밀집 모델보다 빠르게 토큰을 만들 수 있다는 점이 MoE의 장점이에요.
총 파라미터
- 공식 자료 내용
- 약 1T
- 직접 돌릴 때 의미
- 가중치 전체를 메모리에 올려야 해요
활성 파라미터
- 공식 자료 내용
- 토큰당 49B(임베딩·출력층 포함 52B)
- 직접 돌릴 때 의미
- 토큰당 연산량과 속도에 영향을 줘요
전문가 구성
- 공식 자료 내용
- 라우팅 전문가 128개 중 4개 + 공유 1개
- 직접 돌릴 때 의미
- 전문가 병렬(EP) 설정이 성능에 중요해요
컨텍스트
- 공식 자료 내용
- 1,048,576 토큰(1M)
- 직접 돌릴 때 의미
- vLLM은 256k까지 검증했어요
입력·출력
- 공식 자료 내용
- 텍스트·이미지 입력, 텍스트 출력
- 직접 돌릴 때 의미
- 비전 인코더 파일이 별도로 필요할 수 있어요
추론 모드
- 공식 자료 내용
- low·medium·high(기본 high)
- 직접 돌릴 때 의미
- GGUF 안내상 추론을 완전히 끌 수는 없어요
컨텍스트 숫자도 구분해서 읽어야 해요. 체크포인트는 100만 토큰 위치를 지원하지만, vLLM 레시피는 256k까지 검증했고 --max-model-len을 그 값으로 잡아 두었어요. 1M 컨텍스트 서빙은 검증되지 않았다고 명시돼 있으니, 긴 문서 작업을 계획한다면 KV 캐시 메모리와 함께 별도 시험이 필요해요. 체크포인트에는 3토큰 블록을 미리 제안하는 DSpark 추측 디코딩 헤드도 들어 있어요. 모델 카드는 대상 모델 단독 대비 최대 1.9배 처리량을 측정했다고 밝히지만, 실제 효과는 하드웨어와 작업 종류에 따라 달라진다고 덧붙여요.
직접 돌리려면 얼마나 필요할까: 체크포인트별 용량과 GPU
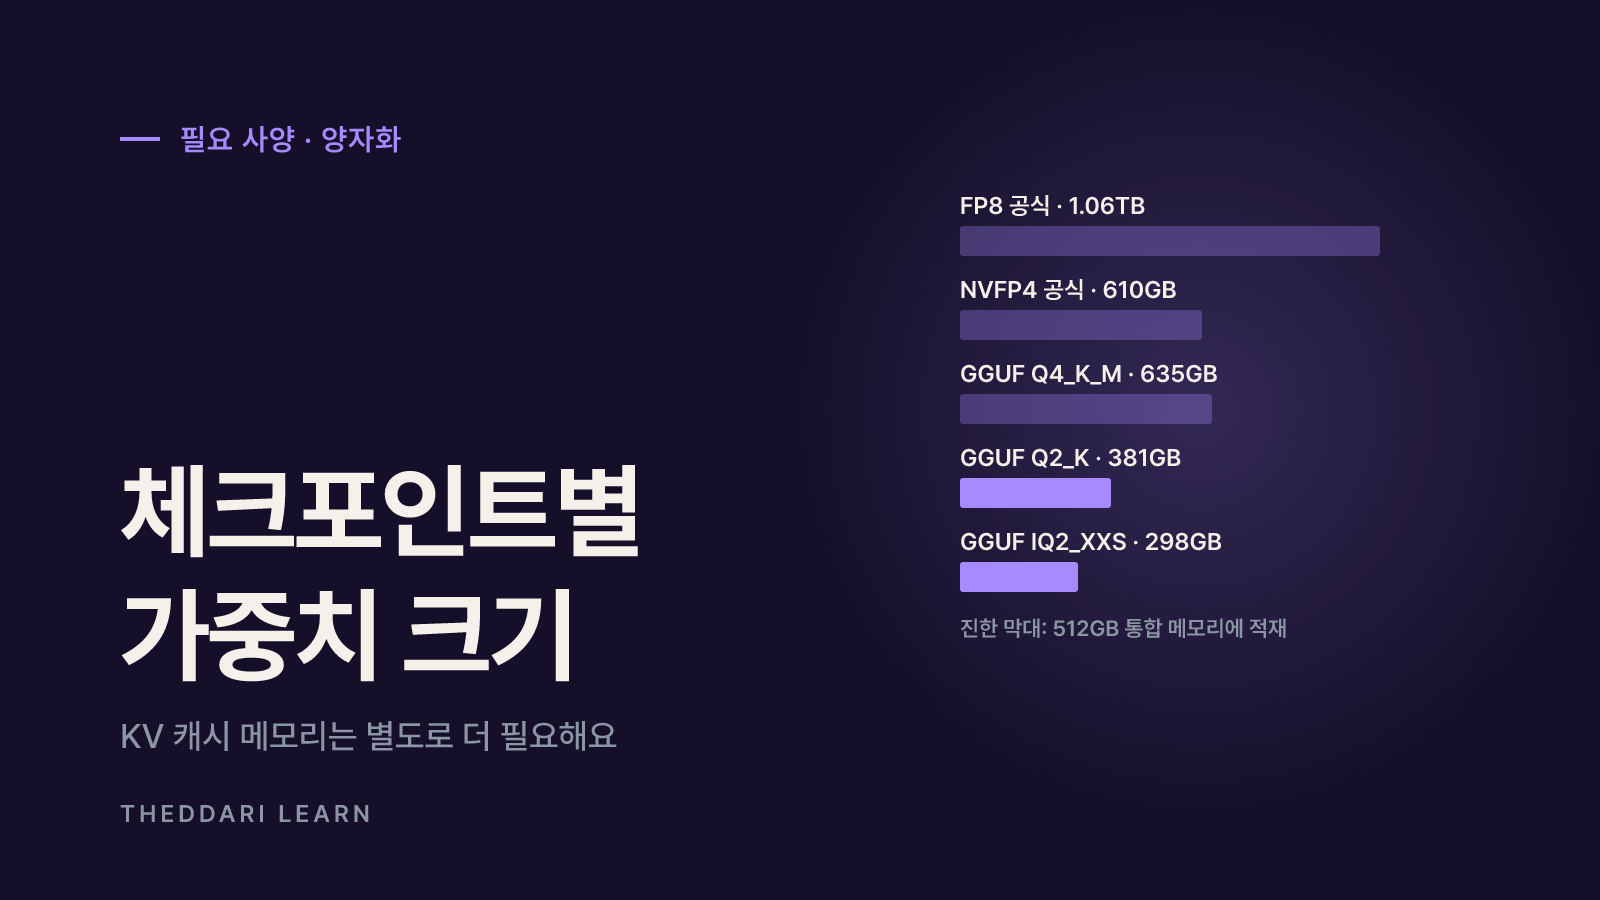
공식 저장소의 기본 가중치는 블록 단위 스케일링을 쓰는 FP8이에요. vLLM 레시피 기준으로 체크포인트별 용량과 검증 하드웨어는 아래와 같아요. 커뮤니티 GGUF는 ggml-org 저장소가 공개한 크기예요. 표의 용량은 가중치 파일 기준이며, 실제 서빙에는 KV 캐시·활성화·런타임 여유 메모리가 더 필요해요.
FP8 공식(기본)
- 가중치 크기
- 약 1.06TB
- 검증·안내된 환경
- GB300·B300 8장, H200 2노드×8장, MI350X 8장
NVFP4 공식
- 가중치 크기
- 약 610GB
- 검증·안내된 환경
- GB300(4장 트레이 1개 또는 8장), B200·B300 8장
AMD MXFP4(Quark)
- 가중치 크기
- 약 578GB
- 검증·안내된 환경
- MI350 계열, 4장에 한 복제본
GGUF Q8_0
- 가중치 크기
- 1.12TB
- 검증·안내된 환경
- 원본에 가까운 품질
GGUF Q4_K_M
- 가중치 크기
- 635GB
- 검증·안내된 환경
- 4비트 양자화
GGUF Q2_K
- 가중치 크기
- 381GB
- 검증·안내된 환경
- 512GB 통합 메모리에 적재 가능
GGUF IQ2_XXS
- 가중치 크기
- 298GB
- 검증·안내된 환경
- imatrix 보정, 512GB 통합 메모리에 적재 가능
GPU당 부담으로 바꿔 보면 감이 더 잡혀요. 레시피는 8장으로 나눌 때 FP8은 GPU당 약 128GiB, NVFP4는 약 76GiB의 가중치가 필요하다고 적어요. 그래서 80GB급 H100 8장 한 노드로는 FP8을 담기 어렵고, 141GB급 H200도 FP8은 16장(TP16 또는 PP2×TP8)으로 검증됐어요. NVFP4는 블랙웰 세대 GPU를 대상으로 하므로, 호퍼 세대 장비라면 FP8과 다중 노드 구성을 기준으로 견적을 잡아야 해요.
소프트웨어 준비 상태도 확인해요
2026년 10월 레시피 기준으로 정식 vLLM 릴리스나 nightly 휠에는 아직 Mistral Large 4 지원이 들어가지 않았고, 전용 도커 이미지 vllm/vllm-openai:mistral-large-4(AMD는 ROCm 전용 이미지)를 써야 해요. mistral_common[image] 1.13.0 이상도 필요해요. 모델 카드는 vLLM을 권장하고 SGLang, Transformers(main 브랜치), llama.cpp 지원도 안내해요. 도구 호출과 추론 내용 분리를 쓰려면 vLLM에서 --tool-call-parser mistral과 --reasoning-parser mistral 옵션이 필요해요. 미세조정은 Axolotl, Unsloth, TRL 경로가 소개돼 있어요.
양자화를 고를 때의 기준
- 품질 우선: 공식 FP8 또는 NVFP4. 레시피는 NVFP4가 TP8에서 FP8보다 토큰당 1.09~1.18배 빠르고 KV 용량이 약 1.5배라고 측정했어요.
- 장비 제약 우선: GGUF Q4_K_M(635GB)부터 시작하고, 더 줄여야 할 때만 Q2_K·IQ2_XXS를 검토해요.
- 2비트 양자화는 전문가 가중치를 강하게 줄인 대신 어텐션·공유 전문가 등은 Q8_0으로 남긴 구성이에요. 원본 벤치마크 점수가 그대로 유지된다고 가정하지 않아요.
- 이미지 입력이 필요하면 GGUF와 별도로 약 3.4GB의 mmproj(비전 인코더) 파일을 받아야 해요.
오픈소스 LLM 라이선스: 상업 이용과 MaaS 조건
Mistral Large 4는 Apache 2.0이 아니라 Mistral Ecosystem Open-Weight License로 배포돼요. 라이선스 원문은 MIT를 수정한 형태로, 모델을 사용·복제·수정·배포·판매하고 추가 학습과 파생 모델 제작을 허용해요. 저작권 고지와 허가 문구는 모델의 모든 사본이나 상당 부분에 포함해야 해요.
핵심 조건은 두 번째 조항이에요. 라이선스 이용자나 그 계열사가 MaaS(Model as a Service) 사업을 운영한다면, 모델이나 파생 모델을 상업 목적으로 쓰기 전에 미스트랄과 별도 상업 라이선스를 맺어야 해요. MaaS는 API나 호스팅 엔드포인트 등으로 제3자에게 추론이나 사후 학습 접근을 주면서 그 제3자가 입력·파라미터·학습 데이터를 의미 있게 통제할 수 있는 경우를 말해요.
사내 전용 챗봇·코딩 도구
- 원문상 MaaS 조건 적용
- 적용 안 됨(내부 사용)
- 확인할 점
- 외부에 모델을 제공하지 않는지
특정 기능에 모델을 내장한 최종 사용자 제품
- 원문상 MaaS 조건 적용
- MaaS 정의에서 제외
- 확인할 점
- 사용자가 모델 자체를 자유롭게 다룰 수 있는지
다른 곳에 호스팅된 모델로 요청만 중계
- 원문상 MaaS 조건 적용
- MaaS 정의에서 제외
- 확인할 점
- 직접 호스팅하지 않는지
외부 고객용 범용 추론 API 판매
- 원문상 MaaS 조건 적용
- MaaS 사업자는 별도 계약 필요
- 확인할 점
- 계열사 포함 여부까지 검토
미스트랄 공식 제품을 통한 사용
- 원문상 MaaS 조건 적용
- 적용 안 됨
- 확인할 점
- 해당 서비스 약관을 따로 확인
원문에는 모델과 출력이 아무 보증 없이 있는 그대로 제공된다는 조항도 있고, 모델 카드는 제3자의 지식재산권 등 권리를 침해하는 방식으로 쓰지 말라고 적어요. 라이선스는 2026년 10월 29일 최초 커밋 기준이에요. 이후 개정될 수 있으니 실제 배포 전에는 저장소의 최신 LICENSE 파일을 다시 확인하고, 사업 구조가 MaaS 경계에 걸린다면 법률 검토를 받는 것이 안전해요.
Mistral Large 4 로컬·자체 호스팅 vs API, 판단 순서
- 1
용도와 데이터 조건을 먼저 적어요
데이터가 외부로 나가면 안 되는지, 모델을 미세조정해야 하는지, 외부 고객에게 제공할지를 정리해요. 데이터 주권이나 맞춤 학습이 핵심이 아니라면 자체 호스팅의 이점이 줄어들어요.
- 2
API 비용과 비교해요
미스트랄 발표 기준 API 가격은 입력 100만 토큰당 0.70달러, 캐시 입력 0.07달러, 출력 2.10달러예요. 예상 토큰 사용량으로 월 비용을 계산하고, GPU 8장 이상 서버의 임대·구매·전력·운영 인력 비용과 비교해요.
- 3
하드웨어와 체크포인트를 맞춰요
블랙웰 GPU라면 NVFP4, 호퍼(H200)라면 FP8 다중 노드, AMD MI350이라면 MXFP4 경로를 우선 검토해요. 통합 메모리 장비는 GGUF 저비트 버전으로 시험하되 속도 측정을 먼저 해요.
- 4
작은 범위로 검증해요
레시피의 기본 명령과 256k 이하 컨텍스트로 시작해 실제 업무 프롬프트로 품질·지연 시간을 측정해요. 모델 카드도 로컬 서빙 결과가 기대에 못 미치면 Mistral API 사용을 권한다고 적어요.
- 5
라이선스와 보안 설정을 점검해요
서비스 형태가 MaaS에 해당하는지 확인하고, 엔드포인트 인증·로그·접근 통제를 설정해요. 자체 호스팅에서는 가드레일 업데이트도 직접 반영해야 해요.
새 오픈 웨이트 모델은 공개 직후 서빙 엔진 버전, 양자화 파일, 커뮤니티 측정값이 빠르게 바뀌어요. 더따리 AI 텔레그램 트렌드에서 관련 채널 반응을, 블로그 트렌드 대시보드에서 실사용 후기 흐름을 함께 살펴보면 업데이트를 놓치지 않는 데 도움이 돼요. 다만 커뮤니티 수치는 측정 환경이 제각각이라 공식 레시피와 직접 측정값으로 다시 확인해요.

직접 돌리기 전에 알아 둘 위험과 한계
- 벤치마크 수치는 대부분 미스트랄 자체 발표 또는 파트너 평가예요. 정식 기술 보고서는 아직 공개 예정 상태라 독립 검증 결과를 기다리는 것이 좋아요.
- 보안 분야 성능이 강조되지만, 미스트랄은 실제 공격에 악용될 가능성을 관찰해 가드레일을 계속 수정하겠다고 밝혔어요. 자체 호스팅에서는 이런 업데이트를 운영자가 챙겨야 해요.
- 1M 컨텍스트, DSpark와 파이프라인 병렬 조합, ROCm의 일부 기능은 레시피에서 아직 검증되지 않았거나 지원되지 않아요.
- 가중치 다운로드만 1TB 안팎이라 저장소 용량, 네트워크 시간, 버전 관리 계획이 필요해요.
정리하면 Mistral Large 4 오픈 웨이트는 데이터 통제와 맞춤 학습이 필요한 조직에 의미 있는 선택지이지만, 개인 PC로 가볍게 돌리는 모델은 아니에요. 메모리는 1T 기준, 속도는 52B 기준으로 생각하고, 체크포인트·하드웨어·라이선스 형태를 함께 맞춰 본 뒤 작은 검증부터 시작하세요.
자주 묻는 질문
Mistral Large 4를 일반 게이밍 PC에서 돌릴 수 있나요?
활성 파라미터가 52B면 52B 모델만큼의 메모리면 되지 않나요?
회사 내부 챗봇이나 코딩 도구로 쓰면 상업 라이선스를 따로 받아야 하나요?
맥 스튜디오 같은 512GB 통합 메모리 장비에서는 돌아가나요?
출처·참고 자료
- 1