목차7개 섹션
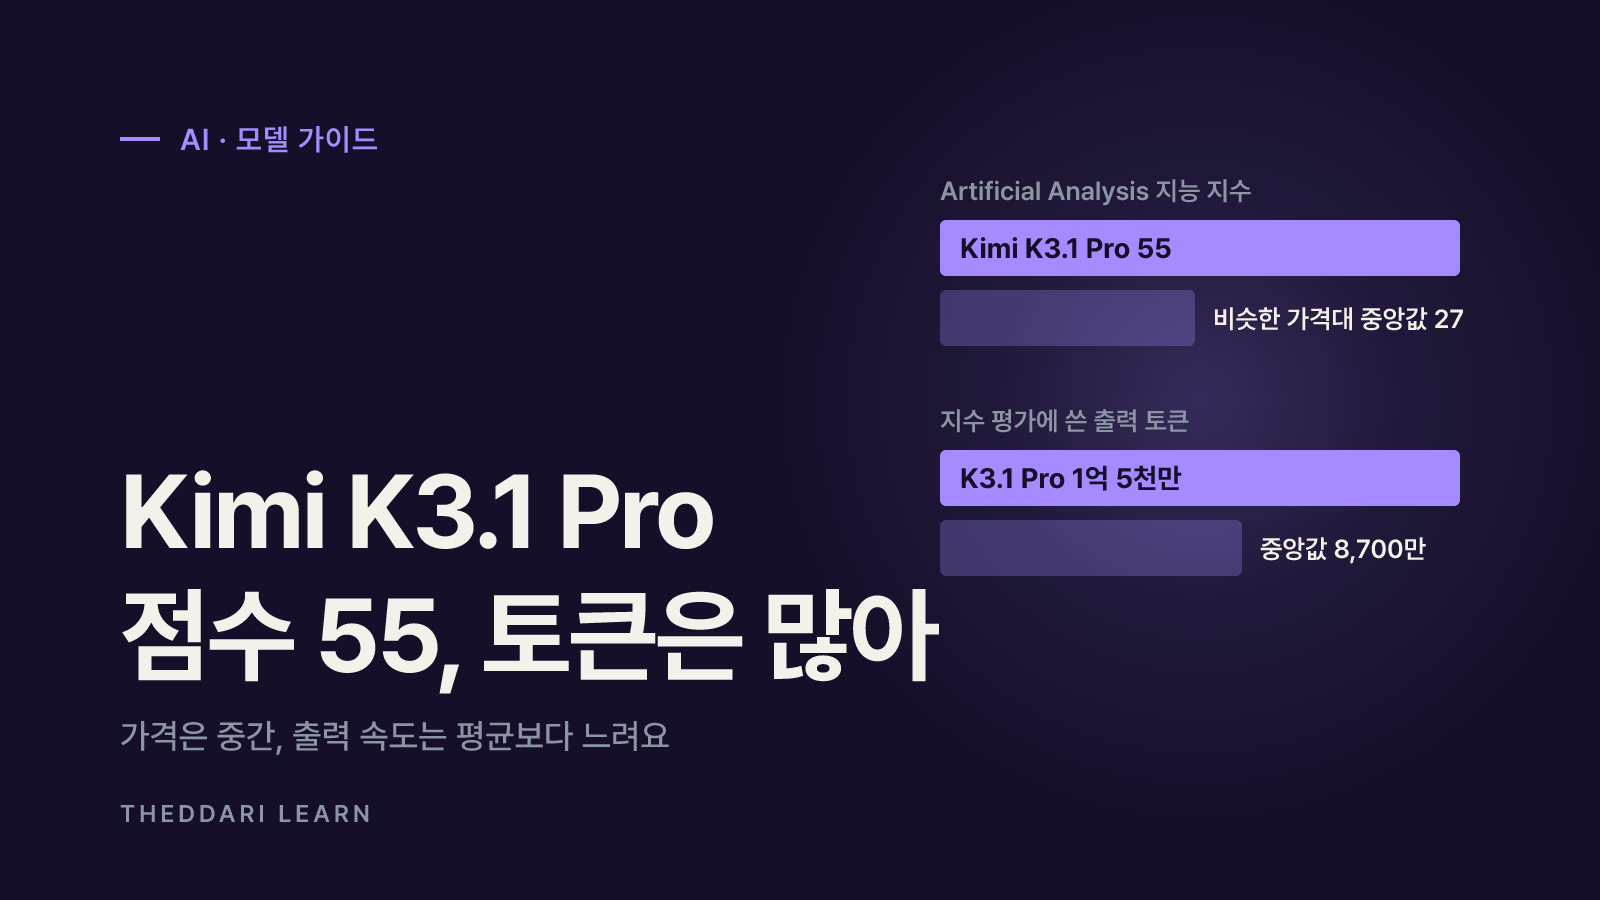
Kimi K3.1 Pro는 중국 AI 기업 문샷 AI(Moonshot AI)가 2026년 10월 23일 공개한 K3.1 시리즈의 첫 모델이에요. 독립 평가 기관 Artificial Analysis는 이 모델에 지능 지수 55점을 매겼고, 비슷한 가격대 모델의 중앙값 27보다 크게 높다고 평가했어요. 결론부터 말하면 성능 점수는 최상위권, 가격은 중간 수준, 속도는 평균보다 느리고 토큰을 많이 쓰는 모델이에요. 이 글은 2026년 10월 24일 기준 Kimi 공식 블로그와 Artificial Analysis 모델 페이지, Kimi API 문서를 직접 확인해 정리했어요.
Kimi K3.1 Pro는 어떤 모델인가요
문샷 AI는 Kimi K3.1 Pro를 Kimi K3를 기반으로 사후 학습(post-training) 연산을 크게 늘린 버전이라고 설명해요. 수백 개 분야에서 강화학습을 함께 돌릴 수 있도록 학습 인프라 전반을 다시 손봤다는 것이 공식 설명이에요. 공개한 강점 분야는 코딩, 3D 제작, 금융 리서치, 그리고 여러 단계를 스스로 처리하는 에이전트 작업이에요.
- 컨텍스트: 100만 토큰(정확히는 1,048,576토큰). K3 시리즈 공통이에요.
- 입력·출력: 텍스트와 이미지를 입력받고 텍스트로 답해요. API에서는 동영상 파일 입력 예시도 제공해요.
- 규모: 공식 문서는 '3T급(3조 파라미터급)'이라고 표현하고, Artificial Analysis는 2.8조 파라미터로 표기해요.
- 추론 모델: 생각 과정(thinking)이 항상 켜져 있고 끌 수 없어요. 대신
reasoning_effort를 low·high·max 중에서 고르며 기본값은 max예요. - 고속 버전: Kimi K3.1 Pro Highspeed는 같은 모델을 2~3배 빠르게 제공한다고 소개됐어요.
- 공개 범위: 지금은 Kimi 앱·Kimi Work·Kimi Code·Kimi API로 제공되고, 전체 가중치는 2026년 11월 4일까지 공개 예정이라고 밝혔어요.
'오픈 웨이트' 표기에 주의하세요. 문샷은 오픈 웨이트 모델이라고 소개하지만, 2026년 10월 24일 확인한 Artificial Analysis 페이지는 가중치가 아직 공개되지 않아 이 모델을 비공개(Proprietary)로 분류해요. 로컬 실행이나 자체 서버 배포를 계획한다면 가중치와 라이선스가 실제로 공개된 뒤 판단해야 해요.
Artificial Analysis 점수 55는 무엇을 뜻할까
Artificial Analysis 지능 지수(Intelligence Index) v4.3.2는 하나의 시험이 아니라 10개 평가의 가중 평균이에요. 방법론 문서에 따르면 에이전트 30%, 코딩 20%, 과학 추론 20%, 일반 30%로 나뉘고, 에이전트 작업에 무게를 더 둬요. 또 이 지수는 주로 영어·텍스트 기반이라 이미지 입력이나 다국어 성능은 따로 평가해요.
에이전트(30%)
- 포함 평가
- AA-Briefcase v1.1, GDPval-AA v2.1, AutomationBench-AA
- 무엇을 보나
- 여러 파일을 다루는 실무형 과제, SaaS 업무 자동화
코딩(20%)
- 포함 평가
- Terminal-Bench 4.0, SciCode
- 무엇을 보나
- 터미널 작업 수행, 과학 계산 코드
일반(30%)
- 포함 평가
- AA-Omniscience, GDP.pdf, AA-LCR v1.1
- 무엇을 보나
- 지식 정확도·환각, 긴 PDF 추론, 장문 맥락
과학 추론(20%)
- 포함 평가
- Humanity's Last Exam, CritPt
- 무엇을 보나
- 고난도 지식·물리 추론
순위와 중앙값을 함께 읽어야 해요
Artificial Analysis 모델 페이지는 Kimi K3.1 Pro를 지능 부문 215개 중 4위로 표시하고, 비슷한 가격대 모델의 중앙값을 27로 제시해요. 비공개로 분류된 모델은 '혼합 가격(입력·출력 3:1) 기준 같은 가격대' 모델과 비교되기 때문에, 순위는 전체 AI 모델 순위가 아니라 그 비교 집단 안에서의 위치예요. 점수 1~2점 차이는 평가 반복·채점 방식에 따라 흔들릴 수 있으니, 근소한 차이로 우열을 단정하지 않는 게 좋아요.
'파레토 라인'이란
해커뉴스에서는 이 모델이 Artificial Analysis 차트의 '파레토 라인'에 올랐다는 제목이 주목받았어요. 파레토 라인은 같은 비용으로 더 높은 점수를 내는 모델이 없는 경계선을 뜻해요. 이 선 위에 있으면 비용 대비 점수 효율이 좋은 편이라는 의미지만, 차트의 비용은 '지수 과제 한 개를 푸는 데 든 평균 비용'이에요. 실제 내 업무의 입력 길이·출력 길이·캐시 적중률이 다르면 결과도 달라져요. 참고로 파레토 배치 여부는 이번에 확인한 페이지 본문에 문장으로 적혀 있지 않고 차트로만 표시돼요.
가격·속도·토큰 사용량 비교
성능 점수만큼 중요한 것이 실제 비용과 응답 시간이에요. 아래 수치는 Artificial Analysis가 Kimi 자체 API를 측정한 값과 Kimi API 플랫폼 공개 가격을 2026년 10월 24일 기준으로 모은 거예요.
지능 지수
- Kimi K3.1 Pro
- 55
- 비교 기준
- 비슷한 가격대 중앙값 27
입력 가격(100만 토큰)
- Kimi K3.1 Pro
- 2.00달러
- 비교 기준
- 중앙값 2.00달러
출력 가격(100만 토큰)
- Kimi K3.1 Pro
- 10.00달러
- 비교 기준
- 중앙값 10.00달러
캐시 적중 가격
- Kimi K3.1 Pro
- 0.20달러(90% 할인)
- 비교 기준
- 입력 정가 대비
지수 과제당 평균 비용
- Kimi K3.1 Pro
- 2.11달러
- 비교 기준
- 113개 중 85위
출력 속도
- Kimi K3.1 Pro
- 초당 77.1토큰
- 비교 기준
- 중앙값 81토큰
첫 토큰까지 시간
- Kimi K3.1 Pro
- 3.08초
- 비교 기준
- 중앙값 3.54초
지수 평가 출력 토큰
- Kimi K3.1 Pro
- 1억 5천만
- 비교 기준
- 중앙값 8,700만
표에서 눈여겨볼 부분은 토큰 사용량이에요. 단가는 중앙값과 같지만, 같은 시험을 푸는 데 출력 토큰을 중앙값의 약 1.7배 썼어요. 생각 과정이 항상 켜져 있는 모델이라 답을 내기 전 추론 토큰이 많이 쌓이고, 그만큼 비용과 대기 시간이 늘어요. 그래서 과제당 비용 순위는 단가만 보고 예상한 것보다 뒤쪽이에요.
고속 버전과 캐시 요금
Kimi K3.1 Pro Highspeed(kimi-k3.1-pro-highspeed)는 100만 토큰당 입력 4달러, 출력 20달러로 일반 버전의 두 배예요. 응답 속도가 중요한 챗봇·코딩 보조라면 고려할 만하지만, 긴 배치 작업에는 일반 버전이 유리할 수 있어요. 캐시는 반복되는 앞부분(시스템 프롬프트·참고 문서)에 자동 적용되고, TTL은 기본 5분과 1시간 두 가지예요. 요청 간격이 5분을 넘으면 1시간 TTL을 지정해야 캐시를 다시 쓰는 비용을 줄일 수 있어요. 가격은 세금 별도예요.
문샷 AI 자체 벤치마크, 어떻게 볼까
공식 블로그는 Terminal-Bench 4.0에서 Kimi K3.1 Pro가 65.7%로 GPT-6 Astra(58.2%)보다 높고 Claude Opus 5.5(66.4%)보다 약간 낮다고 밝혔어요. 3D 재구성 평가 BenchCAD에서는 도구 사용 시 92.7%, 금융 문서 분석 OfficeQA Pro v2에서는 64.4로 최고 기록이라고 소개했어요. 다만 이런 수치를 읽을 때는 몇 가지를 확인해야 해요.
- 자체 측정과 인용이 섞여 있어요. Kimi 결과는 Claude Code 하네스로 직접 측정했고, 다른 모델 점수는 각 사 보고서나 리더보드에서 가져온 경우가 많아요.
- 최대 추론 설정 기준이에요. 별도 표기가 없으면 reasoning effort를 max로 둔 결과라, low로 낮추면 점수와 비용이 모두 달라질 수 있어요.
- 내부 벤치마크가 포함돼요. Kimi Code Bench, 내부 금융 벤치마크, 환각 벤치마크는 외부에서 재현하기 어려워요.
- 환각 수치가 문서마다 달라요. 블로그는 K3의 23.4%에서 8.3%로, API 문서는 23.35%에서 6.85%로 줄었다고 적었어요. 평가 구성 설명도 서로 달라 같은 시험으로 보기 어렵고, 문샷 스스로도 일상 사용의 전체 오류율이 아니라고 밝혔어요.
독립 평가인 Artificial Analysis 지수에도 Terminal-Bench 4.0이 포함되지만, 지수는 여러 평가를 합친 값이라 회사가 강조한 개별 점수와 일대일로 비교되지 않아요. 순위표를 볼 때는 같은 평가·같은 설정으로 잰 점수끼리만 비교하는 것이 기본이에요.
쓰기 전 확인할 점 체크리스트
- 1
내 과제로 짧게 테스트해요
지수는 영어·텍스트 중심이에요. 한국어 문서 요약, 사내 코드베이스 수정처럼 실제로 맡길 과제 10~20개를 골라 기존 모델과 같은 조건에서 비교해 보세요.
- 2
토큰 사용량으로 비용을 다시 계산해요
단가가 같아도 추론 토큰이 많으면 청구액이 커져요. 시험 호출의 usage 값으로 입력·출력·캐시 토큰을 확인하고, 필요하면 reasoning_effort를 low나 high로 낮춰 품질과 비용을 비교하세요.
- 3
API 접근 조건을 확인해요
Kimi API에서 이 모델은 최소 1달러 충전 후 열리고, 누적 충전액에 따라 동시 요청 수·분당 요청·토큰 한도가 정해져요. temperature·top_p 같은 값은 고정이라 요청에서 빼야 하고, 이미지는 공개 URL이 아닌 base64나 업로드 파일 ID로 보내야 해요.
- 4
데이터 정책과 관할을 검토해요
API 고객용 제로 데이터 보존 옵션이 안내돼 있지만 적용 조건은 계약에서 확인해야 해요. 개인정보·영업비밀을 다룬다면 국외 이전과 사내 보안 규정을 먼저 점검하세요. 지역별 이용 제한은 이번에 읽은 공식 문서에서 확인되지 않았어요.
- 5
기존 Kimi 모델 이용자는 일정을 챙겨요
Kimi API는 2026년 10월 31일부터 신규 가입자에게 K2 시리즈를 제공하지 않고, 2026년 12월 말까지 K2 시리즈를 모두 종료할 계획이라고 공지했어요. K2를 쓰고 있다면 이전 계획이 필요해요.
웹 검색 도구는 아직 업데이트 중이라 공식 문서가 '당분간 운영 환경에는 권장하지 않는다'고 적었어요. 검색 기반 에이전트를 만든다면 별도 검색 도구를 붙이는 쪽이 안전해요.
AI 모델 출시 소식은 하루에도 여러 건 쏟아지고, 커뮤니티 반응이 공식 발표보다 먼저 퍼지기도 해요. 새 모델 관련 이야기가 어디서 얼마나 언급되는지는 더따리 텔레그램 AI 트렌드에서, 블로그 쪽 반응은 블로그 트렌드에서 함께 살펴볼 수 있어요.

정리하면 Kimi K3.1 Pro는 독립 지수 55점으로 같은 가격대에서 성능이 돋보이는 모델이지만, 느린 출력 속도와 많은 추론 토큰 때문에 체감 비용은 단가보다 커질 수 있어요. 가중치 공개 시점과 라이선스, 데이터 보존 조건이 아직 확정 단계라는 점까지 확인한 뒤 내 과제로 직접 비교해 보는 것이 가장 확실한 판단 방법이에요.