세레브라스 1조 파라미터 모델 서빙법: 웨이퍼 스케일 칩 vs GPU 추론
세레브라스가 44GB 웨이퍼 59장에 3조 파라미터 모델을 나눠 올리는 계산, 파이프라인 처리 방식, HBM을 쓰는 GPU 추론과의 차이와 확인할 점을 정리했어요.
목차7개 섹션
핵심 요약
- 세레브라스는 모델 가중치를 칩 위 SRAM에 올려 두고, 웨이퍼 여러 장을 조립 라인처럼 이어 층(layer) 단위로 나눠 실행해요.
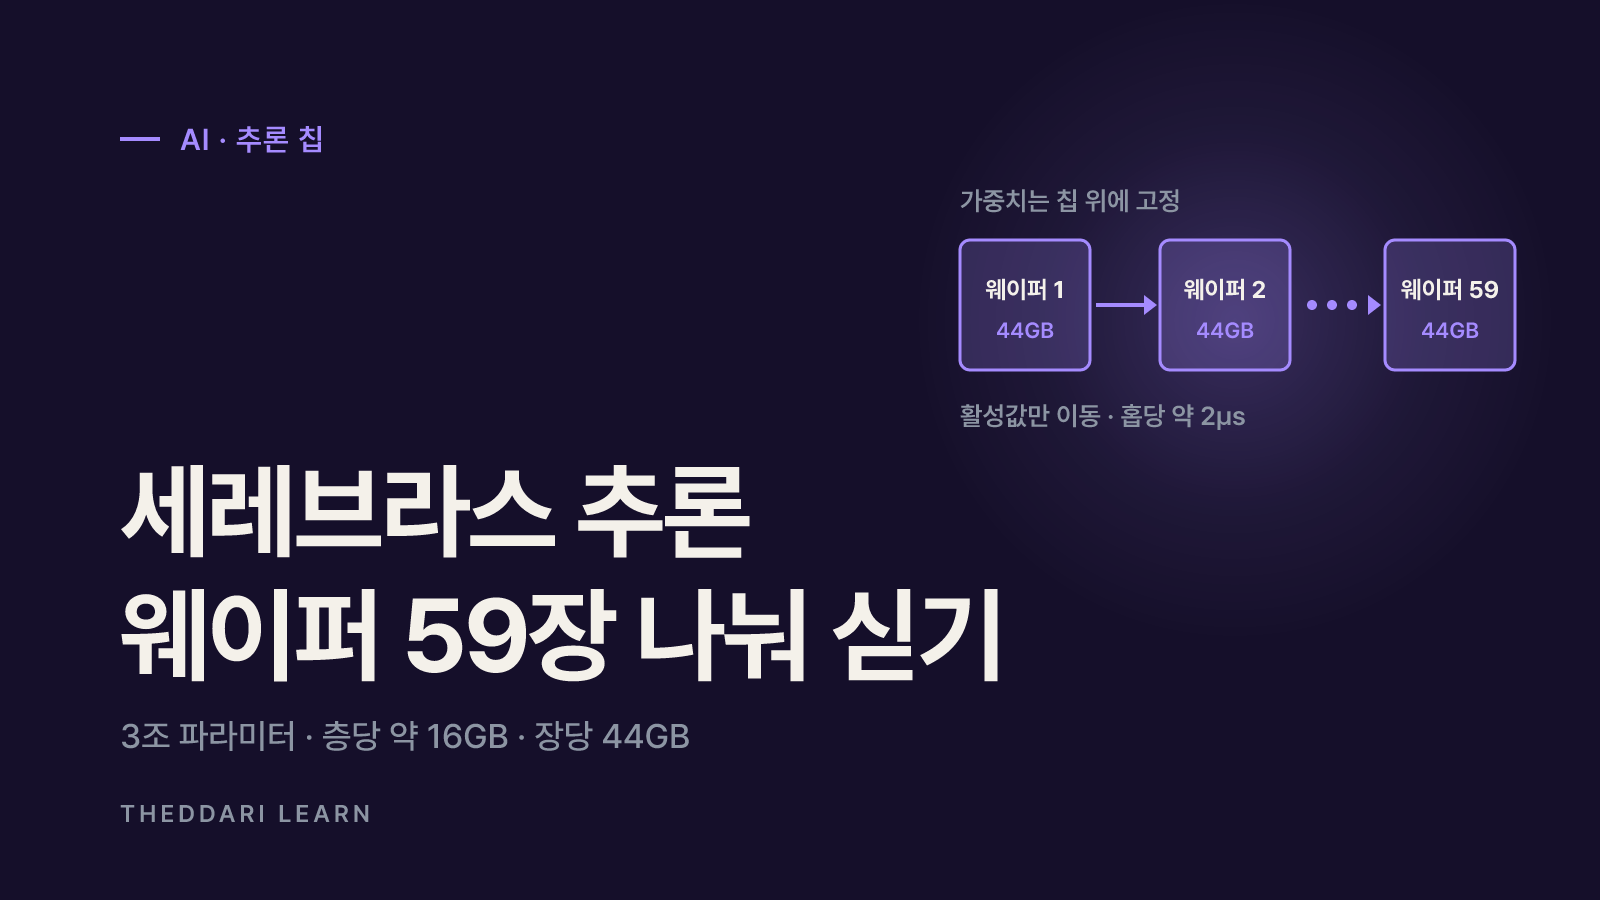
- 공식 예시에서 3조 파라미터 Kimi K3(4비트 가중치)는 층당 약 16GB이고, 44GB 웨이퍼 59장에 배치돼요.
- 웨이퍼 사이에는 가중치가 아니라 중간 계산값(활성값)만 이동하며, 한 번 건너는 데 약 2마이크로초가 걸린다고 해요.
- GPU는 칩 옆 HBM(B300 기준 288GB)에 가중치를 두고 여러 GPU로 나눠 처리하는 방식이라, 메모리 위치와 병렬화 방식이 달라요.
- 'GPU보다 최대 30배 빠르다'는 수치는 회사 발표이며 모델·설정·측정 시점에 따라 달라질 수 있어요.
세레브라스는 1조 파라미터가 넘는 모델을 칩 한 장에 넣지 않아요. 모델을 층(layer) 단위로 쪼개 웨이퍼 크기의 칩 여러 장에 나눠 싣고, 칩 위 메모리(SRAM)에 가중치를 고정해 둔 채 중간 계산값만 다음 칩으로 넘기는 파이프라인 방식으로 서빙해요. 2026년 10월 기준 세레브라스가 공식 블로그에 공개한 예시에서는 약 3조 파라미터 오픈 모델 Kimi K3를 WSE-3T 웨이퍼 59장에 배치해요. 이 글은 그 계산을 따라가며, 칩 옆 HBM 메모리에 가중치를 두는 GPU 추론과 무엇이 다른지, 사용자와 개발자가 무엇을 확인해야 하는지 정리해요.
세레브라스 웨이퍼 스케일 칩이란?
보통 반도체는 둥근 실리콘 웨이퍼 한 장에서 작은 칩 수십~수백 개를 잘라 만들어요. 세레브라스는 이 웨이퍼를 자르지 않고 웨이퍼 전체를 칩 하나로 써요. 세레브라스 칩 소개 페이지에 따르면 현재 세대인 WSE-3 Turbo(WSE-3T)는 면적 46,225mm², 트랜지스터 4조 개, AI 코어 90만 개, AI 연산 250페타플롭스를 내세워요.
추론에서 더 중요한 숫자는 메모리예요. WSE-3T 한 장에는 칩 위 SRAM 44GB가 있어요. SRAM은 연산 코어 바로 옆에 붙어 있어 데이터를 매우 빠르게 읽을 수 있지만, 용량은 GPU가 쓰는 HBM보다 작아요. 그래서 거대 모델은 반드시 여러 장으로 나눠야 해요.
- 웨이퍼 스케일: 웨이퍼 한 장 전체가 하나의 프로세서예요. 결함은 여분 코어와 우회 배선으로 피한다고 회사는 설명해요.
- 칩 위 메모리: 가중치를 칩 안 SRAM에 두기 때문에 토큰을 만들 때마다 칩 밖 메모리에서 가중치를 읽어 오지 않아도 돼요.
- 시스템 단위: 2026년 8월 공개된 CS-4 랙 시스템에는 WSE-3T가 3장 들어가요.
3조 파라미터 모델을 웨이퍼 59장에 나누는 계산
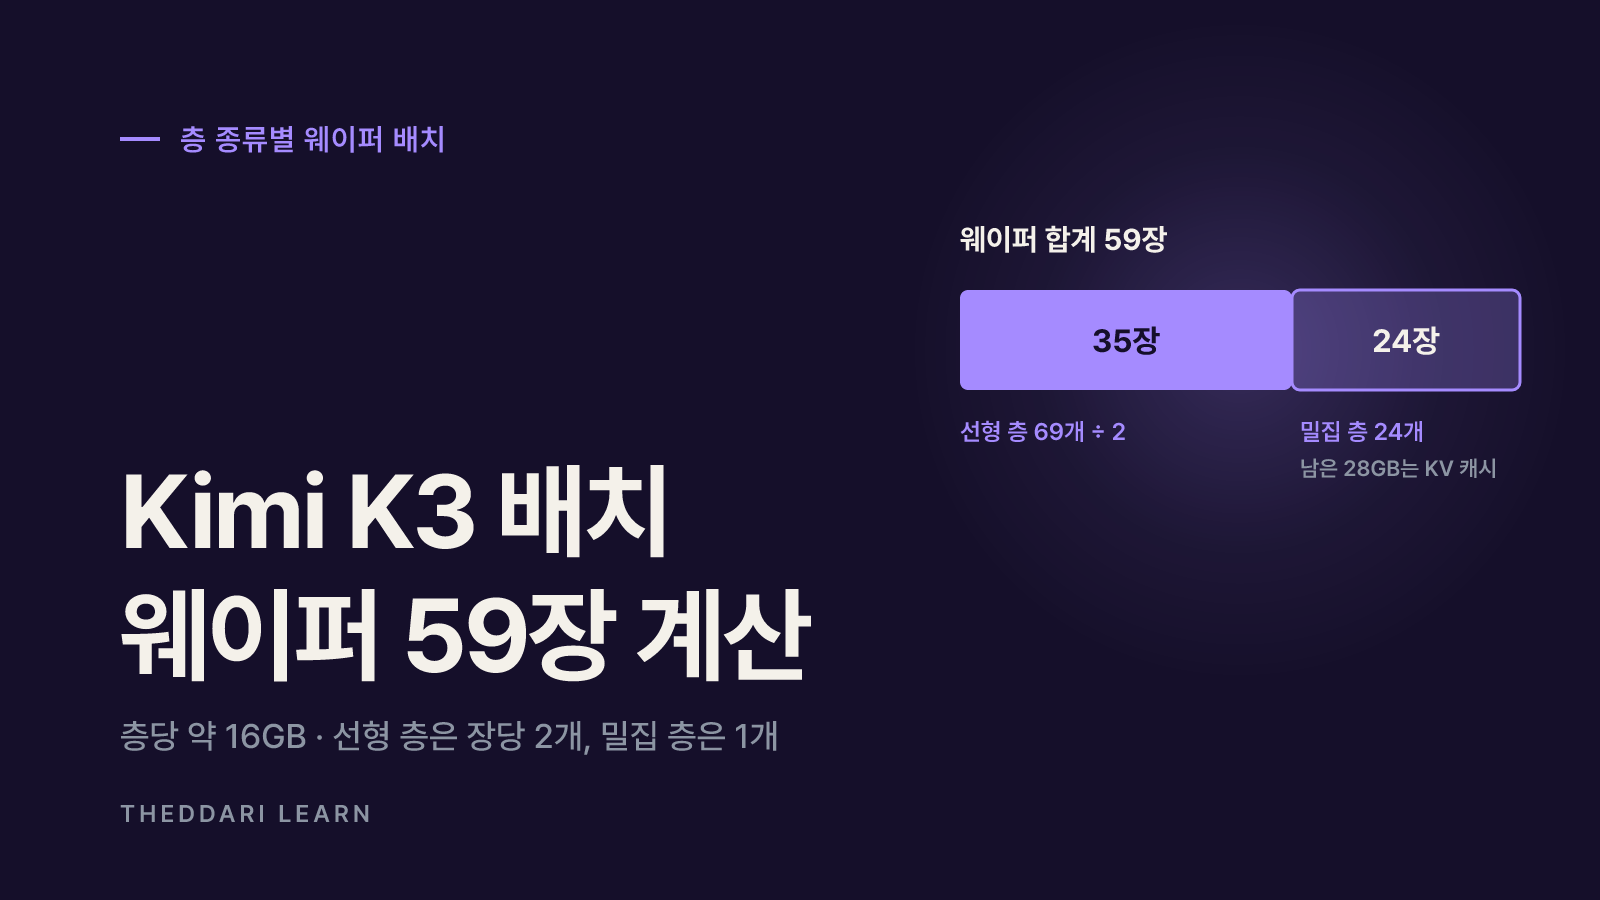
세레브라스 블로그는 Kimi K3를 예시로 들어요. Kimi K3는 약 3조 파라미터, 층 93개(선형 어텐션 층 69개 + 일반 어텐션인 밀집(dense) 층 24개)로 이루어진 오픈 모델이에요. 계산 전제는 가중치 4비트 양자화, KV 캐시 8비트, 평균 요청 길이 256k 토큰이에요.
- 1
1. 층 하나의 크기 구하기
3조 개 파라미터를 4비트(0.5바이트)로 저장하면 가중치는 약 1.5TB예요. 이를 93개 층으로 나누면 층 하나가 약 16GB가 돼요.
- 2
2. 층 종류별로 웨이퍼에 배치하기
밀집 층은 요청마다 모든 토큰의 키·값(KV 캐시)을 저장해야 해서 웨이퍼 한 장에 하나만 올리고 남은 SRAM을 KV 캐시에 써요. 선형 어텐션 층은 요청당 크기가 고정된 작은 상태만 유지하므로 한 장에 두 개(16GB × 2 = 32GB)를 올려요.
- 3
3. 필요한 웨이퍼 수 더하기
선형 층 69개를 2개씩 올리면 35장, 밀집 층 24개는 24장이 필요해 합계 59장이에요.
- 4
4. 웨이퍼 연결하기
웨이퍼 사이에는 가중치가 아니라 활성값(중간 계산 결과)만 이더넷 기반 RDMA로 전달돼요. 한 번 건너는 데 약 2마이크로초가 걸린다고 해요.
핵심은 층 하나(약 16GB)가 웨이퍼 한 장(44GB)보다 작다는 점이에요. 그래서 대부분 층을 웨이퍼 사이에 쪼개지 않고 통째로 올릴 수 있고, 가중치는 처음 배치한 자리에서 움직이지 않아요. 밀집 층 웨이퍼에는 44GB에서 층 하나 16GB를 뺀 약 28GB가 KV 캐시용으로 남아요.
이 59장은 세레브라스가 제시한 설명용 계산이에요. 블로그는 실제 운영에서는 이보다 훨씬 잘게 나눈 단계를 더 많이 쓴다고 밝혔어요. 요청 길이·양자화 방식이 바뀌면 필요한 장수도 달라져요.
요청 여러 개를 동시에 처리하는 파이프라인
웨이퍼를 조립 라인의 작업대로 생각하면 쉬워요. 웨이퍼 1이 1~2번 층을 계산해 결과를 웨이퍼 2로 넘기고, 웨이퍼 2가 3~4번 층을 계산해 다음으로 넘기는 식으로 마지막 웨이퍼가 다음 토큰을 만들어요.
그렇다면 한 요청이 지나가는 동안 다른 웨이퍼는 놀고 있을까요? 세레브라스 설명은 '아니요'예요. 라인에 서로 다른 요청을 계속 흘려보내, 3단계가 요청 A를 처리하는 동안 2단계는 요청 B를, 1단계는 요청 C를 처리해요. 각 단계는 요청 몇 개를 묶은 마이크로 배치도 처리할 수 있어서, 동시에 처리 중인 요청 수는 대략 '단계 수 × 마이크로 배치 크기'가 돼요.
마이크로 배치 크기
- 작게 하면
- 요청 하나의 응답이 더 빨라짐
- 크게 하면
- 전체 처리량이 늘어남
KV 캐시용 SRAM
- 작게 하면
- 동시 요청 수 상한이 낮아짐
- 크게 하면
- 긴 문맥·동시 요청을 더 받음
파이프라인 단계 수
- 작게 하면
- 단계별 부담이 커짐
- 크게 하면
- 동시에 흐르는 요청이 늘어남
동시 요청의 상한을 정하는 것은 결국 KV 캐시를 담을 칩 위 메모리예요. 처리 중인 요청마다 밀집 층 웨이퍼마다 자기 KV 캐시가 필요하기 때문이에요. 세레브라스는 동시 요청 수나 배치 크기만으로 효율을 판단하지 말고, 같은 출력 속도에서 1메가와트당 초당 토큰 수를 보라고 제안해요.
GPU 추론과 무엇이 다를까
GPU도 거대 모델을 여러 장에 나눠 서빙하지만 메모리 구조가 달라요. 엔비디아 기술 블로그에 따르면 Blackwell Ultra(B300) GPU는 HBM3E 288GB, 메모리 대역폭 8TB/s, GPU 간 NVLink 1.8TB/s를 제공하며 3,000억 개 이상 파라미터 모델을 오프로딩 없이 담을 수 있어요. 72개 GPU를 묶은 GB300 NVL72 랙은 NVLink로 하나의 도메인을 이뤄요.
가중치 위치
- 세레브라스 WSE-3T
- 칩 위 SRAM(장당 44GB)
- 엔비디아 B300 GPU
- 칩 옆 HBM3E(장당 최대 288GB)
1.5TB 가중치를 담으려면
- 세레브라스 WSE-3T
- 층 단위로 여러 웨이퍼에 분산(예시 59장)
- 엔비디아 B300 GPU
- 단순 용량 계산으로 최소 6장 이상, 실제로는 KV 캐시 몫 추가
나누는 방식
- 세레브라스 WSE-3T
- 층을 단계로 나눈 파이프라인 중심
- 엔비디아 B300 GPU
- 텐서·전문가·파이프라인 병렬을 조합
칩 사이 이동
- 세레브라스 WSE-3T
- 활성값만, 홉당 약 2μs(회사 설명)
- 엔비디아 B300 GPU
- NVLink·네트워크로 활성값·중간값 교환
강점
- 세레브라스 WSE-3T
- 토큰 생성(디코드) 속도
- 엔비디아 B300 GPU
- 넓은 소프트웨어 생태계, 학습·범용 연산
토큰을 하나 만들 때마다 모델 가중치를 메모리에서 읽어야 하므로, 대화형 추론 속도는 연산량보다 메모리에서 얼마나 빨리 읽느냐에 크게 좌우돼요. 세레브라스는 가중치를 연산 코어 옆 SRAM에 두어 이 병목을 줄이는 쪽을 택했고, GPU는 큰 HBM과 배치 처리로 처리량을 끌어올리는 쪽에 강해요. 표의 'GPU 최소 6장'은 1.5TB를 288GB로 나눈 단순 계산이며 실제 배치 구성은 서비스마다 달라요.
속도 비교 수치는 조심해서 읽어야 해요. 세레브라스는 CS-4가 GPU 시스템보다 최대 30배 빠르다고 발표했지만, 이는 2026년 8월 Artificial Analysis와 내부 벤치마크를 근거로 한 회사 주장이에요. 10조 파라미터 이상 모델에서 초당 1,000토큰 이상이라는 수치도 내부 벤치마크를 외삽한 값이라고 명시돼 있어요. 회사 사이트도 결과가 워크로드·설정·날짜·모델에 따라 달라질 수 있다고 적어 두었어요.
사용자와 개발자가 확인할 점
사용자가 체감하는 차이는 주로 답이 흘러나오는 속도예요. 세레브라스는 이 방식으로 수조 파라미터 모델을 초당 1,000~2,000토큰 이상으로 돌린다고 밝혔어요. 긴 코드를 생성하거나 에이전트가 여러 단계를 연달아 실행할 때 기다리는 시간이 줄어드는 효과가 커요. 다만 첫 토큰이 나오기까지의 시간(프리필)은 프롬프트 길이에 따라 별도로 늘어날 수 있어요.
- 지원 모델 확인: 원하는 모델이 세레브라스 클라우드에서 제공되는지, 양자화 수준(예: 4비트)이 품질에 영향을 주는지 확인해요.
- 속도 지표 구분: 초당 출력 토큰, 첫 토큰 지연, 동시 사용 시 속도를 따로 봐요. 한 숫자만으로 비교하지 않아요.
- 비용 조건: 토큰당 요금, 속도 제한, 문맥 길이 한도를 공식 가격 페이지에서 확인해요.
- 분리형 구성 이해: CS-4는 프리필을 GPU·다른 가속기에 맡기고 디코드만 담당하는 구성도 지원하므로, 서비스가 어떤 구성인지에 따라 체감이 달라요.
AI 반도체 경쟁 소식을 꾸준히 따라가려면 더따리 AI 텔레그램 트렌드에서 칩·모델 발표 흐름을 보고, 엔비디아 같은 관련 기업의 실적 발표 일정은 실적 캘린더에서 확인할 수 있어요.

정리하면, 세레브라스의 1조 파라미터 서빙은 '큰 칩 한 장'이 아니라 '칩 위 메모리에 가중치를 고정한 웨이퍼 여러 장의 파이프라인'이에요. GPU와의 차이는 가중치가 어디에 있고 무엇이 칩 사이를 오가느냐에 있으며, 속도 수치는 회사 측정 조건을 함께 확인해야 공정하게 비교할 수 있어요.