Artificial Analysis Intelligence Index v5란? 변경점과 순위 읽는 법
Intelligence Index v5는 9개 평가를 4개 분야 25%씩 묶은 AI 모델 종합 점수예요. 추가·제거된 벤치마크, 가중치, 이전 점수와 비교하면 안 되는 이유를 정리했어요.
목차8개 섹션
핵심 요약
- Intelligence Index v5는 9개 평가를 지식 업무·코딩·과학·일반 4개 분야에 25%씩 배분한 종합 점수예요.
- FrontierCode 2.0·Terminal-Bench-Science가 새로 들어오고 GDPval-AA v2.1·SciCode·AA-LCR v1.1은 지수에서 빠졌어요.
- 가중치의 60%가 비공개 테스트셋 또는 정답 비공개 평가라서 데이터 오염 영향을 줄이려는 방향이에요.
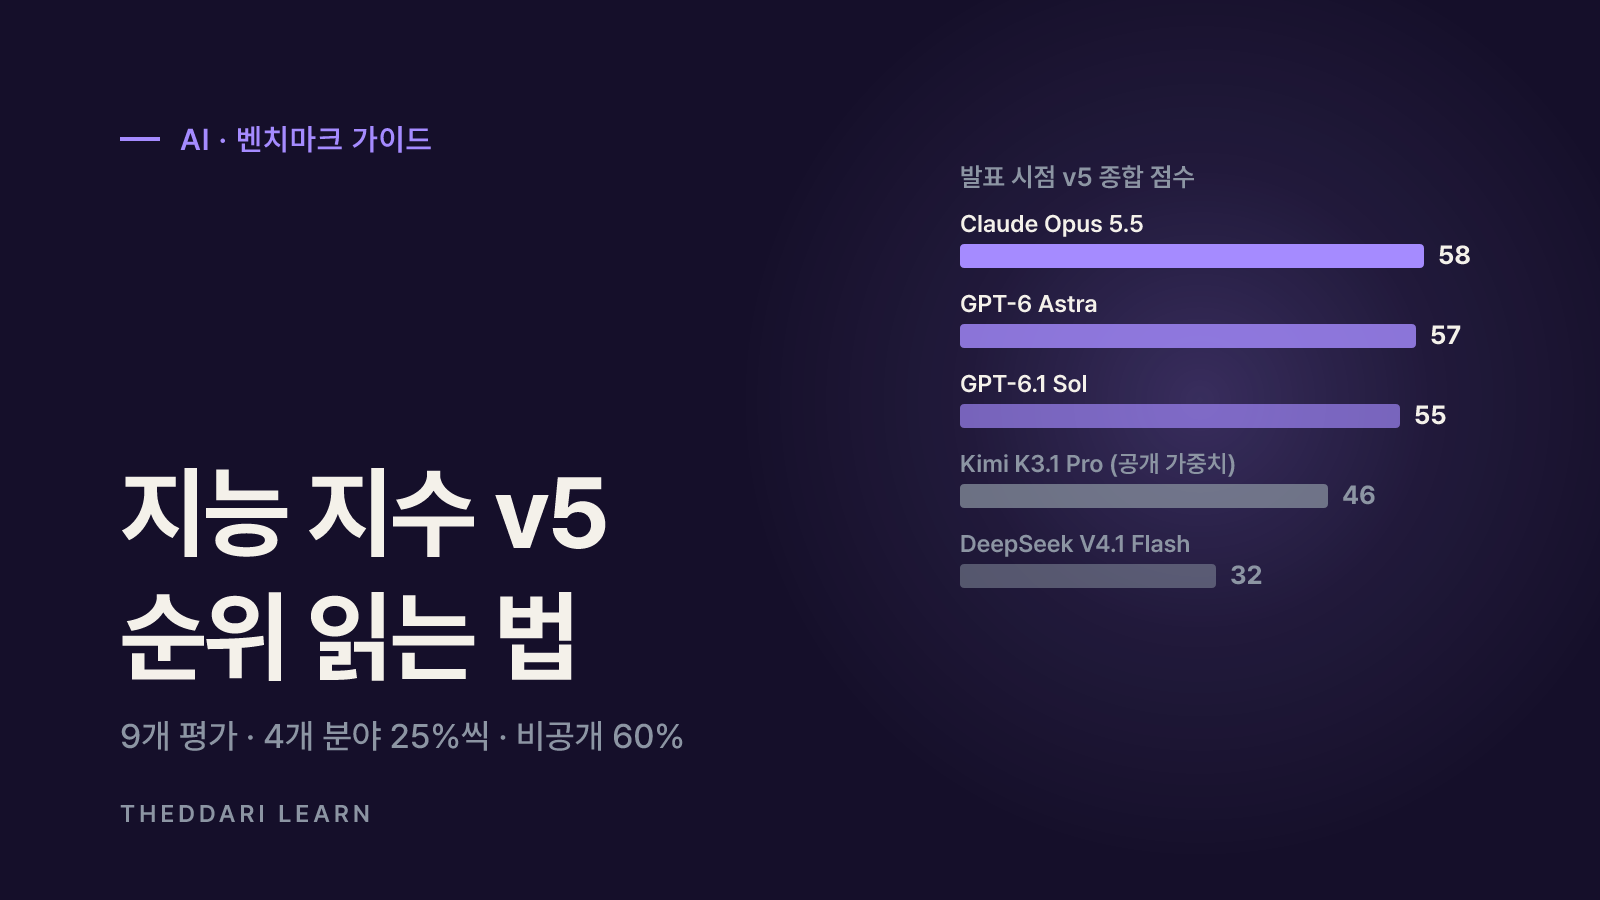
- 발표 시점 1위는 Claude Opus 5.5(max) 58점, 공개 가중치 모델과의 격차는 v4.3의 3점에서 12점으로 벌어졌어요.
- v5 점수는 v4 점수와 같은 눈금이 아니므로 숫자를 직접 비교하지 말고 같은 버전 안에서 순위·비용·노력 설정을 함께 봐야 해요.
Intelligence Index v5는 Artificial Analysis가 2026년 10월 27일 공개한 AI 언어 모델 종합 점수의 새 버전이에요. 9개 평가를 지식 업무·코딩·과학·일반 4개 분야에 25%씩 나눠 가중 평균하고, 처음으로 가중치의 60%를 비공개 테스트셋 또는 정답이 공개되지 않은 평가로 채웠어요. 그래서 v5 점수는 이전 v4 점수와 같은 눈금이 아니며, 순위표를 볼 때는 같은 버전 안에서 분야별 점수·추론 노력 설정·작업당 비용을 함께 봐야 해요. 이 글은 2026년 10월 기준 발표 원문과 방법론 문서를 바탕으로 정리했어요.
Intelligence Index v5란? AI 모델 비교 사이트의 종합 점수
Artificial Analysis는 AI 모델의 성능·가격·속도를 독립적으로 측정해 공개하는 AI 모델 비교 사이트예요. 그중 Intelligence Index는 여러 벤치마크 결과를 하나로 묶은 대표 지표로, 새 모델이 나올 때마다 기사·발표 자료에 "AA 점수 몇 점" 식으로 자주 인용돼요.
방법론 문서는 이 지수를 "언어 모델의 전반적 지능을 요약한 유용한 지표"라고 설명하면서도, 모든 지표처럼 한계가 있고 모든 용도에 그대로 적용되지는 않는다고 밝혀요. 또 지수는 주로 텍스트 기반의 영어 평가 묶음이며, 이미지 입력·음성 입력·다국어 성능은 별도로 측정한다고 적혀 있어요. 한국어 품질이 중요한 서비스라면 이 점수만으로 판단하면 안 되는 이유예요.
v5는 2026년 1월 v4 출시 이후 가장 큰 개편이에요. Artificial Analysis는 v5와 함께 Progress Index v1도 내놨는데, 2022년 11월 이후 출시된 언어 모델을 하나의 연속된 눈금에 올려 시간에 따른 능력 변화를 보여 주는 지표예요. 현재 모델끼리의 비교에는 Intelligence Index를, 몇 년 차이 나는 모델 간 비교에는 Progress Index를 쓰라는 것이 원문의 안내예요.
v5 구성 벤치마크와 가중치: 4개 분야 25%씩
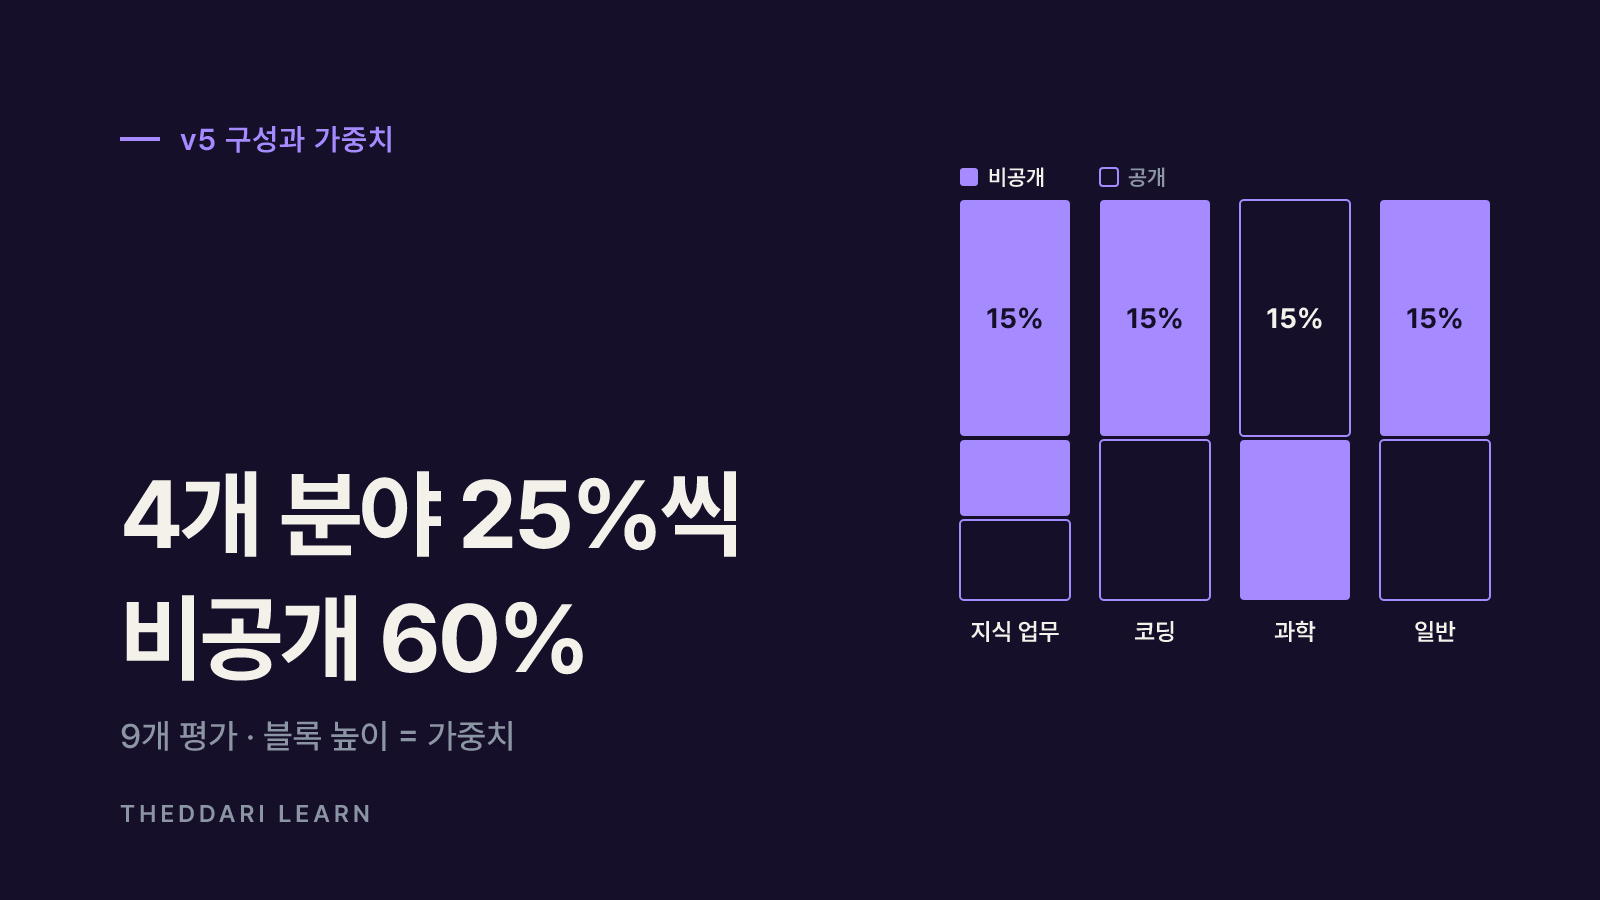
v5는 9개 평가로 구성되고, 4개 분야가 각각 25%를 차지해요. 분야 안에서는 평가마다 비중이 달라요. 아래 표는 방법론 문서의 가중치와 비공개 여부를 옮긴 것이에요.
지식 업무(25%)
- 평가
- AA-Briefcase v1.1
- 가중치
- 15%
- 무엇을 보나
- 수주짜리 업무 프로젝트를 파일 산출물로 완수
- 비공개
- 예
지식 업무(25%)
- 평가
- AutomationBench-AA
- 가중치
- 5%
- 무엇을 보나
- REST API로 SaaS 업무 자동화(657개 과제)
- 비공개
- 예
지식 업무(25%)
- 평가
- GDP.pdf
- 가중치
- 5%
- 무엇을 보나
- 긴 PDF 문서 근거 답변(100개 과제)
- 비공개
- 아니요
코딩(25%)
- 평가
- FrontierCode 2.0
- 가중치
- 15%
- 무엇을 보나
- 실제 오픈소스 저장소 변경이 병합될 수준인지(132개 과제)
- 비공개
- 예
코딩(25%)
- 평가
- Terminal-Bench 4.0
- 가중치
- 10%
- 무엇을 보나
- 터미널 작업 수행(66개 과제)
- 비공개
- 아니요
과학(25%)
- 평가
- Terminal-Bench-Science 0.1
- 가중치
- 15%
- 무엇을 보나
- 터미널 기반 과학 연구 워크플로(70개 과제)
- 비공개
- 아니요
과학(25%)
- 평가
- CritPt v2 하드 서브셋
- 가중치
- 10%
- 무엇을 보나
- 연구 수준 물리 문제 40개
- 비공개
- 예
일반(25%)
- 평가
- AA-Omniscience v1.1
- 가중치
- 15%
- 무엇을 보나
- 정확도 10% + 환각하지 않음 5%
- 비공개
- 예
일반(25%)
- 평가
- HLE-Diamond
- 가중치
- 10%
- 무엇을 보나
- 추론 500·지식 500 문항
- 비공개
- 아니요
비공개로 표시된 평가의 가중치를 더하면 15+5+15+10+15 = 60%예요. 발표 원문이 강조한 "지수의 60%가 비공개 테스트셋 또는 정답 비공개 평가"가 바로 이 부분이에요. 공개 문제는 학습 데이터에 섞여 들어가 점수가 부풀 위험(오염)이 있는데, 비공개 비중을 높여 이 위험을 줄이려는 설계예요.
에이전트형 평가 비중이 커졌어요
AA-Briefcase·FrontierCode 2.0·Terminal-Bench 4.0·Terminal-Bench-Science처럼 모델이 도구를 쓰며 여러 단계를 수행하는 평가가 가중치의 55%예요. 원문에 따르면 이 네 평가가 출력 토큰의 중앙값 약 90%를 차지했고, 작업당 출력 토큰 중앙값은 v4.3의 3만 5천 개에서 5만 9천 개로 늘었어요. 단답형 지식보다 "일을 끝까지 해내는 능력"을 더 많이 반영한다는 뜻이에요.
v4에서 무엇이 바뀌었나: 추가·업그레이드·제거
발표 원문은 v5의 변경을 새 평가 2개와 업그레이드 3개로 요약해요. 무엇이 들어오고 빠졌는지 알아야 특정 모델 점수가 왜 크게 오르거나 내려갔는지 해석할 수 있어요.
- 새로 추가
- FrontierCode 2.0: Cognition이 공개한 비공개 코딩 벤치마크로, 저장소 관리자가 에이전트의 변경을 병합할지를 기준으로 채점해요. 필수 검사 하나라도 실패하면 0점이에요.
- Terminal-Bench-Science: 터미널 환경에서 수행하는 과학 연구 과제 70개예요. 과제의 모든 테스트를 통과해야 성공으로 쳐요.
- 업그레이드
- HLE-Diamond: Humanity's Last Exam을 대체하는 정제판 1,000문항으로 추론·지식이 절반씩이에요.
- AA-Omniscience v1.1: 포화된 문항과 공개 세트 문항을 빼고 새 문항을 넣었으며 모호하거나 틀린 문항을 고쳤어요.
- CritPt v2: 원저자가 개정한 버전의 비공개 하드 서브셋 40문항을 코드 실행 도구와 함께 풀게 해요.
- 유지: AA-Briefcase, AutomationBench-AA, GDP.pdf, Terminal-Bench 4.0
- 지수에서 제거: GDPval-AA v2.1, SciCode, AA-LCR v1.1 (제거된 평가 일부는 지수 밖 추가 평가로 계속 공개돼요)
평가 구성과 가중치가 달라졌기 때문에 "v4에서 60점이던 모델이 v5에서 50점이 됐다"는 것은 성능 하락이 아니에요. 문제 자체가 어려워지고 바뀐 결과예요. 버전이 다른 점수를 한 표에 섞은 비교 글은 걸러 읽어야 해요.
v5 AI 모델 순위 결과: 발표 시점 숫자
2026년 10월 27일 발표 기준 주요 결과는 다음과 같아요. 순위표는 새 모델 추가에 따라 계속 바뀌므로 최신 값은 Artificial Analysis 사이트에서 다시 확인해야 해요.
1위
- 모델(노력 설정)
- Claude Opus 5.5 (max)
- v5 점수
- 58
2위
- 모델(노력 설정)
- GPT-6 Astra (max)
- v5 점수
- 57
3위
- 모델(노력 설정)
- GPT-6.1 Sol (max)
- v5 점수
- 55
상위 5개 밖 첫 모델
- 모델(노력 설정)
- Gemini 4 Argon (high)
- v5 점수
- 50
공개 가중치 최고(가중치 미공개 상태)
- 모델(노력 설정)
- Kimi K3.1 Pro
- v5 점수
- 46
가중치 공개 모델 최고
- 모델(노력 설정)
- DeepSeek V4.1 Flash 1017 (max)·GLM-5.3 (max)
- v5 점수
- 32
참고
- 모델(노력 설정)
- Claude Haiku 5.5 (max)
- v5 점수
- 36
- 상위 5개 모델은 모두 Anthropic과 OpenAI 모델이에요.
- 공개 가중치 모델과 1위의 격차는 v4.3의 3점에서 v5의 12점으로 벌어졌어요. 격차는 HLE-Diamond와 Terminal-Bench-Science에서 가장 컸어요.
- 9개 평가를 모두 1위 한 모델은 없어요. Claude Opus 5.5가 FrontierCode 2.0(46%)·HLE-Diamond(68%)·AA-Omniscience v1.1에서 1위였고, GPT-6 Astra는 Terminal-Bench-Science(63%)와 CritPt v2 하드 서브셋(72%), Kimi K3.1 Pro는 Terminal-Bench 4.0(67%), Gemini 4 Argon은 AutomationBench-AA(78%)에서 1위였어요.
새 모델 출시 소식과 커뮤니티 반응은 더따리 AI 텔레그램 트렌드에서 모아 볼 수 있어요. 순위표 숫자가 화제가 될 때 어떤 맥락에서 인용되는지 함께 보면 과장된 해석을 걸러 내기 쉬워요.
AI 모델 순위표 읽는 법: 5가지 확인 순서
- 1
버전부터 확인
인용된 점수가 v5인지 v4.x인지 봐요. 버전이 다르면 숫자를 나란히 놓지 않아요. 시간에 따른 변화는 Progress Index로 봐요.
- 2
괄호 속 노력 설정 확인
v5에서는 노력 설정의 영향이 커졌어요. Claude Opus 5.5는 low 35점, max 58점이었고, Claude Sonnet 5.5의 low~max 폭은 v4.3의 20점에서 29점으로, GPT-6.1 Sol은 10점에서 20점으로 넓어졌어요. 같은 모델 이름이라도 설정이 다르면 다른 모델처럼 봐야 해요.
- 3
작업당 비용과 함께 보기
점수 상위 10개 모델의 작업당 비용은 GPT-6.1 Terra(max) $0.96부터 Claude Fable 5.1(max) $13.04까지 13배 넘게 차이 났어요. GPT-6.1 Sol(max)은 Claude Opus 5.5(max)와 4점 이내이면서 작업당 비용은 $1.27로 약 8분의 1이었어요.
- 4
내 용도에 맞는 분야 점수 보기
코딩 도구를 고른다면 FrontierCode 2.0·Terminal-Bench 4.0, 문서 분석이면 GDP.pdf·AA-Briefcase, 사실 정확도가 중요하면 AA-Omniscience의 환각률을 따로 봐요. 종합 1위가 내 업무에서 1위라는 보장은 없어요.
- 5
작은 차이는 동률로 보기
1~2점 차이는 분야별 결과에서 쉽게 뒤집혀요. 그 정도 차이라면 가격·속도·컨텍스트 길이·API 정책 같은 다른 조건이 선택을 좌우하는 경우가 많아요.
한계와 주의할 점
- 영어 중심: 지수는 주로 영어 텍스트 평가예요. 한국어 성능은 별도의 Multilingual Index를 봐야 해요.
- 한 기관의 측정: Artificial Analysis가 정한 하네스(Stirrup, mini-swe-agent)와 설정으로 돌린 결과예요. 같은 벤치마크라도 다른 기관 결과와 숫자가 다를 수 있으며, 방법론 문서도 GDP.pdf는 원 제작사 Surge AI 점수와 직접 비교할 수 없다고 밝혀요.
- LLM 채점 포함: 일부 평가는 다른 AI 모델이 채점자 역할을 해요. 채점 모델의 성향이 결과에 섞일 수 있어 여러 심사 모델을 쓰는 방식으로 보완하고 있어요.
- 비공개 데이터의 양면: 비공개 문항은 오염을 줄이지만 외부에서 문제를 검증하기 어렵다는 한계도 있어요.
- 발표 시점 스냅샷: 모델과 점수는 계속 추가·갱신돼요. 기사에 인용된 숫자는 날짜를 함께 확인해요.
AI 모델 관련 블로그·뉴스 흐름은 더따리 블로그 트렌드 대시보드에서도 확인할 수 있어요. 정리하면, Intelligence Index v5는 에이전트형 작업과 비공개 데이터 비중을 높인 새 눈금이에요. 순위표를 볼 때는 버전 → 노력 설정 → 비용 → 분야별 점수 순서로 확인하고, 몇 점 차이로 우열을 단정하지 않는 것이 가장 안전한 읽기 방법이에요.
자주 묻는 질문
Intelligence Index v4 점수와 v5 점수를 비교해도 되나요?
점수가 1~2점 차이 나면 더 좋은 모델인가요?
한국어 성능도 Intelligence Index v5에 반영되나요?
(max)·(high) 같은 괄호 표시는 무슨 뜻인가요?
출처·참고 자료
- 1